
Cloud Intelligence™
Google CloudのメンテナンスでGPUを失わないために
GCPの予約で容量を確保
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。
AWS向けのこちらの記事の続編です


About Joshua Fox
Senior Cloud Architect II
Joshua Fox has been a software architect in innovative technology companies for 20 years. Now, he advises tech startups and growth companies on architecture and cost optimization for Google Cloud Platform and Amazon Web Services; also publishing articles, and speaking to cloud engineers.
He has a PhD from Harvard University and a BA in math from Brandeis.
My personal page世界的なGPU需要は天文学的な規模に達しています。Google Cloud Platform(GCP)でNVIDIA L4、A100、H100といったリソースを確保できれば、エンジニアリングチームにとって大きな成果と感じられるでしょう。しかし、基盤となるハードウェアのメンテナンスが発生したときや、定期的な作業のためにインスタンスを手動で停止したときに、その容量を失ってしまう可能性があります。
Google Cloudの定期メンテナンスイベントであれ、ドライバーの適用、イメージの入れ替え、インスタンススコープの変更のためにユーザーが行う停止であれ、VMを停止するとリソースは解放されます。その結果、GPUはパブリックプールに戻され、重要なML学習ジョブや推論ワークロードが立ち往生することになります。ここでは、GPUを確実に押さえ、インフラの更新を乗り切る方法をご紹介します。
問題:GCPにおけるGPUのメンテナンスモデル
GCPの優れた機能のひとつがライブマイグレーションです。インフラのメンテナンス時に、実行中のVMを正常なホストへ最小限の中断でシームレスに移動してくれます。しかし、GPUがアタッチされたVMではライブマイグレーションはサポートされていません。
GPUはPCIe経由でホストに物理的に接続されているため、GCPはGPUメモリの状態をネットワーク越しに移行できません。そのため、Compute EngineはGPUがアタッチされたVMに対してTERMINATEホストメンテナンスポリシー(onHostMaintenance)を適用します。
インスタンスをホストする物理ハードウェアにGoogleがパッチ適用や交換を行う必要が生じた場合、次のようになります。
- Compute Engineはスケジュールされたホストイベントを事前に通知します。通常は1時間前です(緊急メンテナンスでは猶予が短くなることがあります)。
- VMはACPIシャットダウンシグナルを受信し、強制的に停止されます。
- VMが
automaticRestart: true(デフォルト)で構成されている場合、GCPは別の正常なホスト上でVMの再起動を自動的に試みます。
ストレージに関する注意: ローカルSSDディスク上のデータは一時的なものであり、終了時、手動停止時、あるいはホストイベント後の復旧に失敗した際に失われる可能性があります。永続化が必要なデータはPersistent Disk、Hyperdisk、Cloud Storageに保存し、ローカルSSDはキャッシュや一時データのみに使用してください。
ユーザー起因のメンテナンスにおけるリスク
スケジュールされたホストイベント以外にも、日常的な管理作業の多くでは、単純な再起動ではなくVMの完全な停止・起動が必要になります。たとえば次のようなケースです。
- オフライン状態を必要とするNVIDIAドライバーやCUDAツールキットの更新
- コアとなるインスタンス属性の変更(サービスアカウントやアクセススコープの変更など)
- 新しいマシンイメージへの移行や、クラスタ全体でのローリングOSパッチ管理
標準の gcloud compute instances stop を実行すると、その瞬間にハードウェアは共有容量プールへと返却されます。
リスク:容量獲得は運任せ
GCPが停止したVMの再起動を試みるとき(または手動で起動するとき)、VMはゾーンのリソースプールに戻って新しいGPUを要求します。
GPUはほぼ恒常的に不足しているため、容量が確保できなければ、あとからの起動は失敗する可能性があります。再起動する代わりに、VMはZONE_RESOURCE_POOL_EXHAUSTED または ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILSエラーを返します。
VMは TERMINATED 状態のままになります。この時点でGPUは完全に失われており、容量が空くまでインスタンスの起動を繰り返し試みながら、他の全員と同じ列に並んで待つしかありません。プロジェクトの割り当て(quota)が十分にあっても助けにはなりません。割り当てがあることと、特定のゾーンに物理的な容量が存在することは別物だからです。割り当てはGoogleが課す上限であり、容量は他のユーザーが既存のリソースを保持しているかどうかに左右されます。
解決策:ハードウェアを完全一致させるゾーン予約
再起動時にGPUがパブリックプールへ返却されるのを防ぐ解決策が、Compute Engineの予約です。
GCPの予約は、容量に対する一定の保証を提供します。メンテナンスのためにVMが停止すると、物理ハードウェアに対する占有は手放されますが、容量予約が即座にその「空きスペース」を捕捉し、プロジェクトのために割り当てを確保し続けます。Compute EngineがVMを自動再起動するか、手動で再起動すれば、VMはそのまま専用の予約を消費します。
GCPの予約は非常に厳密です。
- ゾーン制限: 予約は特定のゾーン(例:us-central1-c)に紐づいており、より広いリージョン単位ではありません。
- 完全一致の要件: 予約を消費するには、VMが予約のパラメータと完全に一致している必要があります。マシンタイプ、GPUの種類と数、ローカルSSDなどのプロパティがすべて同一でなければなりません。
- OS要件なし: オペレーティングシステム(プラットフォーム)の一致を必須とするAWSの容量予約とは異なり、GCPではオペレーティングシステムやブートイメージの一致は不要です。予約を維持したままイメージを入れ替えられる柔軟性があります。
このシナリオにおいて、予約は既存のリソースを保持するために機能します。まだGPUを実行していない場合、予約の作成は失敗する可能性があります。リソースが利用可能になって初めて予約の作成が成功します。
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
重要な制限とエッジケース
予約は容量喪失に対する標準的な防御策ですが、GCP特有のアーキテクチャルールを考慮する必要があります。
- 予約できないGPU構成: 極端な供給制約のため、一部の新しいGPUや需要の高いGPU構成は、標準のオンデマンド容量予約では予約できません。たとえば、A4X Max、A3 Ultra、および8基未満のGPUを持つA3 High構成には現在制限があります。予約の可否は必ずGCPドキュメントで確認してください。
- Spot VMとCUD: 予約が保護するのは標準VMのワークロードです。Spot VMは予約を消費できず、設計上プリエンプトされる可能性があるため、保護の対象外です。
- CUD: 確約利用割引(CUD)は料金に影響しますが、それ自体が容量を予約するわけではありません。CUDはVMだけでなく、使用されていない予約に対しても課金される点に注意してください。
- GKE連携: Compute Engineの予約は、Google Kubernetes Engine(GKE)で使用するGPU容量の保護にも利用できます。GKE Standardでは、ノードプールに予約アフィニティを構成します。GKE Autopilotでは、予約を明示的に選択するか、サポートされているカスタムComputeClassを構成する必要があります。
ユーザーメンテナンスに向けたGPU予約の実装方法
構成のずれを防ぐ最も安全なアプローチは、インスタンステンプレートでVMを一度定義し、そのテンプレートから予約を作成することです。デフォルトでは、予約は**「自動的に消費」**に設定されています。予約の仕様と完全に一致するVMがプロジェクト内に作成されると、自動的にその予約が使用されます。
1. 予約を作成する
クラスタ全体でローリングメンテナンス(ノード単位のOSパッチ適用など)を行う場合、フリート全体分の容量を予約する必要はありません。同時に停止させる予定のインスタンス数に合わせて予約のサイズを設定してください。たとえば、一度に2ノードをドレインして更新するなら、--vm-count を2に設定すれば、停止・再起動するそれらのインスタンスを確実に捕捉できます。
完全一致を担保するために、コマンドラインを使用してインスタンステンプレートから予約をプロビジョニングできます。
gcloud compute reservations create gpu-maintenance-reservation \ --project=my-project-id \ --source-instance-template=projects/my-project-id/global/instanceTemplates/my-gpu-template \ --vm-count=1 \ --zone=us-central1-cあるいは、予約を直接定義することもできます。
gcloud compute reservations create reservation-v100 \ --project=joshua-playground \ --zone=us-east1-c \ --machine-type=n1-standard-1 \ --accelerator=count=1,type=nvidia-tesla-v100 \ --vm-count=1 \ --require-specific-reservation=falseもちろん、Google Cloud Consoleからも実行できます。
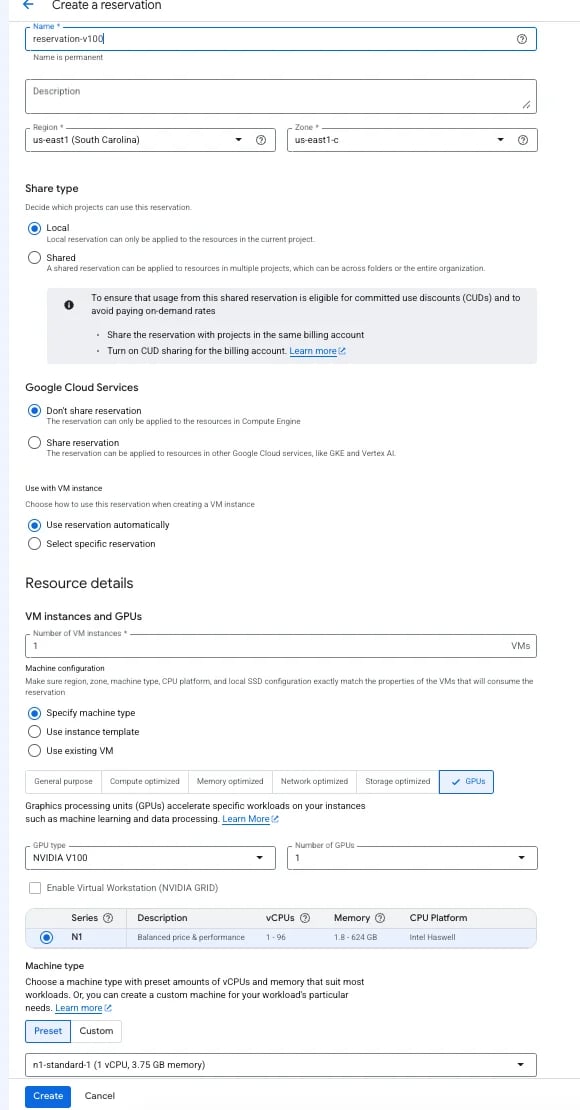
2. VMをデプロイして消費状況を確認する
--require-specific-reservation がfalseに設定されているため、VMのデプロイスクリプトを変更する必要はありません。同じゾーンで完全に一致するVMを起動すれば、GCPは自動的にそのVMを予約済み容量に割り当てます。
想定した数のインスタンスが予約枠を消費していることを確認するには、Google Cloud Consoleで予約の指標をチェックしてください。現在の予約は Compute Engine > 予約 で確認でき、過去の使用状況はGoogle Cloud Monitoringで指標 compute.googleapis.com/reservation/used および compute.googleapis.com/reservation/reserved を使って確認できます。
3. 予約をクリーンアップする
標準のVMとは異なり、容量予約は不要になった時点で明示的に削除する必要があります。ワークロードを完全に廃止してVMを削除しても、予約の削除を忘れると、空のGPU容量に対してオンデマンドの全額料金を払い続けることになります。さらにCUDも課金されます。
予約が不要になったら、コマンドラインで削除します。
gcloud compute reservations delete gpu-maintenance-reservation \ --project=my-project-id \ --zone=us-central1-c \ --quiet費用について
GCPの予約に追加料金はかかりません。ただし、予約したリソースについては、実行中のVMにアタッチされているかアイドル状態かにかかわらず料金が発生します。すでにアクティブなGPU VMの料金を支払っているのであれば、予約を追加してもコストは変わりません。アイドルコストが発生するのは、メンテナンス中にVMが再起動しているわずか数分間だけであり、ハードウェアを失うリスクに対する安価な保険と言えます。
インスタンスの停止中に予約済み容量に対していくら支払ったかを正確に確認するには、DoiT Cloud Analyticsが利用できます。compute.googleapis.com/reservation SKUでレポートをフィルタリングすれば、ダウンタイム中に保証された容量の正確なコストを監査できます。
GCPの予約を活用することで、ハードウェアの可用性を運任せから予測可能な保証へと変えられます。予約には基盤となるコンピュートに対する追加料金が一切かからないため、重要なGPUインスタンスを予約で保護しないままにしておくのは無用なリスクです。対象ゾーンで必要な容量を正確にプロビジョニングし、一致するインスタンステンプレートからデプロイして、日常的な再起動や避けられないGoogleのメンテナンスイベントでワークロードが立ち往生しないようにしましょう。


