
Cloud Intelligence™
Não perca suas GPUs durante manutenções no Google Cloud
Garanta capacidade com reservas do GCP
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.
Continuação deste artigo sobre AWS


About Joshua Fox
Senior Cloud Architect II
Joshua Fox has been a software architect in innovative technology companies for 20 years. Now, he advises tech startups and growth companies on architecture and cost optimization for Google Cloud Platform and Amazon Web Services; also publishing articles, and speaking to cloud engineers.
He has a PhD from Harvard University and a BA in math from Brandeis.
My personal pageA demanda global por GPUs é astronômica. Conseguir recursos NVIDIA L4, A100 ou H100 no Google Cloud Platform (GCP) muitas vezes parece uma grande vitória para o seu time de engenharia. Mas você pode perder essa capacidade quando ocorre uma manutenção no hardware subjacente, ou quando você para manualmente sua instância para realizar tarefas de rotina.
Parar sua VM libera seus recursos, seja por um evento de manutenção programada do Google Cloud ou por uma parada iniciada pelo usuário para atualizar um driver, trocar uma imagem ou modificar os escopos da instância. Isso devolve sua GPU ao pool público, deixando seus treinamentos críticos de ML ou workloads de inferência na mão. Veja como proteger suas GPUs e garantir que elas sobrevivam às atualizações de infraestrutura.
O problema: o modelo de manutenção do GCP para GPUs
Um dos melhores recursos do GCP é o Live Migration, que move VMs em execução para hosts saudáveis durante a manutenção da infraestrutura, com interrupção mínima. No entanto, o Live Migration não é compatível com VMs que têm GPUs anexadas.
Como a GPU está fisicamente conectada ao host via PCIe, o GCP não consegue migrar o estado da memória da GPU pela rede. Por isso, o Compute Engine usa a política de manutenção de host TERMINATE (onHostMaintenance) para VMs com GPUs anexadas.
Quando o Google precisa aplicar patches ou substituir o hardware físico que hospeda sua instância:
- O Compute Engine envia um aviso antecipado dos eventos de host programados — normalmente uma hora (manutenções emergenciais podem avisar com menos antecedência).
- A VM recebe um sinal de desligamento ACPI e é forçada a parar.
- Se sua VM estiver configurada com
automaticRestart: true(o padrão), o GCP tenta automaticamente reiniciar a VM em outro host saudável.
Aviso sobre armazenamento: os dados em discos Local SSD são efêmeros e podem ser perdidos durante o encerramento, paradas manuais ou uma recuperação malsucedida após um evento de host. Armazene o estado durável em Persistent Disk, Hyperdisk ou Cloud Storage, e use o Local SSD apenas para caches e dados temporários.
Riscos de manutenções iniciadas pelo usuário
Além dos eventos de host programados, muitas tarefas administrativas de rotina exigem uma parada e reinício completos da VM, e não um simples reboot. Alguns exemplos:
- Atualizar drivers NVIDIA ou toolkits CUDA que exigem um estado offline.
- Modificar atributos centrais da instância (como alterar contas de serviço ou escopos de acesso).
- Migrar para uma nova imagem de máquina ou aplicar patches de SO de forma gradual em um cluster.
Executar um gcloud compute instances stop padrão devolve imediatamente seu hardware ao pool compartilhado de capacidade.
O risco: a loteria da capacidade
Quando o GCP tenta reiniciar sua VM parada (ou quando você a inicia manualmente), ele volta ao pool de recursos da zona e solicita uma nova GPU.
Como as GPUs vivem em um estado de escassez quase permanente, uma tentativa posterior de inicialização pode falhar se não houver capacidade disponível. Em vez de reiniciar, sua VM retornará um erro ZONE_RESOURCE_POOL_EXHAUSTED ou ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS.
Sua VM permanecerá no estado TERMINATED. Você perdeu oficialmente sua GPU e terá que entrar na fila com todo mundo — tentando iniciar a instância repetidamente até que a capacidade seja liberada. Ter cota suficiente no projeto não resolve: não é a mesma coisa que haver capacidade física disponível em uma zona específica. A cota é um limite máximo imposto pelo Google, enquanto a capacidade depende de outros usuários estarem ou não ocupando os recursos existentes.
A solução: reservas zonais com correspondência exata de hardware
A solução que impede que sua GPU seja devolvida ao pool público durante um reinício são as reservas do Compute Engine.
Uma reserva no GCP oferece um nível de garantia de capacidade. Quando sua VM é parada para manutenção, ela abre mão do hardware físico, mas sua reserva de capacidade imediatamente ocupa o "espaço vazio", mantendo a alocação reservada para o seu projeto. Quando o Compute Engine reinicia a VM automaticamente ou você a inicia de novo manualmente, sua VM simplesmente consome sua reserva dedicada.
As reservas do GCP são altamente específicas:
- Restrição zonal: as reservas estão vinculadas a uma zona específica (por exemplo, us-central1-c), não a uma região mais ampla.
- Exigência de correspondência exata: sua VM precisa corresponder perfeitamente aos parâmetros da reserva para consumi-la. O tipo de máquina, o tipo e a quantidade de GPUs, o Local SSD e outras propriedades devem ser idênticos.
- Sem exigência de SO: diferentemente das reservas de capacidade da AWS, que exigem correspondência de sistema operacional (plataforma), o GCP não exige correspondência do sistema operacional ou da imagem de boot, dando a você flexibilidade para trocar imagens sem quebrar o vínculo da reserva.
Nesse cenário, a reserva serve para reter seus recursos existentes. Se você ainda não estiver executando a GPU, a criação da reserva pode falhar; somente quando o recurso estiver disponível a reserva será criada com sucesso.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Restrições importantes e casos específicos
Embora as reservas sejam a defesa padrão contra a perda de capacidade, você precisa considerar algumas regras de arquitetura específicas do GCP:
- Configurações de GPU restritas: devido a restrições extremas de oferta, algumas configurações de GPU mais novas ou muito disputadas não podem ser reservadas usando reservas de capacidade on-demand padrão. Por exemplo, as configurações A4X Max, A3 Ultra e A3 High com menos de oito GPUs atualmente têm restrições. Sempre verifique a elegibilidade de reserva na documentação do GCP.
- VMs Spot vs. CUDs: as reservas protegem workloads de VMs padrão. Elas não protegem VMs Spot, que não podem consumir reservas e são preemptivas por definição.
- CUDs: os Committed Use Discounts afetam o preço; eles não reservam capacidade por si só. Note que os CUDs são cobrados por VMs, mas também por reservas inativas.
- Integração com o GKE: as reservas do Compute Engine podem proteger a capacidade de GPU usada pelo Google Kubernetes Engine (GKE). No GKE Standard, configure o pool de nós com afinidade de reserva. No GKE Autopilot, é necessário selecionar explicitamente uma reserva ou configurar uma ComputeClass personalizada compatível.
Como implementar reservas de GPU para manutenções iniciadas pelo usuário
A abordagem mais segura para evitar desvios de configuração é definir a VM uma única vez em um template de instância e criar a reserva a partir desse template. Por padrão, as reservas são configuradas como "Consumir automaticamente". Qualquer VM criada no seu projeto que corresponda exatamente às especificações da reserva vai consumi-la automaticamente.
1. Crie a reserva
Se você estiver realizando manutenção gradual em um cluster (como aplicar patches de SO nó por nó), não é necessário reservar capacidade para toda a frota. Dimensione sua reserva para corresponder ao número exato de instâncias que você planeja derrubar simultaneamente. Por exemplo, se você faz o drain e atualiza dois nós por vez, defina o --vm-count como 2 para capturar essas instâncias específicas enquanto elas reiniciam.
Você pode provisionar a reserva usando um template de instância para garantir a correspondência exata via linha de comando:
gcloud compute reservations create gpu-maintenance-reservation \ --project=my-project-id \ --source-instance-template=projects/my-project-id/global/instanceTemplates/my-gpu-template \ --vm-count=1 \ --zone=us-central1-cComo alternativa, você pode definir a reserva diretamente:
gcloud compute reservations create reservation-v100 \ --project=joshua-playground \ --zone=us-east1-c \ --machine-type=n1-standard-1 \ --accelerator=count=1,type=nvidia-tesla-v100 \ --vm-count=1 \ --require-specific-reservation=falseE, claro, isso também pode ser feito no Console do Google Cloud.
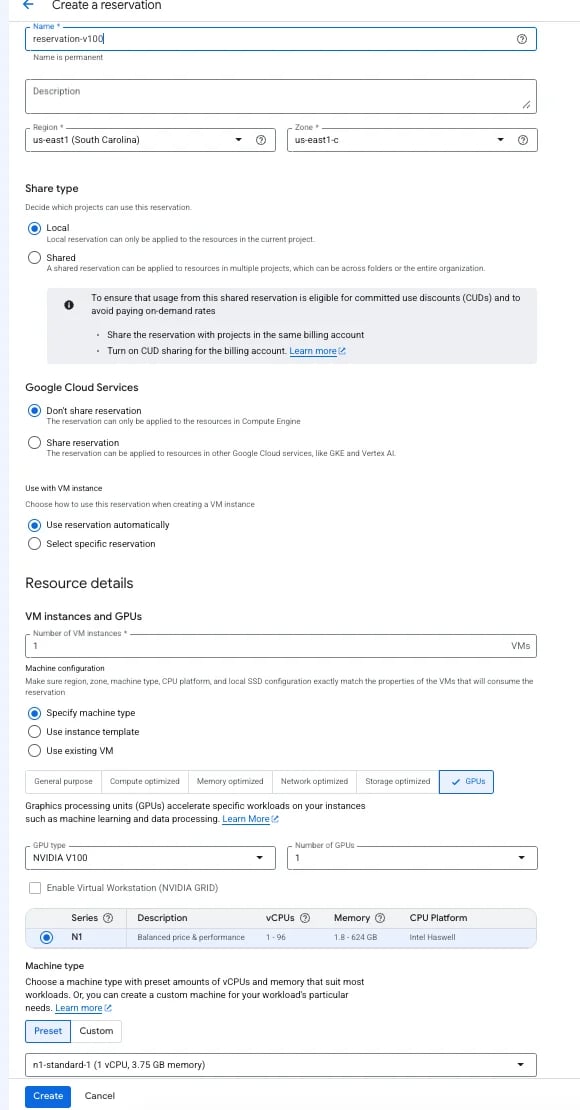
2. Implante sua VM e verifique o consumo
Como --require-specific-reservation está definido como false, você não precisa alterar seus scripts de implantação de VM. Desde que você inicie uma instância com correspondência exata na mesma zona, o GCP alocará automaticamente a VM na sua capacidade reservada.
Para confirmar que o número esperado de instâncias está consumindo os slots reservados, verifique as métricas de reserva no Console do Google Cloud. Você pode ver as reservas atuais em Compute Engine > Reservas, ou consultar o uso histórico no Google Cloud Monitoring, usando as métricas compute.googleapis.com/reservation/used e compute.googleapis.com/reservation/reserved.
3. Remova sua reserva
Ao contrário das VMs padrão, as reservas de capacidade precisam ser excluídas explicitamente quando você não precisar mais delas. Se você desativar permanentemente seu workload e excluir a VM, mas esquecer de excluir a reserva, continuará pagando pela capacidade de GPU ociosa à tarifa on-demand integral; e os CUDs serão cobrados.
Quando terminar de usar a reserva, remova-a pela linha de comando:
gcloud compute reservations delete gpu-maintenance-reservation \ --project=my-project-id \ --zone=us-central1-c \ --quietO lado financeiro
As reservas no GCP não custam nada a mais, embora você pague pelos recursos reservados, estejam eles ativamente anexados a uma VM em execução ou ociosos. Como você já está pagando pela VM de GPU ativa, vinculá-la a uma reserva não gera custo adicional. Você só incorre em custos de ociosidade durante os breves minutos em que a VM está reiniciando na manutenção, o que torna isso uma apólice de seguro barata contra a perda do seu hardware.
Para verificar exatamente quanto você pagou pela capacidade reservada enquanto suas instâncias estavam paradas, você pode usar o DoiT Cloud Analytics. Filtre seus relatórios pelo SKU compute.googleapis.com/reservation para auditar o custo exato da capacidade garantida durante o período de inatividade.
Ao usar reservas do GCP, você transforma a disponibilidade de hardware de uma loteria em uma garantia previsível. Como as reservas não custam nada além da computação subjacente, deixar de proteger suas instâncias de GPU críticas com uma reserva é um risco desnecessário. Provisione a capacidade exata de que você precisa na zona de destino, implante a partir de um template de instância correspondente e garanta que reinícios de rotina ou manutenções inevitáveis do Google nunca deixem seus workloads na mão.


