
Construa, lance e rode a OpenAI em produção
OpenAI na DoiT
Leve a OpenAI Platform do piloto à produção na AWS, no Google Cloud e no Azure. O modelo certo, custos que você enxerga e operações que aguentam o tranco.
prática OpenAI de nível enterprise
A maioria dos projetos de IA trava depois da demo
O modelo funciona. A fatura, a latência e a confiabilidade, não. Mantemos uma prática OpenAI de nível enterprise criada para uma única missão: levar a IA do piloto à produção.
Combinamos profundidade em OpenAI com nosso DNA de FinOps e CloudOps. Nossos Forward Deployed Engineers se integram ao seu time e entregam código — em vez de deixar um deck de estratégia e ir embora.
Por que a DoiT
Muita empresa consegue conduzir um workshop de OpenAI. Poucas conseguem operar o workload depois que ele entra no ar. É nessa lacuna que a gente trabalha.
Multicloud por padrão
OpenAI no Amazon Bedrock, além de API direta. Escolhemos o caminho que se encaixa na sua stack, não na nossa.
FinOps no DNA
Precificamos e otimizamos gastos de nuvem desde 2011. Tokens, GPUs e trade-offs entre provedores medidos até o último dólar.
Entrega integrada
Engenheiros seniores entram no seu time. Eles conhecem sua arquitetura, seu contexto e suas restrições.
Instrumentação de fábrica
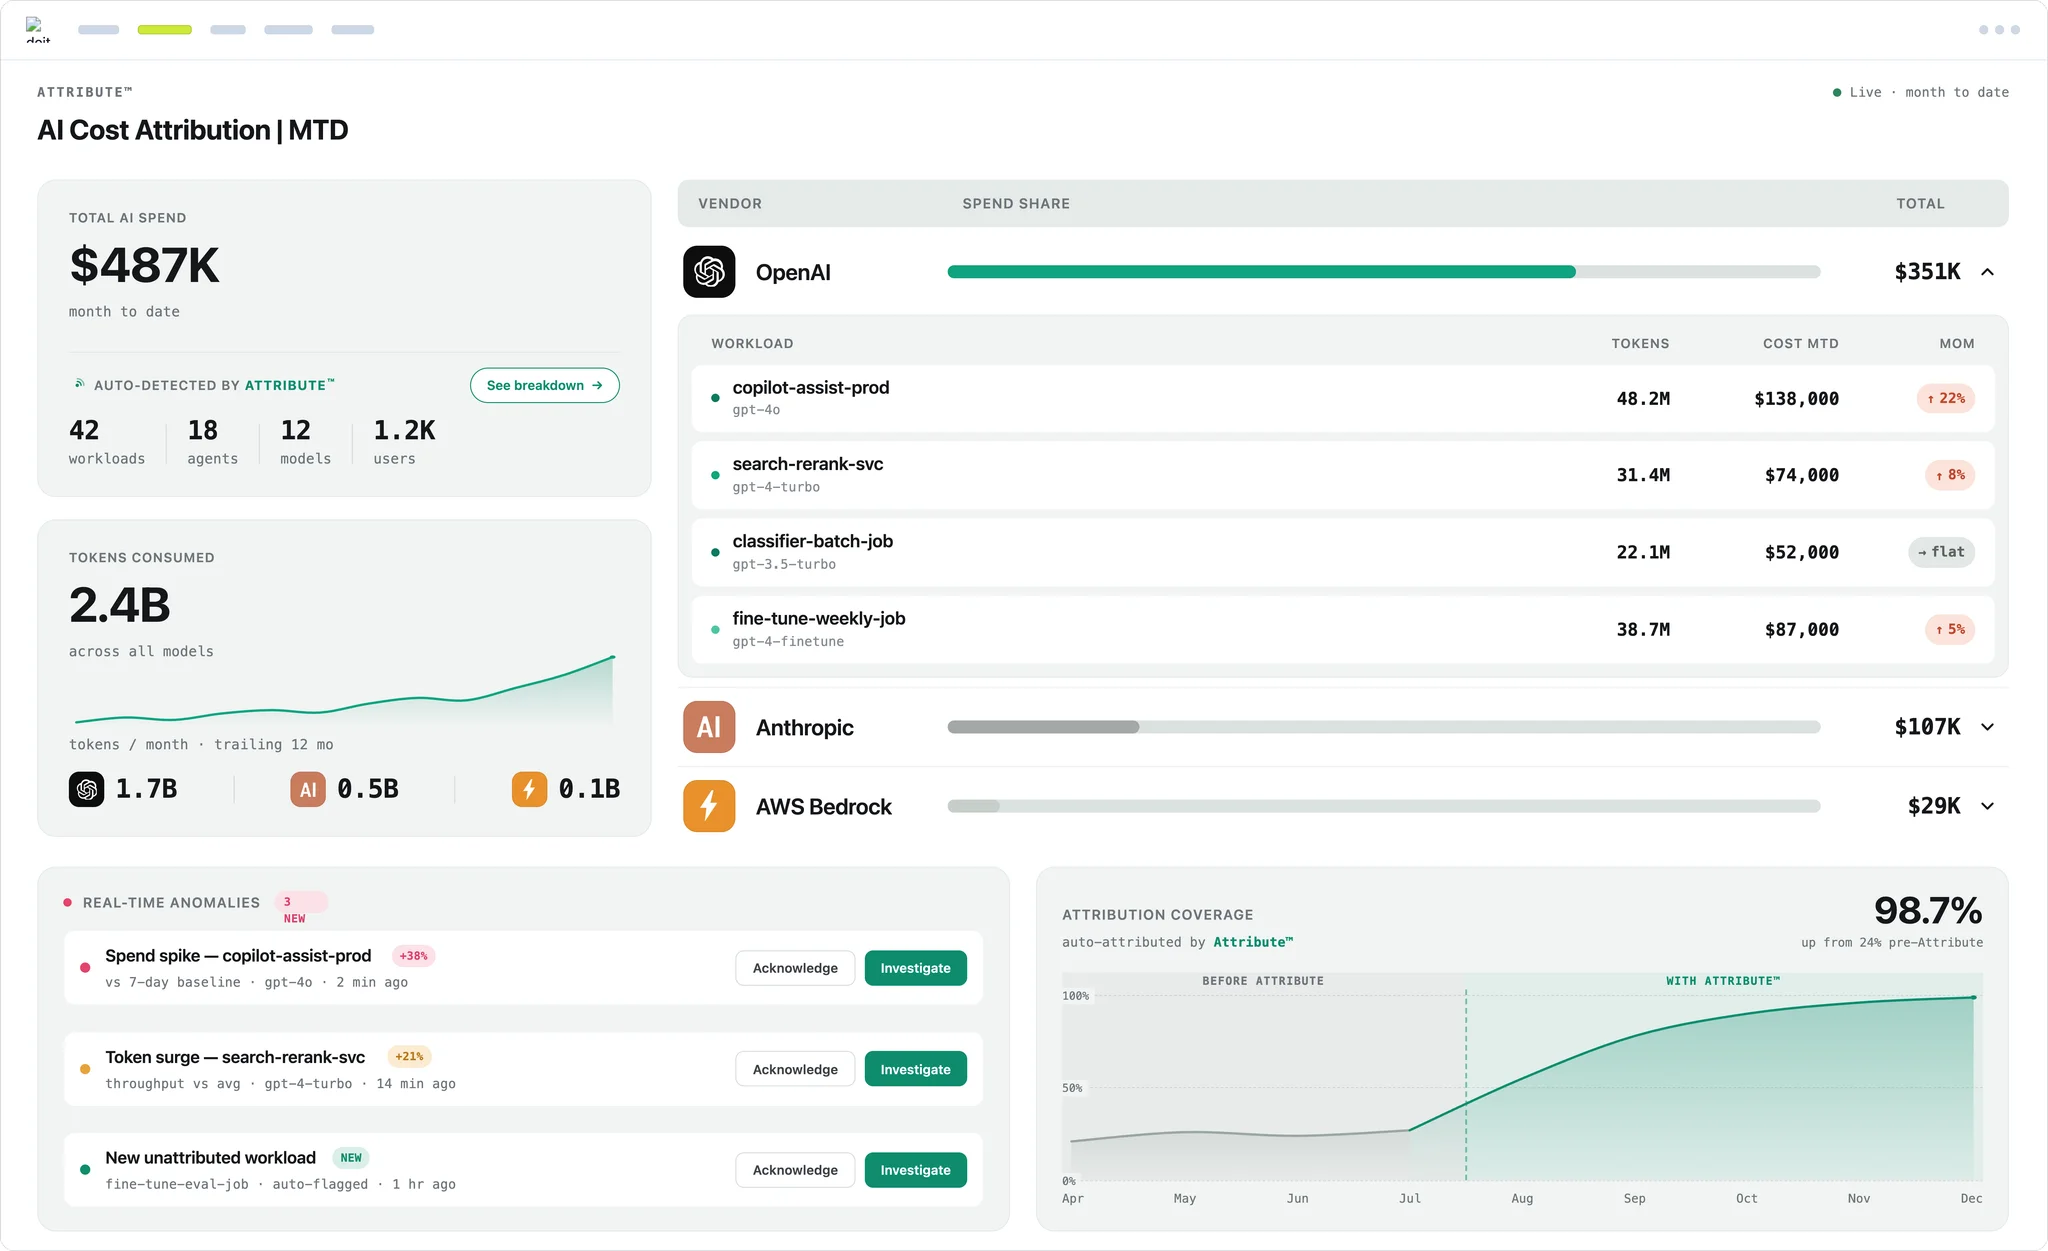
Atribua o gasto de IA por time, funcionalidade e cliente para ver quanto a OpenAI realmente custa.
o que a parceria entrega para você
Do piloto à produção, mais rápido
O modelo certo. Metas de verdade. Custos que você consegue defender.
O modelo certo para cada tarefa
Um modelo para raciocínio complexo, outro para equilíbrio e mais um para trabalho de alto volume.
Caminho mais curto até a produção
Arquiteturas de referência transformam semanas em dias.
Custos sob seu controle
Unit economics desde o primeiro dia, ajustados para margem.
Confiabilidade sob carga
Padrões de alta disponibilidade e planos de rollback prontos antes do go-live.
Eval harnesses incluídos
Qualidade medida por avaliações automatizadas, não no chute.
Governança integrada
Acesso com privilégio mínimo e propriedade clara dos dados entre os times.
como entregamos
Forward Deployed Engineers, não uma fila de tickets
FDEs são arquitetos de nuvem seniores que se integram diretamente ao seu time. Eles trabalham lado a lado com seus engenheiros para implementar, testar e fazer deploy. E são donos dos resultados em todo o ciclo de vida da OpenAI: engenharia de agentes e workflows, RAG e sistemas de conhecimento, eval harnesses, otimização de custos de inferência, confiabilidade e segurança.
Como o trabalho acontece
Cinco fases. Mudanças reais no código, não recomendações.
Kickoff
Alinhamento de casos de uso, SLOs e das dores mais urgentes. Mapeamento do seu ambiente.
Planejamento
Escopo da construção. Escolha de modelos, definição de evals, metas de custo e latência.
Entrega
Implementação junto com seus engenheiros. Mudanças reais no seu codebase.
Automação
Monitoramento, guardrails e controles de política integrados. Sem precisar ficar de olho.
Comprovação
Medimos qualidade, custo e confiabilidade contra as metas. E seguimos em frente.
Trate a OpenAI como produção
Demanda em picos, escalonamento de GPUs, drift de modelo, custos imprevisíveis. Nosso time de FDEs cuida das operações de OpenAI como cuidamos de qualquer workload crítico.
Eficiência de GPU
Identifique inferência e treinamentos subutilizados. Mantenha os aceleradores ocupados sem desperdício.
Padrões de escalabilidade
Estratégias de autoscaling ajustadas para tráfego de LLMs e agentes.
Pipelines de dados
Ingestão e pré-processamento robustos para que retrieval e treinamento nunca travem.
FinOps para OpenAI
Enxergue uso de tokens, custos por provedor e trade-offs com clareza.
Resiliência por padrão
Padrões de alta disponibilidade, domínios de falha e degradação controlada já integrados.
Validação de produção
Testes de carga, simulações de caos e planos de rollback antes do go-live.
veja quanto a OpenAI realmente custa
A fatura de tokens esconde a verdade
Você sabe o total. Mas não sabe qual time, funcionalidade ou cliente gerou esse gasto. A gente muda isso.
Usamos instrumentação em nível de kernel para atribuir gastos de IA e nuvem na origem, sem mudanças no código. Conecte cada chamada de API ao workload por trás dela. Tome decisões de trade-off com números reais.
O que construímos
Cada projeto parte de um problema, não de uma funcionalidade.
Workflows agênticos
A OpenAI faz o trabalho de múltiplas etapas que seu time hoje faz na mão.
Sistemas de conhecimento e RAG
Respostas ancoradas nos seus dados, não na web aberta.
Aceleração de código e SDLC
Review, refatoração e migração mais rápidos com o Codex no fluxo.
Automação de suporte
Resolva tickets e reduza volume sem perder o cliente.
Análise de documentos e contratos
Extraia, resuma e verifique em escala.
Workloads sob medida
Construídos em torno da sua stack, dos seus dados e dos seus SLOs, não de um template.
Comece a construir com a OpenAI
Mapeamos suas prioridades e o caminho mais rápido até a produção.