
Cloud Intelligence™
Le sue GPU al sicuro durante la manutenzione su Google Cloud
Capacità garantita con le prenotazioni di GCP
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.
Seguito di questo articolo per AWS


About Joshua Fox
Senior Cloud Architect II
Joshua Fox has been a software architect in innovative technology companies for 20 years. Now, he advises tech startups and growth companies on architecture and cost optimization for Google Cloud Platform and Amazon Web Services; also publishing articles, and speaking to cloud engineers.
He has a PhD from Harvard University and a BA in math from Brandeis.
My personal pageLa domanda globale di GPU è astronomica. Riuscire ad assicurarsi risorse NVIDIA L4, A100 o H100 su Google Cloud Platform (GCP) è spesso una grande vittoria per il team di engineering. Eppure quella capacità può andare persa quando viene eseguita la manutenzione dell'hardware sottostante, o quando si arresta manualmente l'istanza per svolgere attività ordinarie.
Arrestare la VM rilascia le risorse, che si tratti di un evento di manutenzione pianificata di Google Cloud o di un arresto avviato dall'utente per applicare una patch a un driver, ruotare un'immagine o modificare gli scope dell'istanza. In questo modo la GPU torna nel pool pubblico, lasciando bloccati i run di training ML critici o i workloads di inferenza. Ecco come blindare le sue GPU e assicurarsi che sopravvivano agli aggiornamenti dell'infrastruttura.
Il problema: il modello di manutenzione di GCP per le GPU
Una delle funzionalità migliori di GCP è la Live Migration, che sposta senza interruzioni le VM in esecuzione su host integri durante la manutenzione dell'infrastruttura, con un impatto minimo. Tuttavia, la Live Migration non è supportata per le VM con GPU collegate.
Poiché la GPU è collegata fisicamente all'host tramite PCIe, GCP non può migrare lo stato della memoria GPU attraverso la rete. Di conseguenza, Compute Engine utilizza il criterio di manutenzione dell'host TERMINATE (onHostMaintenance) per le VM con GPU collegate.
Quando Google deve applicare patch o sostituire l'hardware fisico che ospita l'istanza:
- Compute Engine invia un preavviso degli eventi host pianificati, in genere di un'ora (la manutenzione di emergenza può concedere meno tempo).
- La VM riceve un segnale di arresto ACPI e viene arrestata forzatamente.
- Se la VM è configurata con
automaticRestart: true(impostazione predefinita), GCP tenta automaticamente di riavviarla su un host diverso e integro.
Attenzione allo storage: i dati sui dischi Local SSD sono effimeri e possono andare persi durante la terminazione, gli arresti manuali o un ripristino non riuscito dopo un evento host. Conservi lo stato durevole su Persistent Disk, Hyperdisk o Cloud Storage e utilizzi i Local SSD solo per cache e dati temporanei.
I rischi della manutenzione avviata dall'utente
Oltre agli eventi host pianificati, molte attività amministrative ordinarie richiedono un ciclo completo di stop/start della VM anziché un semplice riavvio. Alcuni esempi:
- Aggiornare driver NVIDIA o toolkit CUDA che richiedono lo stato offline.
- Modificare attributi fondamentali dell'istanza (ad esempio service account o access scope).
- Passare a una nuova immagine macchina o gestire il patching rolling del sistema operativo su un cluster.
Eseguire un normale gcloud compute instances stop restituisce immediatamente l'hardware al pool di capacità condiviso.
Il rischio: la lotteria della capacità
Quando GCP tenta di riavviare la VM arrestata (o quando l'avvio viene eseguito manualmente), torna al pool di risorse della zona e richiede una nuova GPU.
Poiché le GPU si trovano in uno stato di scarsità pressoché permanente, un avvio successivo può fallire se la capacità non è disponibile. Invece di riavviarsi, la VM genererà un errore ZONE_RESOURCE_POOL_EXHAUSTED o ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS.
La VM rimarrà nello stato TERMINATED. La GPU è ufficialmente persa e bisognerà mettersi in coda come tutti gli altri, riprovando ripetutamente ad avviare l'istanza finché non si libera capacità. Avere una quota di progetto sufficiente non basta: non equivale alla disponibilità di capacità fisica in una zona specifica. La quota è un limite massimo imposto da Google, mentre la capacità dipende dal fatto che le risorse esistenti siano o meno occupate da altri utenti.
La soluzione: prenotazioni zonali con corrispondenza esatta dell'hardware
La soluzione che impedisce che la GPU venga restituita al pool pubblico durante un riavvio sono le prenotazioni di Compute Engine (Compute Engine Reservations).
Una prenotazione in GCP offre un livello di garanzia sulla capacità. Quando la VM viene arrestata per manutenzione, rilascia il suo diritto sull'hardware fisico, ma la prenotazione di capacità intercetta immediatamente lo "spazio vuoto", mantenendo l'allocazione riservata al progetto. Quando Compute Engine riavvia automaticamente la VM, o quando la si riavvia manualmente, la VM semplicemente consuma la prenotazione dedicata.
Le prenotazioni GCP sono estremamente specifiche:
- Vincolo zonale: le prenotazioni sono legate a una zona specifica (es. us-central1-c), non a un'intera regione.
- Corrispondenza esatta obbligatoria: per consumare la prenotazione, la VM deve corrisponderne perfettamente i parametri. Il tipo di macchina, il tipo e il numero di GPU, i Local SSD e le altre proprietà devono essere identici.
- Nessun requisito sul sistema operativo: a differenza delle capacity reservation di AWS, che impongono la corrispondenza del sistema operativo (piattaforma), GCP non richiede la corrispondenza del sistema operativo o dell'immagine di avvio, offrendo la flessibilità di ruotare le immagini senza invalidare la prenotazione.
In questo scenario, la prenotazione serve a conservare le risorse esistenti. Se la GPU non è ancora in esecuzione, la creazione della prenotazione potrebbe fallire; solo quando la risorsa è disponibile la prenotazione verrà creata con successo.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Restrizioni importanti e casi particolari
Sebbene le prenotazioni siano la difesa standard contro la perdita di capacità, è necessario tenere conto di alcune regole architetturali specifiche di GCP:
- Configurazioni GPU con restrizioni: a causa dei vincoli estremi dell'offerta, alcune configurazioni GPU più recenti o molto richieste non possono essere prenotate con le prenotazioni di capacità on-demand standard. Ad esempio, le configurazioni A4X Max, A3 Ultra e A3 High con meno di otto GPU presentano attualmente delle restrizioni. Verifichi sempre l'idoneità alla prenotazione nella documentazione GCP.
- Spot VM vs. CUD: le prenotazioni proteggono i workloads su VM standard. Non proteggono le Spot VM, che non possono consumare prenotazioni e sono per loro stessa natura soggette a prerilascio.
- CUD: i Committed Use Discount incidono sui prezzi, ma non riservano di per sé la capacità. Si noti che i CUD vengono addebitati per le VM, ma anche per le prenotazioni inattive.
- Integrazione con GKE: le prenotazioni di Compute Engine possono proteggere la capacità GPU utilizzata da Google Kubernetes Engine (GKE). In GKE Standard, configuri il node pool con la reservation affinity. In GKE Autopilot, è necessario selezionare esplicitamente una prenotazione o configurare una ComputeClass personalizzata supportata.
Come implementare le prenotazioni GPU per la manutenzione avviata dall'utente
L'approccio più sicuro per prevenire il configuration drift è definire la VM una sola volta in un instance template e creare la prenotazione a partire da quel template. Per impostazione predefinita, le prenotazioni sono impostate su "Consuma automaticamente". Qualsiasi VM creata nel progetto che corrisponda esattamente alle specifiche della prenotazione la occuperà automaticamente.
1. Creare la prenotazione
Se sta eseguendo una manutenzione rolling su un cluster (ad esempio il patching del sistema operativo nodo per nodo), non serve riservare capacità per l'intero parco macchine. Dimensioni la prenotazione in base al numero esatto di istanze che intende arrestare contemporaneamente. Ad esempio, se svuota e aggiorna due nodi alla volta, imposti --vm-count su 2 per intercettare quelle istanze specifiche durante il riavvio.
Può effettuare il provisioning della prenotazione utilizzando un instance template per garantire la corrispondenza esatta dalla riga di comando:
gcloud compute reservations create gpu-maintenance-reservation \ --project=my-project-id \ --source-instance-template=projects/my-project-id/global/instanceTemplates/my-gpu-template \ --vm-count=1 \ --zone=us-central1-cIn alternativa, può definire la prenotazione direttamente:
gcloud compute reservations create reservation-v100 \ --project=joshua-playground \ --zone=us-east1-c \ --machine-type=n1-standard-1 \ --accelerator=count=1,type=nvidia-tesla-v100 \ --vm-count=1 \ --require-specific-reservation=falseE naturalmente tutto questo si può fare anche dalla Google Cloud Console.
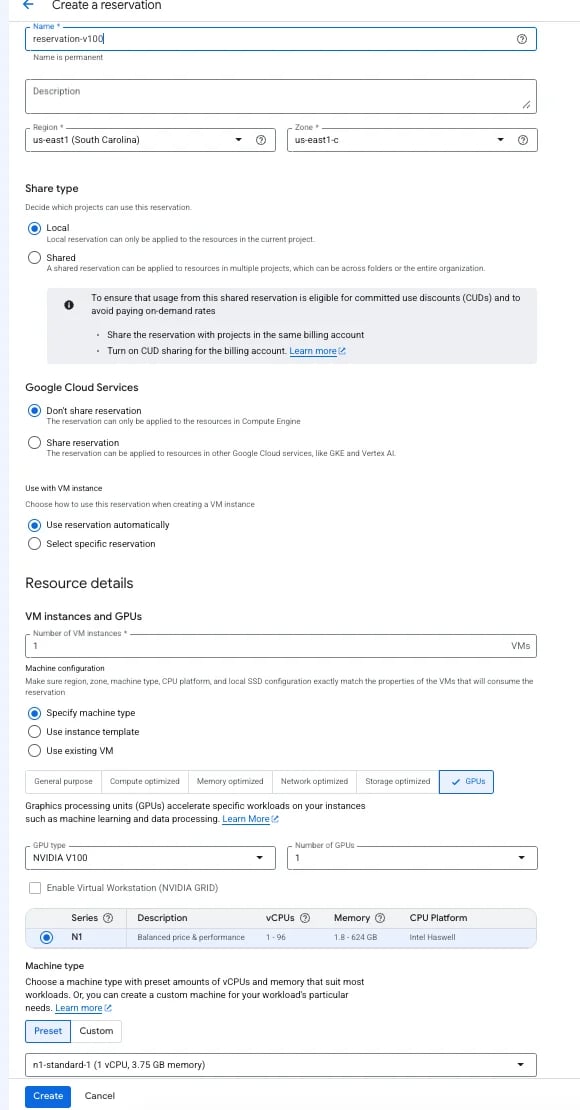
2. Eseguire il deployment della VM e verificare il consumo
Poiché --require-specific-reservation è impostato su false, non è necessario modificare gli script di deployment delle VM. Finché avvia un'istanza che corrisponde esattamente nella stessa zona, GCP inserirà automaticamente la VM nella capacità riservata.
Per confermare che il numero previsto di istanze stia consumando gli slot riservati, controlli le metriche delle prenotazioni nella Google Cloud Console. Può visualizzare le prenotazioni correnti in Compute Engine > Prenotazioni, oppure consultare l'utilizzo storico in Google Cloud Monitoring, utilizzando le metriche compute.googleapis.com/reservation/used e compute.googleapis.com/reservation/reserved.
3. Eliminare la prenotazione
A differenza delle VM standard, le prenotazioni di capacità devono essere eliminate esplicitamente quando non servono più. Se ritira definitivamente il workload ed elimina la VM, ma dimentica di eliminare la prenotazione, continuerà a pagare la capacità GPU inutilizzata alla tariffa on-demand piena; e i CUD verranno fatturati.
Quando la prenotazione non le serve più, la rimuova dalla riga di comando:
gcloud compute reservations delete gpu-maintenance-reservation \ --project=my-project-id \ --zone=us-central1-c \ --quietGli aspetti economici
Le prenotazioni in GCP non comportano costi aggiuntivi, anche se le risorse riservate si pagano sia quando sono effettivamente collegate a una VM in esecuzione sia quando restano inattive. Poiché sta già pagando la VM GPU attiva, proteggerla con una prenotazione non costa nulla in più. Gli unici costi per l'inattività si limitano ai pochi minuti in cui la VM si riavvia durante la manutenzione: una polizza assicurativa economica contro la perdita dell'hardware.
Per verificare esattamente quanto ha pagato per la capacità riservata mentre le istanze erano arrestate, può utilizzare DoiT Cloud Analytics. Filtri i report per lo SKU compute.googleapis.com/reservation per controllare il costo esatto della capacità garantita durante il downtime.
Utilizzando le prenotazioni di GCP, la disponibilità dell'hardware si trasforma da gioco d'azzardo in garanzia prevedibile. Poiché le prenotazioni non costano nulla in più rispetto al compute sottostante, non proteggere le istanze GPU critiche con una prenotazione è un rischio inutile. Esegua il provisioning della capacità esatta di cui ha bisogno nella zona di destinazione, effettui il deployment da un instance template corrispondente e si assicuri che i riavvii ordinari o gli inevitabili eventi di manutenzione di Google non lascino mai bloccati i suoi workloads.


