
Sviluppare, rilasciare e gestire OpenAI in produzione
OpenAI su DoiT
Porti OpenAI Platform dal pilot alla produzione su AWS, Google Cloud e Azure. Il modello giusto, costi trasparenti, operations che reggono.
una practice OpenAI di livello enterprise
La maggior parte dei progetti AI si ferma dopo la demo
Il modello funziona. La fattura, la latenza e l'affidabilità no. Gestiamo una practice OpenAI di livello enterprise costruita per un unico obiettivo: portare l'AI dal pilot alla produzione.
Uniamo la competenza su OpenAI al nostro DNA FinOps e CloudOps. I nostri Forward Deployed Engineers si integrano nel suo team e consegnano risultati concreti, invece di lasciarle una presentazione strategica e andarsene.
Perché DoiT
Molte aziende sanno organizzare un workshop su OpenAI. Poche sanno gestire il workload una volta in produzione. È proprio lì che lavoriamo noi.
Multicloud by default
OpenAI su Amazon Bedrock, più API diretta. Scegliamo il percorso adatto al suo stack, non al nostro.
DNA FinOps
Misuriamo e ottimizziamo la spesa cloud dal 2011. Token, GPU e trade-off tra provider, quantificati al dollaro.
Delivery integrata
Engineer senior entrano a far parte del suo team. Conoscono la sua architettura, il suo contesto e i suoi vincoli.
Strumentazione integrata
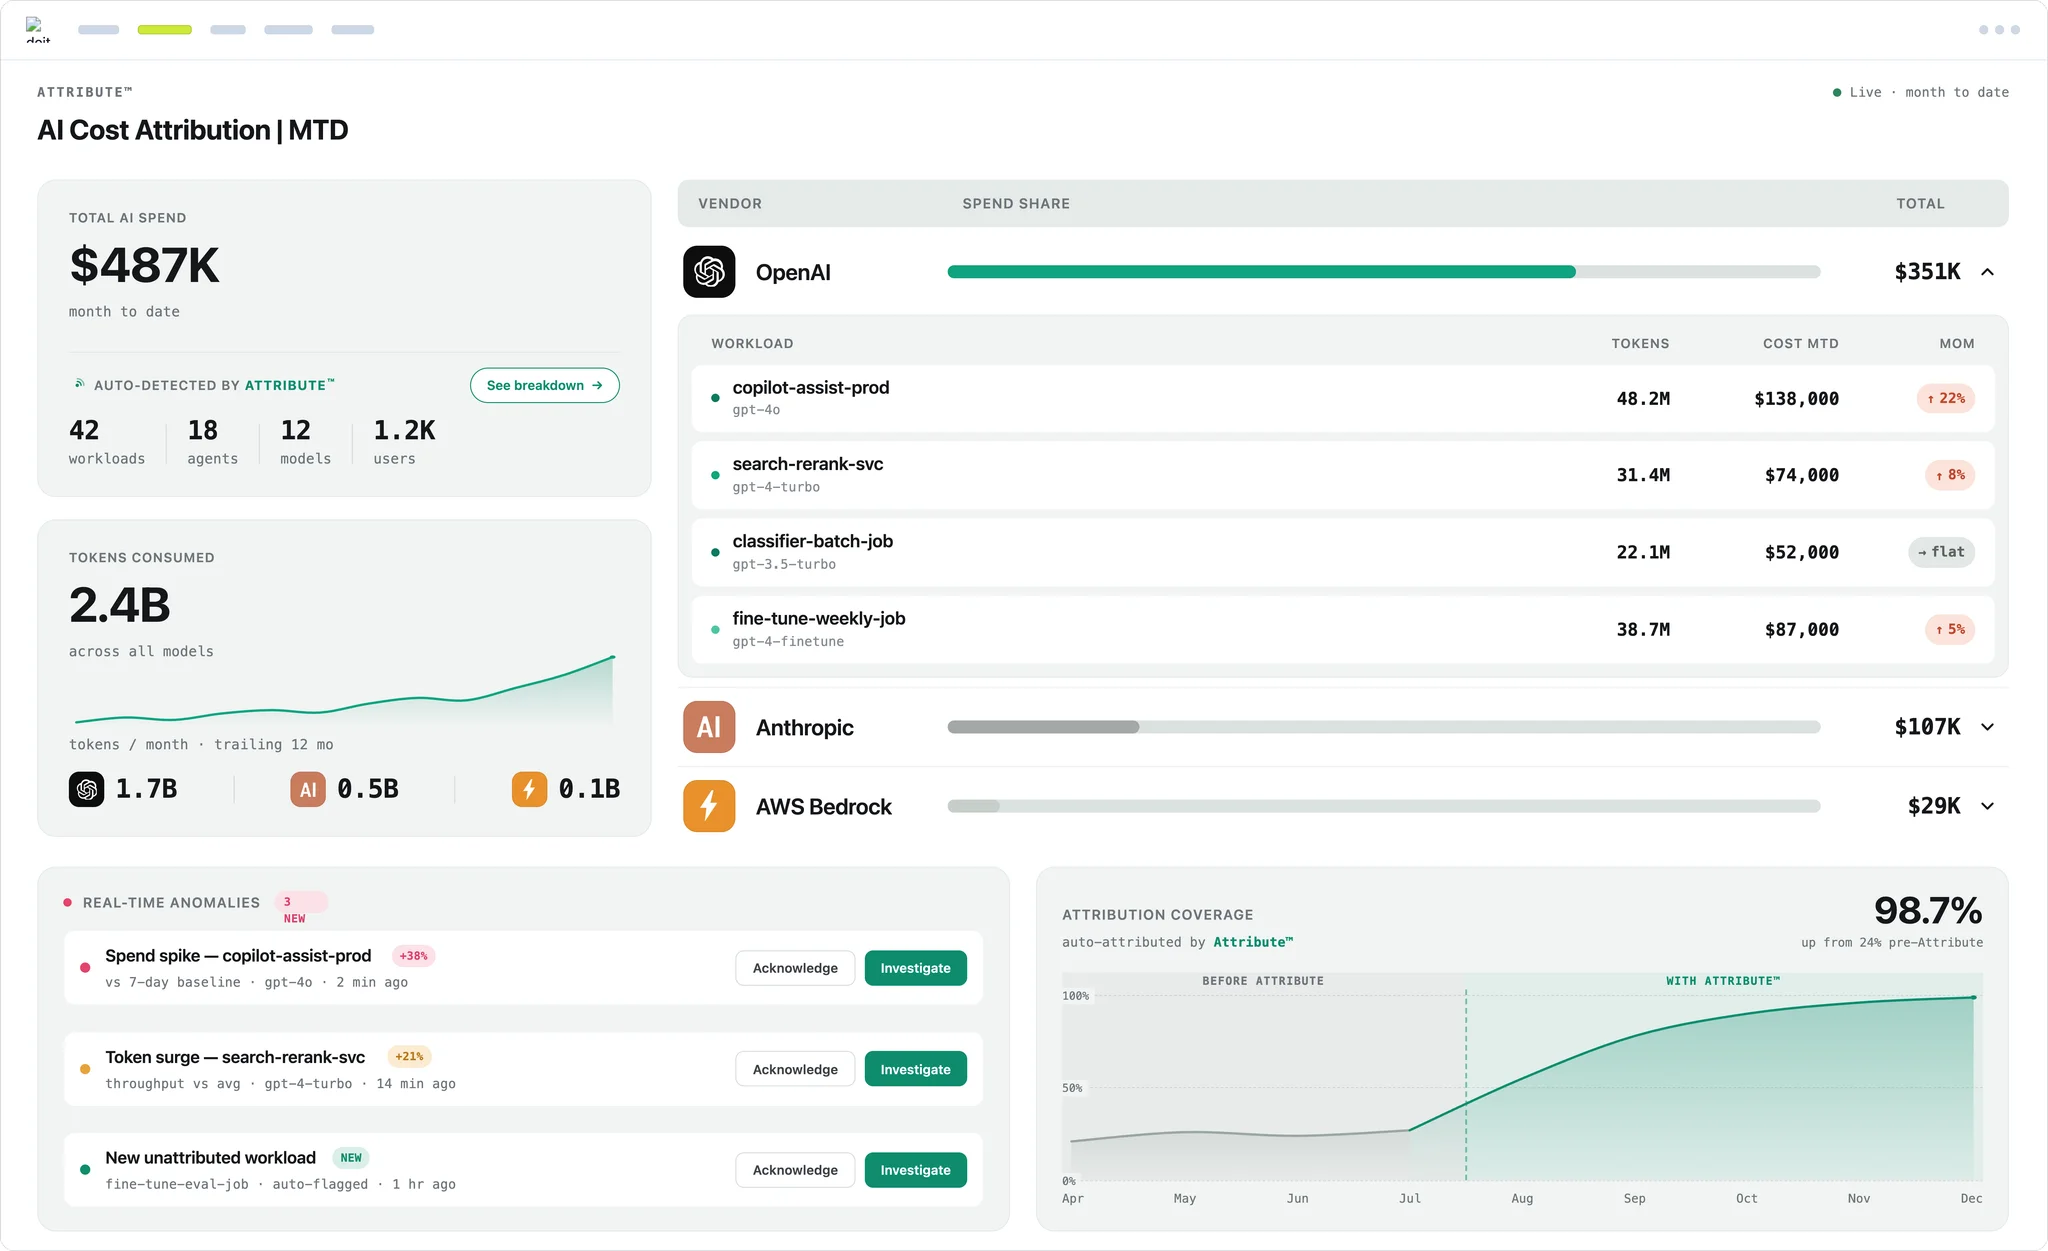
Attribuiamo la spesa AI per team, funzionalità e cliente: così vede quanto costa davvero OpenAI.
cosa le offre la partnership
Dal pilot alla produzione, più in fretta
Il modello giusto. Obiettivi concreti. Costi che può giustificare.
Il modello giusto per ogni compito
Un modello per il reasoning complesso, un altro per l'equilibrio e un altro ancora per i volumi elevati.
Un percorso più rapido verso la produzione
Le architetture di riferimento comprimono settimane in giorni.
Costi sotto controllo
Unit economics dal primo giorno, ottimizzate per il margine.
Affidabilità sotto carico
Pattern di alta disponibilità e piani di rollback integrati prima del go-live.
Eval harness inclusi
La qualità si misura con valutazioni automatizzate, non si indovina.
Governance integrata
Accessi least-privilege e chiara ownership dei dati tra i team.
come lavoriamo
Forward Deployed Engineers, non una coda di ticket
Gli FDE sono cloud architect senior che si integrano direttamente nel suo team. Lavorano fianco a fianco con i suoi engineer per implementare, testare e deployare. Sono responsabili dei risultati lungo l'intero ciclo di vita OpenAI: engineering di agenti e workflow, RAG e knowledge system, eval harness, ottimizzazione dei costi di inferenza, affidabilità e sicurezza.
Come si svolge l'engagement
Cinque fasi. Modifiche reali al codice, non semplici raccomandazioni.
Kickoff
Allineamento su casi d'uso, SLO e priorità urgenti. Mappatura del suo ambiente.
Pianificazione
Definiamo il perimetro del progetto. Scegliamo i modelli, definiamo le eval, fissiamo obiettivi di costo e latenza.
Rilascio
Implementiamo insieme ai suoi engineer. Modifiche reali nella sua codebase.
Automazione
Integriamo monitoraggio, guardrail e controlli di policy. Senza bisogno di supervisione continua.
Verifica
Misuriamo qualità, costi e affidabilità rispetto agli obiettivi. Poi passiamo oltre.
OpenAI gestito come un vero ambiente di produzione
Domanda a picchi, scheduling delle GPU, drift dei modelli, costi imprevedibili. Il nostro team di FDE gestisce le operations di OpenAI come qualsiasi altro workload critico.
Efficienza GPU
Individuiamo run di inferenza e training sottoutilizzati. Acceleratori sempre operativi, senza sprechi.
Pattern di scaling
Strategie di autoscaling ottimizzate per il traffico di LLM e agenti.
Pipeline di dati
Rafforziamo ingestion e preprocessing perché retrieval e training non si fermino mai.
FinOps per OpenAI
Visibilità chiara su utilizzo dei token, costi dei provider e trade-off.
Resilienza by default
Pattern di alta disponibilità, failure domain e degradazione controllata, integrati fin dall'inizio.
Validazione per la produzione
Load test, chaos drill e piani di rollback prima del go-live.
quanto costa davvero OpenAI
Le fatture a token nascondono la verità
Conosce il totale. Ma non sa quale team, funzionalità o cliente lo ha generato. Noi cambiamo le cose.
Usiamo una strumentazione a livello kernel per attribuire la spesa AI e cloud direttamente alla fonte, senza modifiche al codice. Colleghi ogni chiamata API al workload che la genera. Valuti i trade-off con numeri reali.
Cosa costruiamo
Ogni engagement parte da un problema, non da una funzionalità.
Workflow agentici
OpenAI svolge il lavoro multi-step che oggi il suo team fa a mano.
Sistemi di knowledge e RAG
Risposte basate sui suoi dati, non sul web aperto.
Accelerazione di coding e SDLC
Review, refactoring e migrazioni più veloci con Codex nel loop.
Automazione del supporto
Risoluzione dei ticket e riduzione dei volumi senza perdere il cliente.
Analisi di documenti e contratti
Estrazione, sintesi e verifica su larga scala.
Workloads su misura
Costruiti attorno al suo stack, ai suoi dati e ai suoi SLO, non su un template.
Inizi a costruire con OpenAI
Mappiamo le sue priorità e il percorso più rapido verso la produzione.