
Cloud Intelligence™
エージェントはアイドルでも、Kubernetesの請求は止まらない
Kubernetesには「スリープ中のPod」というネイティブな概念がありません。Agent Substrateは、コールドスタートのペナルティなしに、数千のステートフルなエージェントを共有ワーカープールに多重化します。
このページはEnglish、Deutsch、Español、Français、Italiano、Portuguêsでもご覧いただけます。


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal page対話型エージェント、パーソナルアシスタント、コーディングエージェント、ツール呼び出し用のサンドボックスは、実行時間の大半を人間や外部トリガーの待機に費やしています。その間、実際の計算処理は何も行っていません。しかしKubernetes上では、このアイドル時間にも実リソースのコストが発生し、本来ならアクティブな処理に使えるはずのキャパシティを消費し続けます。
標準的なKubernetesは、すべてのワークロードを専用のPodに紐づけます。Podのスケジューリングスループットと起動レイテンシが厳しい上限となり、KubernetesにはPodを休止させるネイティブな仕組みがありません。数百万のアイドルエージェントを稼働中のPodとして放置すれば、実際のコンピュートリソースを使い切るずっと前に、Podの上限とコントロールプレーンのメモリが尽きてしまいます。よくある回避策は、Podを破棄し、ウェイクアップのたびに外部ストレージからエージェントの状態を再構築する方法です。これは確かに機能します。しかし、どのチームも同じ状態外部化の仕組みを一から作り直すことになり、再開のたびにコールドスタートのコストを全額支払うことになります。
Agent Substrateは異なるアプローチを取ります。アイドル状態のエージェントを一時停止し、RAMとローカルファイルをスナップショットとして保存し、エージェントが再び動く必要が生じた瞬間に、利用可能なサンドボックス上へ1秒未満でその状態を復元します。
注: Agent Substrateは開発初期段階にあり、本番環境での利用にはまだ対応していません。APIは変更される見込みで、後方互換性は保証されません。
Agent Substrateとは
Agent Substrateは、デフォルトでセキュアな設計のエージェント実行ランタイムです。標準的なコンテナランタイムの10倍の密度で数百万のサンドボックスを実行できるように設計されており、500ミリ秒未満での再開と、毎秒500件以上の一時停止/再開を処理できます。分離はデフォルトでgVisorが担い、より強固な境界を必要とするワークロード向けには、マイクロVMサンドボックスクラス(Kata Containers + Cloud Hypervisor)をオプションで利用できます。
中核となる考え方は**多重化(マルチプレクシング)**です。Substrateは、多数のアクター(エージェントのインスタンス)を、はるかに少数のワーカー(実際に実行を担うサンドボックス)のプールにマッピングします。エージェント型のワークロードは時間の大半をアイドル状態で過ごす、という前提に基づく設計です。
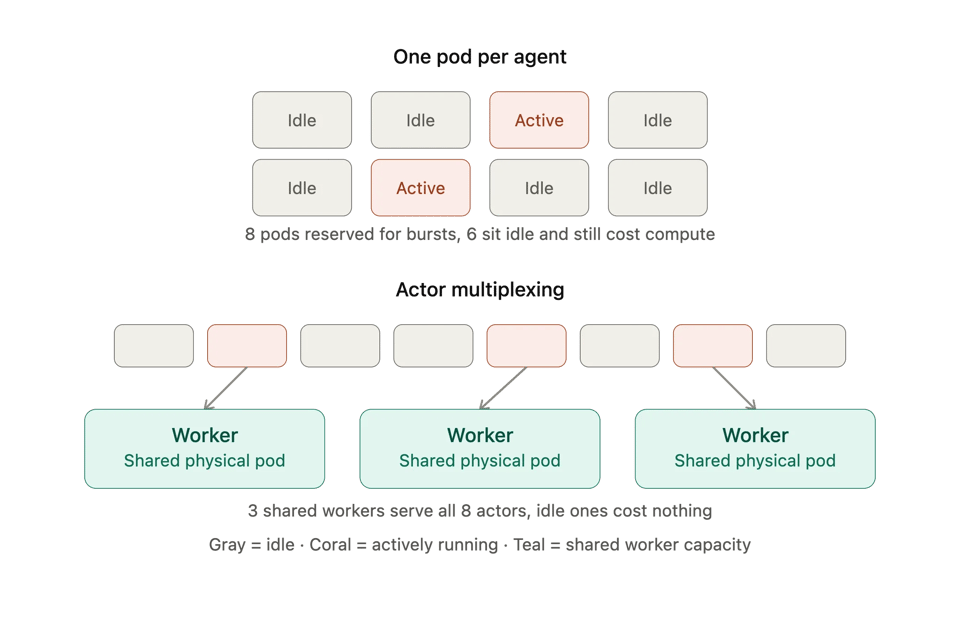
本題に入る前に、押さえておきたい用語がいくつかあります。
- アクター(Actor): 実行中のエージェントの1インスタンス
- ActorTemplate: 特定バージョンのアクターを作成するためのイミュータブルな設計図(コンテナイメージ、環境、スナップショットポリシー)
- ワーカー(Worker): アクティブなアクターが実行されるサンドボックスPod
- WorkerPool: アクターを受け入れる準備が整った、事前ウォームアップ済みワーカーの集まり
- Atespace: アクターとテンプレートが所属する、namespaceに似たグルーピング
これが1エージェント=1Podの構成よりはるかに高密度で動作できる理由は、SubstrateがKubernetesのコントロールプレーンをクリティカルパスから外しているためです。基盤となるPodのプロビジョニングと管理は引き続きKubernetesが行いますが、Substrateはすべての一時停止/再開サイクルをPodスケジューリング経由にはしません。それらはSubstrate自身のコントロールプレーンが直接処理します。アクターとワーカーのライフサイクルを担うateapi、WorkerPoolを調整するatecontroller、DNSとルーティングを担うatenet、そしてノードレベルのDaemonSetとして動作するateletです。
Agent Substrateは、標準的なOCIコンテナを生成するあらゆるフレームワークと連携できます。プロジェクトでは、Agent Development Kit、LangChain、Claude Codeとのインテグレーションパターンが紹介されています。Agent Substrate自体はエージェントフレームワークやSDKではなく、その下層を支える基盤(サブストレート)です。
この複雑さに見合う価値
信頼できないコードは、AI生成のものであれ単発のツール呼び出しであれ、カーネルとネットワークの分離環境の中で実行され、クラスタの他の部分を危険にさらしません。アクターの作業メモリとファイルは一時停止サイクルをまたいで保持されるため、最初からやり直すのではなく、停止した地点から正確に再開できます。復元は1秒に満たない速さのため、バースト的で人間と対話するエージェントでも応答レイテンシは許容範囲に収まります。そして、ウォームなワーカーの共有プールが多数のアクターを処理するため、アイドル状態のアクターが使っていないコンピュートに費用を払う必要がありません。
この組み合わせは、特定のワークロードによく適合します。数日にわたってコンテキストを保持しつつ短いバーストでしかアクティブにならないバックグラウンドアシスタントは、バースト間の一時停止によって節約効果の大半を得られます。信頼できないLLM生成コードを実行する使い捨てサンドボックスは、1秒未満の復元の恩恵を受けます。毎回フルコールドブートすることなく、起動し、タスクを実行し、解放できます。開発者とリアルタイムのやり取りを行うコーディングエージェントは、プロンプトの間もターミナルとファイルシステムの状態をそのまま保持しつつ、クラスタは実際にアクティブな開発者にだけコンピュートを費やします。
リクエストが実際に処理される流れ
テンプレートからアクターが作成されると、Substrateは一時的な「ゴールデンPod」を起動し、コンテナのスタートアップロジックを一度だけ実行し、初期化が完了した瞬間にゴールデンスナップショットを取得します。以降、そのテンプレートから作られるすべてのアクターは、コールドブートではなくこのスナップショットから再開します。そのため、コストの高い初期化処理(モデルのロード、ベースライン接続の確立など)は、ウェイクアップのたびに繰り返される場所ではなく、エントリーポイントに置くべきです。
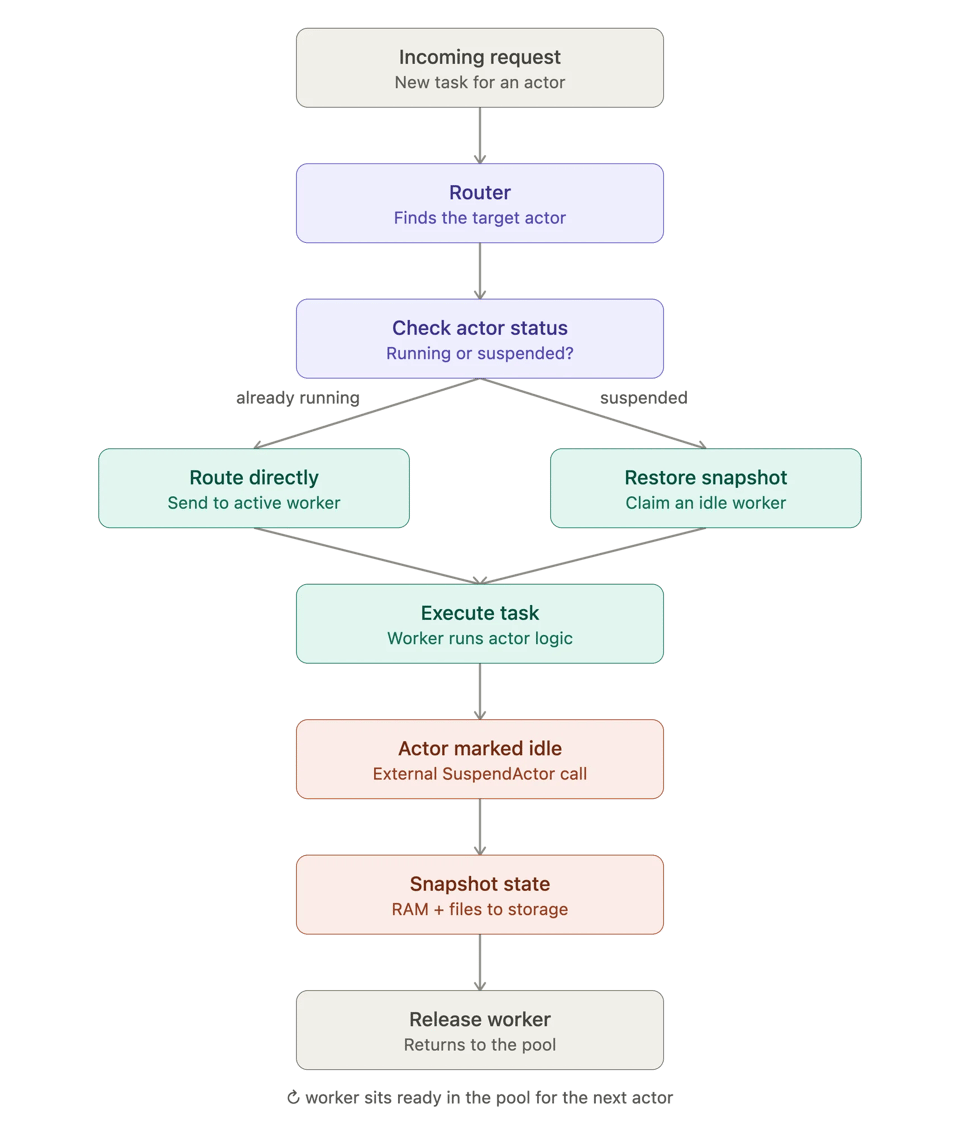
ひとつ注意点があります。Substrateは現時点でアイドル状態を自動検出しません。一時停止は、Substrateがアクティビティを監視して自ら判断するのではなく、アクターをオーケストレーションしているシステムからの明示的なAPI呼び出しによってトリガーされます。
設定方法:WorkerPoolとActorTemplate
Substrateのリソースはate.dev/v1alpha1 APIグループ配下のKubernetes CRDなので、通常のGitOpsフローにそのまま組み込めます。主な作業を担うのは2つのリソースです。
WorkerPoolは物理的なキャパシティを定義します。待機させておくウォームPodの数、使用するサンドボックスランタイム、ノード配置ルールなどです。
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.ActorTemplateはワークロードそのものを定義します。コンテナ、スナップショットの保存先、実行を許可するワーカープールなどです。
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/自分で書く前に知っておきたい細かい点がいくつかあります。コンテナイメージはダイジェストで固定する必要があります。イメージを変更すると既存のスナップショットが無効になるためです。readyzプローブは任意ですが、設定する価値があります。コールドブートと復元の両方を、ワークロードが単に起動しただけでなく、実際にトラフィックを処理できる状態になったことを条件にできるからです。また、エージェントの新しいバージョンごとに専用のActorTemplate(research-agent-v2など)を用意すべきです。Substrateはテンプレートを、その場で書き換えるものではなく、イミュータブルな状態のルートとして扱うためです。
テンプレートがReadyに達したら、CLIで論理的にアクターを作成します。
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agentすると、リクエストが到着した瞬間に、参照先プール内の空いている任意のワーカー上でアクターが再開されます。
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
詳細情報の入手先
APIが今なお変化し続けているシステムについては、ブログ記事の情報が最新であることに頼るのではなく、プロジェクト公式のドキュメントを参照して実際の設定を行うのが正解です。
- READMEとクイックスタート — Go、
kubectl、Docker以外に何も必要としない、ローカルのkindベースのセットアップを含みます - API設定ガイド —
WorkerPool、ActorTemplate、SandboxConfigの全フィールドリファレンス - アーキテクチャガイド — コントロールプレーン、ノードスーパーバイザー、ネットワークスタックがどう組み合わさっているかの解説
- デモディレクトリ — 実践例:ステートフルカウンター、サンドボックス化されたシェル環境、Claude Codeの多重化デモ、HPAで駆動するオートスケール対応ワーカープール
GKEで実行する場合
ここまでの内容はどのKubernetesクラスタでも動作します。インフラがGKEであれば、Googleがガイド付きの導入経路も用意しています。2026年9月11日時点で、GKE上のAgent Substrateは、評価および非本番用途に限りすべてのGoogle Cloudのお客様に開放されており、本番サポートは限定GAプログラムの許可リスト制となっています。
最も手軽なのは、ai-on-gke/substrate-gkeリポジトリにある単一のインストーラーを使う方法です。GKEクラスタのプロビジョニングまたは指定を対話形式で進めた後、Substrateに必要な設定を有効化し、コントロールプレーンをデプロイしてくれます。
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash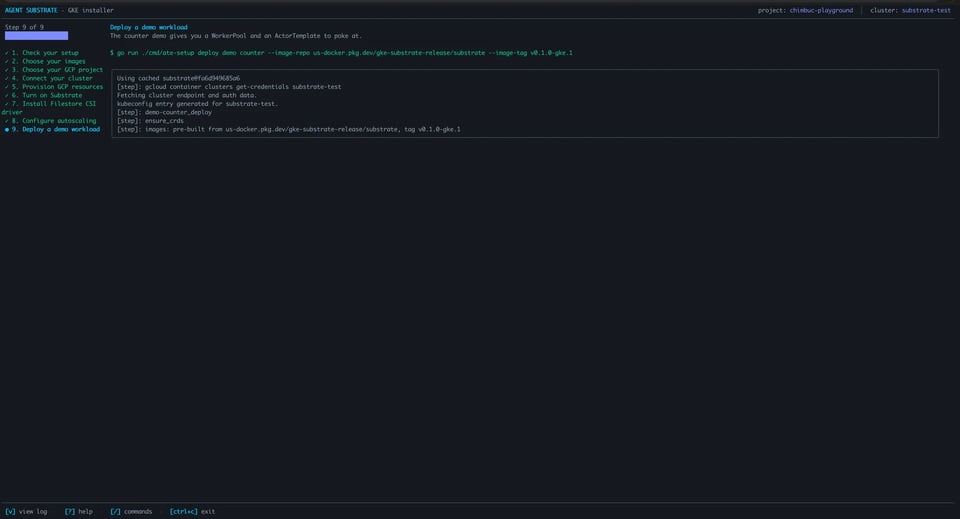
それ以降の手順は、Google公式のAgent Substrate on GKEドキュメントとインストールガイドでカバーされています。
この仕組みが生むコスト帰属の問題
数千のアクターを共有WorkerPoolに多重化することで、アイドルコンピュートの問題は解決します。しかし、別の問題が生まれます。標準的なコスト帰属が機能しなくなるのです。タグベースのFinOpsツールは、Podと、それがサービスを提供するチームや顧客との間に、ある程度安定したマッピングがあることを前提としています。アクターが一時停止され、たまたま空いていたワーカー上で再開され、他の数百のアクターとプールを共有するようになると、そのマッピングは失われます。また、共有WorkerPoolのコンピュート費用の明細を見ても、各アクターが呼び出すモデルやゲートウェイを通じて個別に発生させているLLMトークンの支出については何もわかりません。
DoiT Attribute™は、まさにこのギャップのために作られています。タグに頼るのではなく、eBPFセンサーで実行時にゲートウェイのトラフィックを読み取り、各推論呼び出しを、それをトリガーしたエージェント、機能、顧客まで遡って追跡します。その過程で、人間によるトラフィックと非人間(エージェント)のトラフィックも分離します。多数のSubstrateアクターを共有LLMゲートウェイに対して実行しているプラットフォームにとって、これは「AI支出の総額がわかる」状態と「どのアクター、顧客、機能が実際にその支出を生んでいるかがわかる」状態の違いを意味します。
おわりに
Agent Substrateが解決しようとしているのは、実在する問題です。エージェントのワークロードは時間の大半をアイドル状態で過ごしているのに、Kubernetesもクラウドの課金もそれを考慮していません。同時に、まだ本当に初期段階のプロジェクトでもあります。プロジェクト公式のドキュメントが本番利用には未対応と明記しており、APIは今後も変更が見込まれます。アイドル検出自体も、Substrateが代わりにやってくれるものではなく、自分で組み込む必要があります。
共有LLMゲートウェイに対して相応の規模で運用するなら、各アクターに実際いくらかかっているのかを把握することが、次にぶつかる課題になります。


