
Cloud Intelligence™
Seus agentes estão ociosos. Sua conta do Kubernetes, não.
O Kubernetes não tem o conceito nativo de um Pod adormecido. O Agent Substrate multiplexa milhares de agentes com estado em um pool compartilhado de workers, sem a penalidade de cold start.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal pageAgentes interativos, assistentes pessoais, agentes de programação e sandboxes de tool-calling passam a maior parte do tempo de execução esperando por um humano ou por um gatilho externo. Nesse intervalo, eles não estão fazendo nenhum processamento de verdade. No Kubernetes, esse tempo ocioso continua consumindo recursos reais — capacidade que poderia estar atendendo trabalho ativo.
O Kubernetes padrão vincula cada workload a um Pod dedicado. O throughput de agendamento de Pods e a latência de inicialização impõem um teto rígido, e o Kubernetes não tem o conceito nativo de hibernar um Pod. Mantenha milhões de agentes ociosos como Pods ativos e você vai esgotar os limites de Pods e a memória do control plane muito antes de esgotar a capacidade real de computação. A solução alternativa de sempre — destruir Pods e reconstruir o estado do agente a partir de armazenamento externo a cada despertar — funciona. Mas significa que cada equipe reconstrói a mesma infraestrutura de externalização de estado e paga o custo integral de cold start a cada retomada.
O Agent Substrate adota uma abordagem diferente: suspender agentes ociosos, tirar um snapshot da RAM e dos arquivos locais e restaurar esse estado em uma sandbox disponível em menos de um segundo, no momento em que o agente precisar agir de novo.
Observação: o Agent Substrate está em desenvolvimento inicial e não está pronto para uso em produção. As APIs devem mudar, e a compatibilidade retroativa não é garantida.
O que é o Agent Substrate
O Agent Substrate é um runtime de execução de agentes seguro por padrão, criado para rodar milhões de sandboxes com 10x a densidade dos runtimes de contêiner convencionais, com retomada em menos de 500 ms e mais de 500 ativações de suspensão/retomada por segundo. O isolamento vem do gVisor por padrão, com uma classe opcional de sandbox micro-VM (Kata Containers com Cloud Hypervisor) para workloads que precisam de um isolamento mais rígido.
A ideia central é a multiplexação. O Substrate mapeia um grande número de actors — suas instâncias de agente — em um pool bem menor de workers — as sandboxes que de fato os executam — partindo do pressuposto de que workloads do tipo agente passam a maior parte do tempo ociosas.
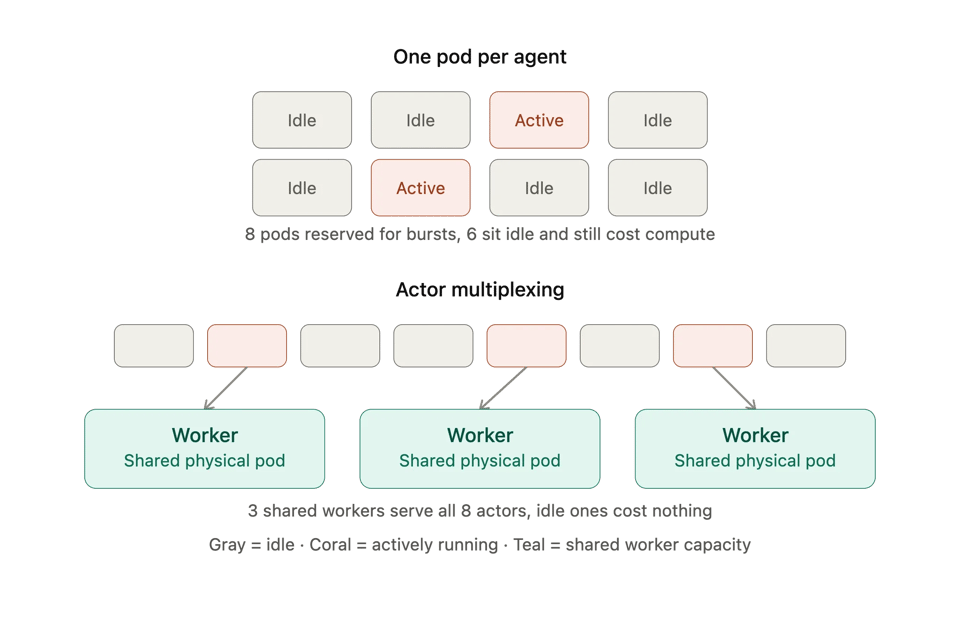
Alguns termos que vale conhecer antes que o resto faça sentido:
- Actor: uma instância em execução de um agente
- ActorTemplate: o blueprint imutável (imagem de contêiner, ambiente, política de snapshot) usado para criar actors de uma determinada versão
- Worker: o pod sandbox onde um actor ativo é executado
- WorkerPool: uma frota de workers pré-aquecidos prontos para receber um actor
- Atespace: um agrupamento semelhante a um namespace onde vivem actors e templates
O motivo de isso conseguir rodar com densidade muito maior do que um Pod por agente é que o Substrate tira o control plane do Kubernetes do caminho crítico. O Kubernetes continua provisionando e gerenciando os Pods subjacentes; o Substrate apenas não roteia cada ciclo de suspensão e retomada pelo agendamento de Pods. Seu próprio control plane cuida disso diretamente: ateapi para o ciclo de vida de actors e workers, atecontroller reconciliando WorkerPools, atenet para DNS e roteamento, atelet rodando como um DaemonSet no nível do nó.
O Agent Substrate funciona com qualquer framework que produza contêineres OCI padrão. O projeto lista padrões de integração para o Agent Development Kit, LangChain e Claude Code. Ele não é um framework de agentes nem um SDK em si, mas o substrato que fica por baixo de um.
Por que vale a complexidade
Código não confiável — seja gerado por IA ou uma chamada de ferramenta pontual — roda com isolamento de kernel e de rede sem expor o resto do cluster. A memória de trabalho e os arquivos de um actor persistem entre ciclos de suspensão, então ele retoma exatamente de onde parou em vez de começar do zero. A restauração é rápida o bastante — fração de segundo — para que a latência de resposta continue aceitável até para agentes com picos de uso e voltados a humanos. E como um pool compartilhado de workers aquecidos atende muitos actors, você não paga por computação que actors ociosos não estão usando.
Essa combinação atende bem a um conjunto específico de workloads. Assistentes em segundo plano que mantêm contexto por dias, mas só ficam ativos em rajadas curtas, obtêm a maior parte da economia suspendendo entre essas rajadas. Sandboxes descartáveis para executar código não confiável gerado por LLM se beneficiam da restauração em menos de um segundo: crie uma, execute a tarefa, libere-a, sem um cold boot completo a cada vez. Agentes de programação que mantêm um vai e vem em tempo real com um desenvolvedor preservam o estado do terminal e do sistema de arquivos entre prompts, enquanto o cluster só gasta computação com desenvolvedores realmente ativos.
Como uma requisição realmente flui pelo sistema
Quando um actor é criado a partir de um template, o Substrate sobe um "golden pod" temporário, executa a lógica de inicialização do seu contêiner uma única vez e tira um golden snapshot assim que ela é concluída. Todo actor subsequente daquele template retoma a partir desse snapshot em vez de inicializar a frio — por isso, inicializações caras (carregar um modelo, abrir conexões básicas) devem ficar no seu entry point, e não em algum lugar onde seriam repetidas a cada despertar.
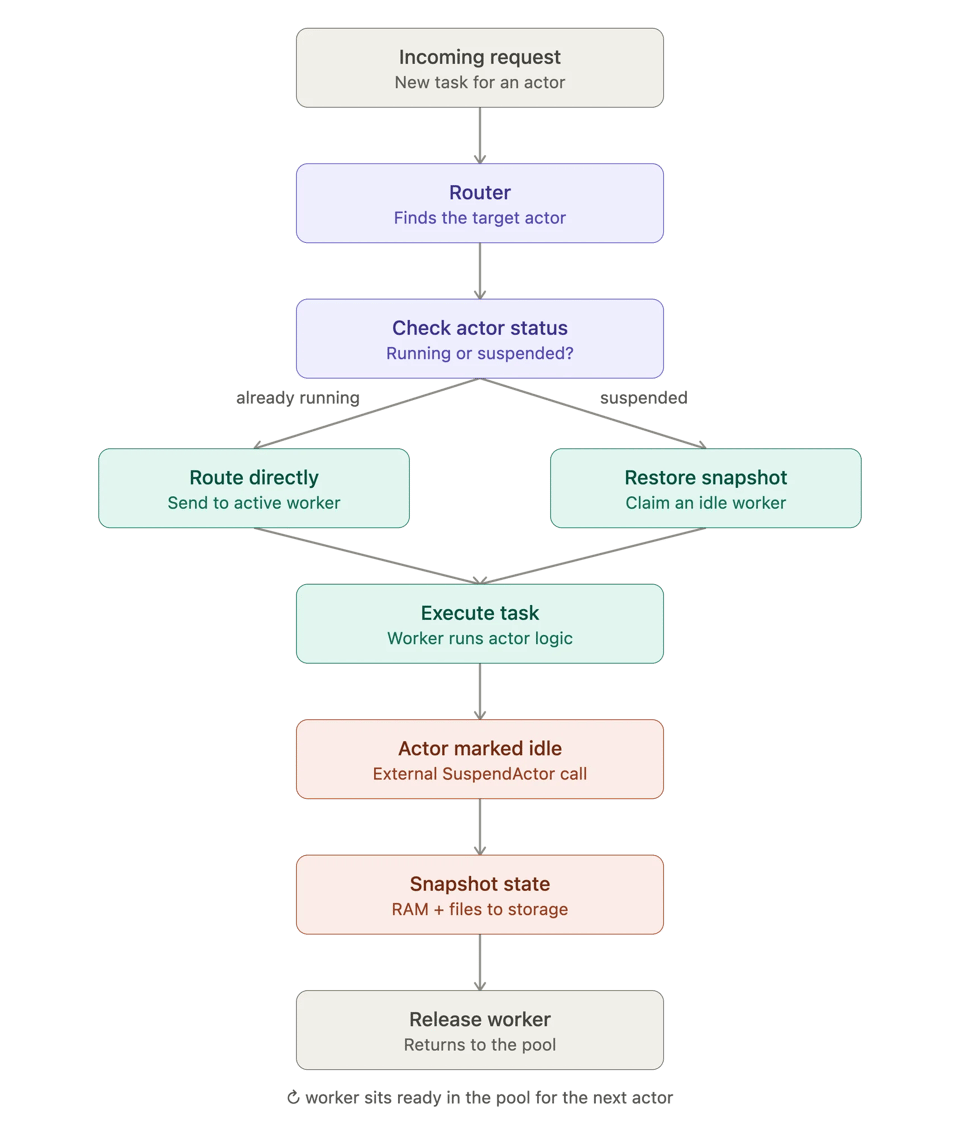
Uma ressalva que vale destacar: atualmente o Substrate não detecta ociosidade por conta própria. A suspensão é acionada por uma chamada de API explícita do sistema que estiver orquestrando os actors, não pelo Substrate observando a atividade e decidindo sozinho.
Configurando: WorkerPool e ActorTemplate
Os recursos do Substrate são CRDs do Kubernetes sob o grupo de API ate.dev/v1alpha1, então se encaixam em um fluxo GitOps normal. Dois recursos fazem a maior parte do trabalho.
Um WorkerPool define a capacidade física: quantos pods aquecidos manter em prontidão, qual runtime de sandbox eles usam e eventuais regras de posicionamento em nós.
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.Um ActorTemplate define a workload em si: seu contêiner, onde os snapshots são armazenados e em quais worker pools ele pode rodar.
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/Alguns detalhes que vale conhecer antes de escrever o seu. As imagens de contêiner precisam ser fixadas por digest, já que alterar a imagem invalida os snapshots existentes. O probe readyz é opcional, mas vale configurar: ele condiciona tanto o cold boot quanto a restauração a que sua workload esteja de fato pronta para atender tráfego, e não apenas iniciada. E cada nova versão do seu agente deve ter seu próprio ActorTemplate (research-agent-v2, e assim por diante), já que o Substrate trata um template como uma raiz de estado imutável, e não como algo que você modifica diretamente.
Quando o template chega ao estado Ready, você cria um actor de forma lógica com a CLI:
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agente ele retoma em qualquer worker livre do pool referenciado assim que uma requisição chegar.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Onde encontrar os detalhes
A documentação do próprio projeto é o lugar certo para configurar isso para valer, em vez de confiar que um post de blog se mantenha atualizado com um sistema cujas APIs, declaradamente, ainda estão em evolução:
- README e quickstart, incluindo uma configuração local baseada em
kindque não exige nada além de Go,kubectle Docker - Guia de configuração da API com a referência completa dos campos de
WorkerPool,ActorTemplateeSandboxConfig - Guia de arquitetura para entender como o control plane, o supervisor de nó e a stack de rede se encaixam
- Diretório de demos com exemplos práticos: um contador com estado, um ambiente de shell em sandbox, uma demo de multiplexação com o Claude Code e um worker pool com autoescala controlado por um HPA
Executando especificamente no GKE
Tudo o que foi descrito acima funciona em qualquer cluster Kubernetes. Se a sua infraestrutura for GKE, o Google também criou um caminho guiado para isso. Desde 11/09/2026, o Agent Substrate no GKE está aberto a todos os clientes do Google Cloud para avaliação e uso fora de produção, com suporte a produção condicionado a uma allowlist dentro de um programa de GA limitado.
O caminho mais rápido é um instalador único no repositório ai-on-gke/substrate-gke. Ele orienta você a provisionar ou apontar para um cluster GKE, depois habilita as configurações de que o Substrate precisa e implanta o control plane nele.
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash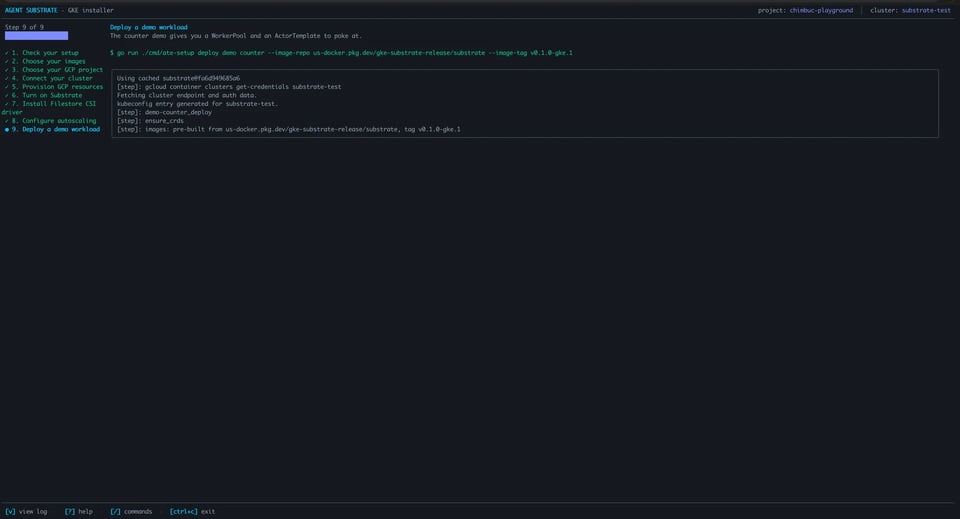
A própria documentação do Agent Substrate no GKE do Google e o guia de instalação cobrem o restante.
O problema de atribuição de custos que isso cria
Multiplexar milhares de actors em um WorkerPool compartilhado resolve o problema da computação ociosa. E cria outro: a atribuição de custos tradicional deixa de funcionar. Ferramentas de FinOps baseadas em tags assumem um mapeamento razoavelmente estável entre um Pod e a equipe ou o cliente que ele atende. Quando os actors passam a ser suspensos, retomados em qualquer worker que estiver livre e a compartilhar um pool com centenas de outros actors, esse mapeamento desaparece. A linha de custo de computação de um WorkerPool compartilhado também não diz nada sobre o gasto com tokens de LLM que cada actor gera individualmente pelo modelo ou gateway que ele chama.
O DoiT Attribute™ foi criado exatamente para essa lacuna. Ele lê o tráfego do gateway em tempo de execução com um sensor eBPF, em vez de depender de tags, e rastreia cada chamada de inferência até o agente, a funcionalidade ou o cliente que a acionou, separando no processo o tráfego humano do tráfego não humano (de agentes). Para uma plataforma que executa grandes volumes de actors do Substrate usando gateways de LLM compartilhados, essa é a diferença entre conhecer o gasto agregado com IA e saber qual actor, cliente ou funcionalidade está de fato gerando esse gasto.
Considerações finais
O Agent Substrate resolve um problema real: workloads de agentes ficam ociosas a maior parte do tempo, e nem o Kubernetes nem a cobrança da nuvem levam isso em conta. Ele também está genuinamente no começo. A documentação do próprio projeto o descreve como não pronto para uso em produção, e as APIs devem continuar mudando; a detecção de ociosidade em si ainda é algo que você mesmo precisa implementar, não algo que o Substrate faz por você.
Se você estiver rodando isso com gateways de LLM compartilhados em qualquer volume real, saber quanto cada actor realmente custa é o próximo problema que vai encontrar.


