
Cloud Intelligence™
Vos agents sont inactifs. Pas votre facture Kubernetes.
Kubernetes n'a aucun concept natif de Pod en veille. Agent Substrate multiplexe des milliers d'agents avec état sur un pool de workers partagé, sans pénalité de démarrage à froid.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal pageLes agents interactifs, assistants personnels, agents de codage et sandboxes d'appels d'outils passent la majeure partie de leur temps d'exécution à attendre un humain ou un déclencheur externe. Pendant cette fenêtre, ils n'effectuent aucun calcul réel. Sur Kubernetes, ce temps d'inactivité consomme pourtant de vraies ressources — une capacité qui pourrait servir des workloads actifs.
En standard, Kubernetes associe chaque workload à un Pod dédié. Le débit de scheduling des Pods et la latence de démarrage imposent un plafond strict, et Kubernetes n'a aucun concept natif d'hibernation d'un Pod. Si vous conservez des millions d'agents inactifs sous forme de Pods actifs, vous épuiserez les limites de Pods et la mémoire du control plane bien avant d'épuiser le calcul réel. Le contournement habituel — détruire les Pods et reconstruire l'état de l'agent depuis un stockage externe à chaque réveil — fonctionne. Mais cela signifie que chaque équipe reconstruit la même plomberie d'externalisation d'état et paie le coût complet d'un démarrage à froid à chaque reprise.
Agent Substrate adopte une approche différente : suspendre les agents inactifs, capturer un snapshot de leur RAM et de leurs fichiers locaux, puis restaurer cet état sur une sandbox disponible en moins d'une seconde dès que l'agent doit agir à nouveau.
Remarque : Agent Substrate en est à un stade précoce de développement et n'est pas prêt pour un usage en production. Les API sont amenées à évoluer et la rétrocompatibilité n'est pas garantie.
Qu'est-ce qu'Agent Substrate ?
Agent Substrate est un runtime d'exécution d'agents sécurisé par défaut, conçu pour faire tourner des millions de sandboxes à une densité 10 fois supérieure à celle des runtimes de conteneurs standard, avec une reprise en moins de 500 ms et plus de 500 activations suspend/resume par seconde. L'isolation repose sur gVisor par défaut, avec une classe de sandbox micro-VM optionnelle (Kata Containers plus Cloud Hypervisor) pour les workloads qui exigent une isolation renforcée.
L'idée centrale est le multiplexage. Substrate mappe un grand nombre d'acteurs — vos instances d'agents — sur un pool bien plus réduit de workers, les sandboxes qui les exécutent réellement, en partant du principe que les workloads de type agent passent la majeure partie de leur temps inactifs.
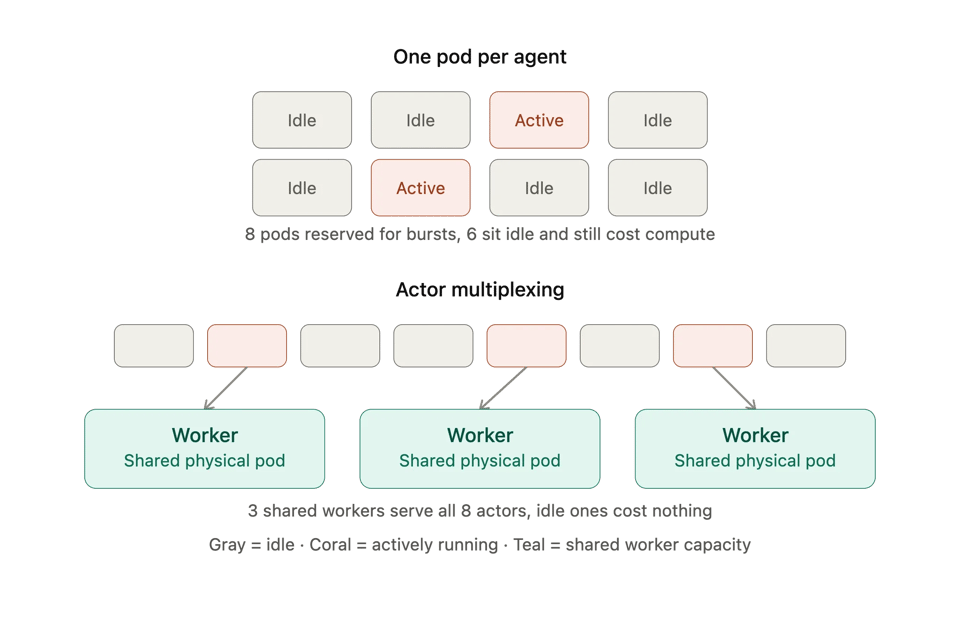
Quelques termes à connaître avant d'aller plus loin :
- Actor : une instance en cours d'exécution d'un agent
- ActorTemplate : le plan immuable (image de conteneur, environnement, politique de snapshot) utilisé pour créer les acteurs d'une version donnée
- Worker : le pod sandbox où s'exécute un acteur actif
- WorkerPool : une flotte de workers préchauffés prêts à recevoir un acteur
- Atespace : un regroupement de type namespace dans lequel vivent acteurs et templates
Si cette approche atteint une densité bien supérieure au modèle d'un Pod par agent, c'est parce que Substrate retire le control plane Kubernetes du chemin critique. Kubernetes continue de provisionner et de gérer les Pods sous-jacents ; Substrate ne fait simplement pas transiter chaque cycle de suspension et de reprise par le scheduling des Pods. Son propre control plane s'en charge directement : ateapi pour le cycle de vie des acteurs et des workers, atecontroller pour la réconciliation des WorkerPools, atenet pour le DNS et le routage, atelet exécuté en DaemonSet au niveau des nœuds.
Agent Substrate fonctionne avec tout framework produisant des conteneurs OCI standard. Le projet documente des patterns d'intégration pour l'Agent Development Kit, LangChain et Claude Code. Ce n'est ni un framework d'agents ni un SDK en soi, mais le substrat qui les sous-tend.
Pourquoi cette complexité en vaut la peine
Le code non fiable, qu'il soit généré par une IA ou issu d'un appel d'outil ponctuel, s'exécute dans une isolation kernel et réseau sans exposer le reste du cluster. La mémoire de travail et les fichiers d'un acteur persistent à travers les cycles de suspension : il reprend exactement là où il s'était arrêté au lieu de repartir de zéro. La restauration est assez rapide — une fraction de seconde — pour que la latence de réponse reste acceptable, même pour des agents à activité sporadique en interaction directe avec des humains. Et comme un pool partagé de workers préchauffés sert de nombreux acteurs, vous ne payez pas pour du calcul que les acteurs inactifs n'utilisent pas.
Cette combinaison convient particulièrement bien à certains workloads. Les assistants d'arrière-plan qui conservent du contexte pendant des jours mais ne sont actifs que par courtes rafales tirent l'essentiel de leurs économies de la suspension entre ces rafales. Les sandboxes jetables destinées à exécuter du code non fiable généré par un LLM profitent de la restauration en moins d'une seconde : en lancer une, exécuter la tâche, la libérer, sans démarrage à froid complet à chaque fois. Les agents de codage qui entretiennent un échange en temps réel avec un développeur conservent l'état de leur terminal et de leur système de fichiers entre deux prompts, tandis que le cluster ne dépense du calcul que pour les développeurs réellement actifs.
Le parcours concret d'une requête
Lorsqu'un acteur est créé à partir d'un template, Substrate démarre un golden pod temporaire, exécute une fois la logique de démarrage de votre conteneur et capture un golden snapshot dès la fin de l'initialisation. Chaque acteur ultérieur de ce template reprend depuis ce snapshot plutôt que de démarrer à froid : c'est pourquoi les initialisations coûteuses (chargement d'un modèle, ouverture des connexions de base) ont leur place dans votre point d'entrée, plutôt qu'à un endroit où elles seraient répétées à chaque réveil.
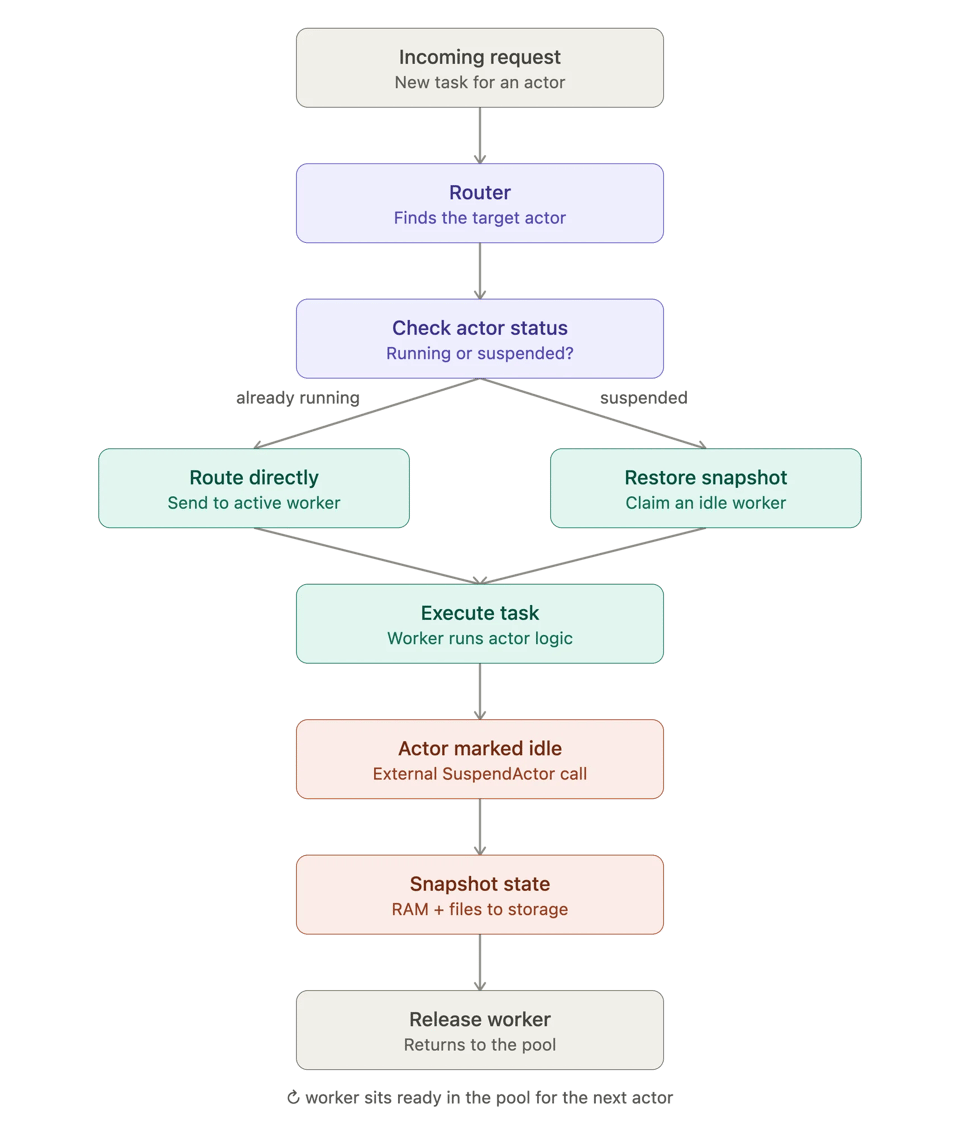
Un point d'attention à signaler : Substrate ne détecte pas encore l'inactivité par lui-même. La suspension est déclenchée par un appel API explicite du système qui orchestre les acteurs, et non par Substrate qui observerait l'activité et déciderait seul.
Configuration : WorkerPool et ActorTemplate
Les ressources Substrate sont des CRD Kubernetes sous le groupe d'API ate.dev/v1alpha1 et s'intègrent donc dans un flux GitOps classique. Deux ressources font l'essentiel du travail.
Un WorkerPool définit la capacité physique : combien de pods préchauffés maintenir en attente, quel runtime de sandbox ils utilisent, et d'éventuelles règles de placement sur les nœuds.
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.Un ActorTemplate définit le workload lui-même : son conteneur, l'emplacement de stockage des snapshots et les pools de workers sur lesquels il est autorisé à s'exécuter.
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/Quelques détails à connaître avant d'écrire vos propres ressources. Les images de conteneurs doivent être épinglées par digest, car changer d'image invalide les snapshots existants. La sonde readyz est optionnelle mais mérite d'être définie : elle conditionne aussi bien le démarrage à froid que la restauration au fait que votre workload soit réellement prêt à servir du trafic, et pas seulement démarré. Et chaque nouvelle version de votre agent devrait avoir son propre ActorTemplate (research-agent-v2, et ainsi de suite), puisque Substrate traite un template comme une racine d'état immuable plutôt que comme un objet à modifier en place.
Une fois le template passé à l'état Ready, vous créez logiquement un acteur avec la CLI :
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agentet il reprend sur n'importe quel worker libre du pool référencé dès qu'une requête arrive.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Où trouver les détails
La documentation du projet reste la référence pour une mise en place réelle, plutôt que de compter sur un article de blog pour suivre un système dont les API, de l'aveu même du projet, évoluent encore :
- README et guide de démarrage rapide, incluant une installation locale basée sur
kindqui ne nécessite rien de plus que Go,kubectlet Docker - Guide de configuration des API pour la référence complète des champs
WorkerPool,ActorTemplateetSandboxConfig - Guide d'architecture pour comprendre comment s'articulent le control plane, le superviseur de nœud et la pile réseau
- Répertoire de démos pour des exemples concrets : un compteur avec état, un environnement shell en sandbox, une démo de multiplexage Claude Code et un pool de workers autoscalé piloté par un HPA
Le cas particulier de GKE
Tout ce qui précède fonctionne sur n'importe quel cluster Kubernetes. Si votre infrastructure repose sur GKE, Google a aussi construit un parcours guidé. Depuis le 11 septembre 2026, Agent Substrate sur GKE est ouvert à tous les clients Google Cloud pour l'évaluation et les usages hors production, le support en production étant réservé à une liste d'accès dans le cadre d'un programme GA limité.
Le chemin le plus rapide est un script d'installation unique dans le dépôt ai-on-gke/substrate-gke. Il vous guide dans le provisionnement ou le ciblage d'un cluster GKE, puis active les configurations requises par Substrate et y déploie le control plane.
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash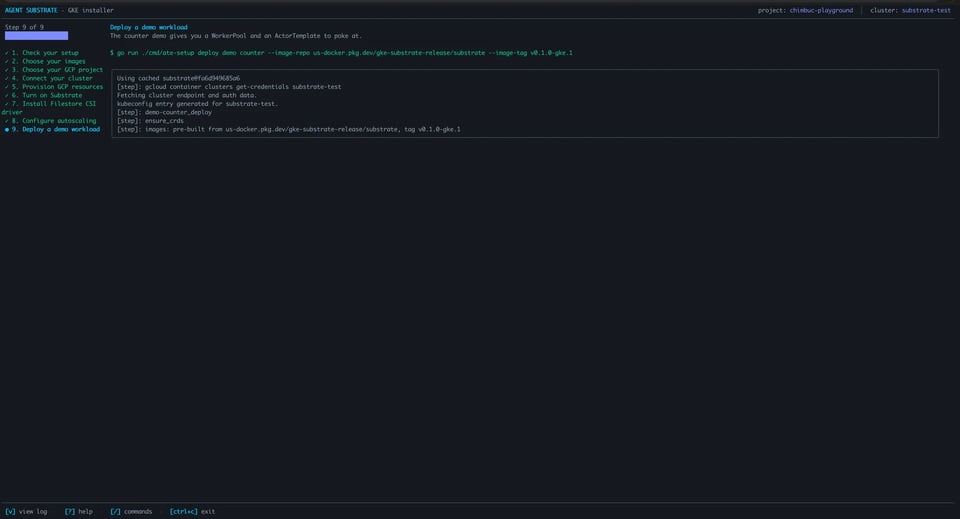
La documentation Agent Substrate sur GKE de Google et son guide d'installation couvrent le reste.
Le problème d'attribution des coûts que cela crée
Multiplexer des milliers d'acteurs sur un WorkerPool partagé résout le problème du calcul inactif. Mais cela en crée un autre : l'attribution des coûts standard cesse de fonctionner. L'outillage FinOps basé sur les tags suppose un mapping raisonnablement stable entre un Pod et l'équipe ou le client qu'il sert. Dès lors que les acteurs sont suspendus, repris sur le premier worker disponible et partagent un pool avec des centaines d'autres acteurs, ce mapping disparaît. La ligne de coût compute d'un WorkerPool partagé ne dit par ailleurs rien de la dépense en tokens LLM que chaque acteur génère individuellement via le modèle ou la gateway qu'il appelle.
DoiT Attribute™ est conçu pour combler précisément cette lacune. Il lit le trafic des gateways à l'exécution grâce à un capteur eBPF plutôt que de s'appuyer sur des tags, et retrace chaque appel d'inférence jusqu'à l'agent, la fonctionnalité ou le client qui l'a déclenché, en séparant au passage le trafic humain du trafic non humain (agents). Pour une plateforme qui exécute un grand nombre d'acteurs Substrate sur des gateways LLM partagées, c'est la différence entre connaître votre dépense IA globale et savoir quel acteur, quel client ou quelle fonctionnalité la génère réellement.
En conclusion
Agent Substrate s'attaque à un vrai problème : les workloads d'agents restent inactifs la plupart du temps, et ni Kubernetes ni la facturation cloud n'en tiennent compte. Le projet en est aussi véritablement à ses débuts. Sa propre documentation le décrit comme non prêt pour la production, et les API vont continuer d'évoluer ; la détection d'inactivité elle-même reste à votre charge, ce n'est pas quelque chose que Substrate fait pour vous.
Si vous l'exécutez sur des gateways LLM partagées à un volume significatif, savoir ce que coûte réellement chaque acteur est le prochain problème que vous rencontrerez.


