
Cloud Intelligence™
Tus agentes están inactivos. Tu factura de Kubernetes, no.
Kubernetes no tiene un concepto nativo de Pod en reposo. Agent Substrate multiplexa miles de agentes con estado en un pool compartido de workers, sin la penalización del cold start.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal pageLos agentes interactivos, los asistentes personales, los agentes de código y los sandboxes de tool-calling pasan la mayor parte de su tiempo de ejecución esperando a un humano o a un disparador externo. En esa ventana no realizan ningún cómputo real. En Kubernetes, ese tiempo inactivo sigue consumiendo recursos reales: capacidad que podría estar atendiendo trabajo activo.
Kubernetes estándar asocia cada workload a un Pod dedicado. El throughput de scheduling de Pods y la latencia de arranque imponen un límite estricto, y Kubernetes no tiene un concepto nativo de hibernar un Pod. Si mantienes millones de agentes inactivos como Pods vivos, agotarás los límites de Pods y la memoria del control plane mucho antes de agotar el cómputo real. La solución habitual —destruir los Pods y reconstruir el estado del agente desde almacenamiento externo cada vez que despierta— funciona. Pero implica que cada equipo reconstruye la misma infraestructura para externalizar el estado y paga el costo completo de un cold start en cada reanudación.
Agent Substrate adopta un enfoque distinto: suspender los agentes inactivos, capturar un snapshot de su RAM y sus archivos locales, y restaurar ese estado en un sandbox disponible en menos de un segundo en cuanto el agente necesita actuar de nuevo.
Nota: Agent Substrate está en una etapa temprana de desarrollo y no está listo para uso en producción. Se espera que las APIs cambien y no se garantiza la retrocompatibilidad.
Qué es Agent Substrate
Agent Substrate es un runtime de ejecución de agentes seguro por defecto, diseñado para ejecutar millones de sandboxes con 10 veces la densidad de los runtimes de contenedores estándar, con reanudación en menos de 500 ms y más de 500 activaciones de suspensión/reanudación por segundo. El aislamiento lo proporciona gVisor de forma predeterminada, con una clase de sandbox opcional de micro-VM (Kata Containers más Cloud Hypervisor) para workloads que necesitan un aislamiento más estricto.
La idea central es el multiplexado. Substrate asigna una gran cantidad de actores —tus instancias de agentes— a un pool mucho más pequeño de workers —los sandboxes que realmente los ejecutan—, bajo el supuesto de que los workloads tipo agente pasan la mayor parte del tiempo inactivos.
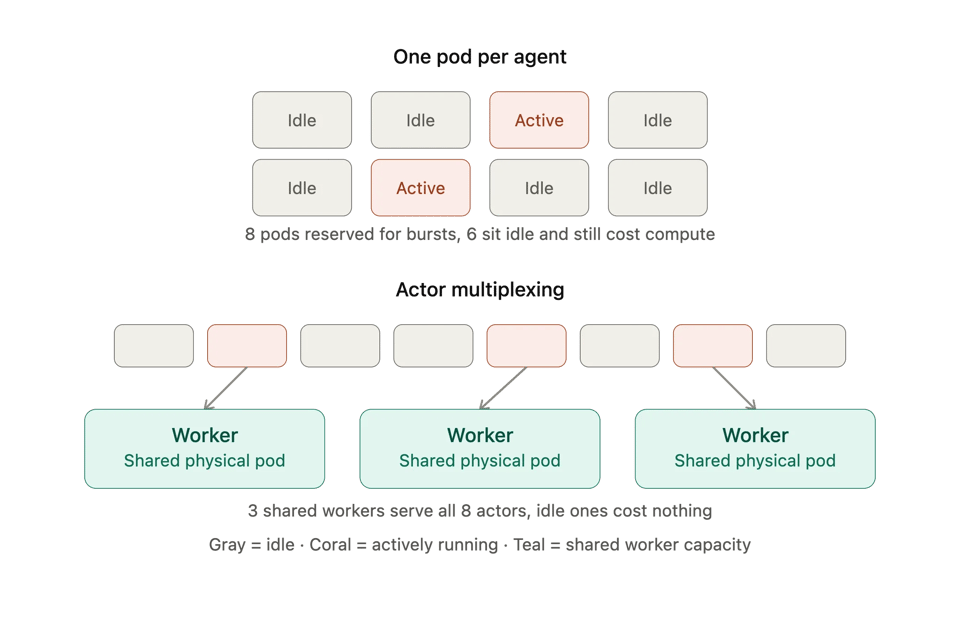
Algunos términos que conviene conocer antes de que todo lo demás encaje:
- Actor: una instancia en ejecución de un agente
- ActorTemplate: el modelo inmutable (imagen de contenedor, entorno, política de snapshots) que se usa para crear actores de una versión determinada
- Worker: el pod sandbox donde se ejecuta un actor activo
- WorkerPool: una flota de workers precalentados listos para recibir un actor
- Atespace: una agrupación similar a un namespace donde viven los actores y las plantillas
La razón por la que esto puede funcionar con mucha más densidad que un Pod por agente es que Substrate saca al control plane de Kubernetes de la ruta crítica. Kubernetes sigue aprovisionando y gestionando los Pods subyacentes; Substrate simplemente no enruta cada ciclo de suspensión y reanudación por el scheduling de Pods. Su propio control plane lo maneja directamente: ateapi para el ciclo de vida de actores y workers, atecontroller reconciliando WorkerPools, atenet para DNS y enrutamiento, atelet ejecutándose como un DaemonSet a nivel de nodo.
Agent Substrate funciona con cualquier framework que produzca contenedores OCI estándar. El proyecto lista patrones de integración para Agent Development Kit, LangChain y Claude Code. No es un framework de agentes ni un SDK en sí mismo, sino el sustrato sobre el que se apoya uno.
Por qué vale la pena la complejidad
El código no confiable, ya sea generado por IA o una llamada puntual a una herramienta, se ejecuta dentro de un aislamiento de kernel y de red sin exponer el resto del clúster. La memoria de trabajo y los archivos de un actor persisten a través de los ciclos de suspensión, así que se reanuda exactamente donde se pausó en lugar de empezar de cero. La restauración es lo bastante rápida —una fracción de segundo— como para que la latencia de respuesta se mantenga aceptable incluso en agentes intermitentes que interactúan directamente con personas. Y como un pool compartido de workers precalentados atiende a muchos actores, no pagas por cómputo que los actores inactivos no están usando.
Esa combinación encaja bien con un conjunto específico de workloads. Los asistentes en segundo plano que mantienen contexto durante días pero solo están activos en ráfagas cortas obtienen la mayor parte de su ahorro al suspenderse entre esas ráfagas. Los sandboxes desechables para ejecutar código no confiable generado por LLMs se benefician de la restauración en menos de un segundo: levantas uno, ejecutas la tarea y lo liberas, sin un arranque en frío completo cada vez. Los agentes de código que mantienen un intercambio en tiempo real con un desarrollador conservan intacto el estado de su terminal y su sistema de archivos entre prompts, mientras el clúster solo gasta cómputo en los desarrolladores que realmente están activos.
Cómo fluye realmente una solicitud
Cuando se crea un actor a partir de una plantilla, Substrate levanta un "golden pod" temporal, ejecuta la lógica de arranque de tu contenedor una sola vez y toma un golden snapshot en cuanto queda inicializado. Cada actor posterior de esa plantilla se reanuda desde ese snapshot en lugar de arrancar en frío, y por eso la inicialización costosa (cargar un modelo, abrir conexiones base) debe ir en tu punto de entrada y no en un lugar donde se repita en cada reactivación.
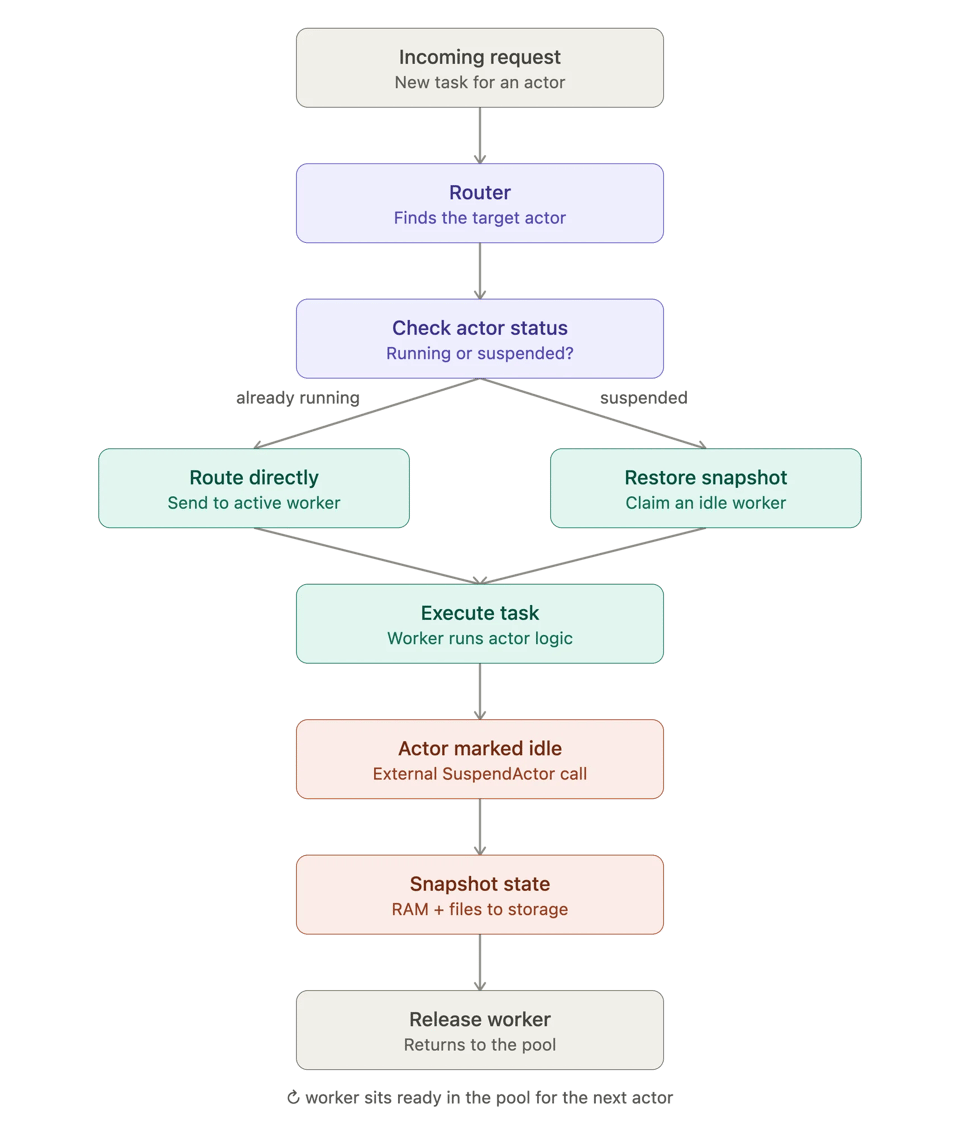
Una salvedad que vale la pena señalar: por ahora Substrate no detecta la inactividad por sí solo. La suspensión se activa mediante una llamada explícita a la API desde el sistema que orquesta los actores, no porque Substrate observe la actividad y decida por su cuenta.
Cómo configurarlo: WorkerPool y ActorTemplate
Los recursos de Substrate son CRDs de Kubernetes bajo el grupo de API ate.dev/v1alpha1, así que encajan en un flujo GitOps normal. Dos recursos hacen la mayor parte del trabajo.
Un WorkerPool define la capacidad física: cuántos pods precalentados mantener en espera, qué runtime de sandbox usan y las reglas de ubicación en los nodos.
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.Un ActorTemplate define el workload en sí: su contenedor, dónde se almacenan los snapshots y en qué worker pools puede ejecutarse.
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/Algunos detalles que conviene conocer antes de escribir el tuyo. Las imágenes de contenedor deben fijarse por digest, ya que cambiar la imagen invalida los snapshots existentes. La probe readyz es opcional pero vale la pena configurarla: condiciona tanto el arranque en frío como la restauración a que tu workload esté realmente listo para atender tráfico, no solo a que haya arrancado. Y cada nueva versión de tu agente debería tener su propio ActorTemplate (research-agent-v2, y así sucesivamente), ya que Substrate trata una plantilla como una raíz de estado inmutable y no como algo que se modifica directamente.
Una vez que la plantilla llega a Ready, creas un actor de forma lógica con la CLI:
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agenty se reanuda en cualquier worker libre del pool referenciado en cuanto llega una solicitud.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Dónde encontrar los detalles
La documentación del propio proyecto es el lugar correcto para configurar esto en serio, en lugar de confiar en que una publicación de blog se mantenga al día con un sistema cuyas APIs, según el propio proyecto, siguen en evolución:
- README y quickstart, que incluye una configuración local basada en
kindque no necesita nada más allá de Go,kubectly Docker - Guía de configuración de la API con la referencia completa de campos de
WorkerPool,ActorTemplateySandboxConfig - Guía de arquitectura para entender cómo encajan el control plane, el supervisor de nodo y la pila de red
- Directorio de demos con ejemplos completos: un contador con estado, un entorno de shell aislado en sandbox, una demo de multiplexado con Claude Code y un worker pool con autoescalado dirigido por un HPA
Cómo ejecutarlo específicamente en GKE
Todo lo anterior funciona en cualquier clúster de Kubernetes. Si tu infraestructura corre en GKE, Google también ofrece una ruta de adopción guiada. Desde el 11 de septiembre de 2026, Agent Substrate en GKE está abierto a todos los clientes de Google Cloud para evaluación y uso no productivo, con el soporte de producción restringido mediante una lista de acceso dentro de un programa limitado de GA.
El camino más rápido es un único instalador en el repositorio ai-on-gke/substrate-gke. Te guía para aprovisionar o apuntar a un clúster de GKE, y luego habilita las configuraciones que Substrate necesita y despliega el control plane sobre él.
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash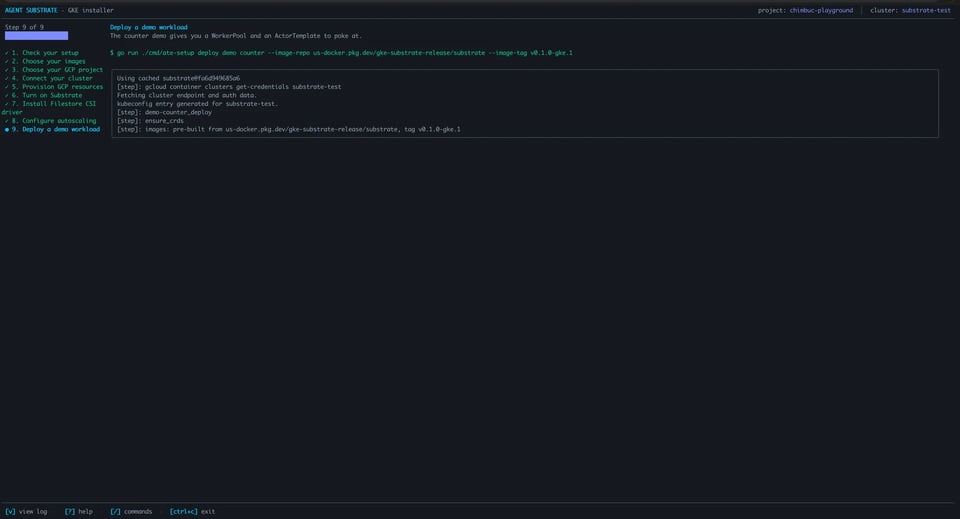
La propia documentación de Agent Substrate en GKE de Google y su guía de instalación cubren el resto.
El problema de atribución de costos que esto crea
Multiplexar miles de actores en un WorkerPool compartido resuelve el problema del cómputo inactivo. Y crea uno distinto: la atribución de costos estándar deja de funcionar. Las herramientas de FinOps basadas en etiquetas asumen un mapeo razonablemente estable entre un Pod y el equipo o cliente al que sirve. Una vez que los actores se suspenden, se reanudan en cualquier worker que esté libre y comparten un pool con cientos de otros actores, ese mapeo desaparece. La línea de cómputo de un WorkerPool compartido tampoco te dice nada sobre el gasto en tokens de LLM que cada actor genera individualmente a través del modelo o gateway que invoque.
DoiT Attribute™ está diseñado precisamente para cubrir ese vacío. Lee el tráfico del gateway en tiempo de ejecución con un sensor eBPF en lugar de depender de etiquetas, y rastrea cada llamada de inferencia hasta el agente, la funcionalidad o el cliente que la disparó, separando en el proceso el tráfico humano del tráfico no humano (de agentes). Para una plataforma que ejecuta grandes cantidades de actores de Substrate contra gateways de LLM compartidos, esa es la diferencia entre conocer tu gasto agregado en IA y saber qué actor, cliente o funcionalidad lo está generando realmente.
Comentarios finales
Agent Substrate resuelve un problema real: los workloads de agentes pasan inactivos la mayor parte del tiempo, y ni Kubernetes ni la facturación de la nube lo contemplan. También está en una etapa realmente temprana. Su propia documentación lo describe como no listo para uso en producción y se espera que las APIs sigan cambiando; la detección de inactividad es algo que todavía tienes que conectar tú mismo, no algo que Substrate haga por ti.
Si lo ejecutas contra gateways de LLM compartidos con un volumen real, el siguiente problema con el que te toparás es saber cuánto cuesta realmente cada actor.


