
Cloud Intelligence™
Ihre Agenten machen Pause. Ihre Kubernetes-Rechnung nicht.
Kubernetes kennt kein natives Konzept eines schlafenden Pods. Agent Substrate multiplext Tausende zustandsbehafteter Agenten auf einen gemeinsamen Worker-Pool – ganz ohne Cold-Start-Kosten.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal pageInteraktive Agenten, persönliche Assistenten, Coding-Agenten und Tool-Calling-Sandboxes verbringen den Großteil ihrer Laufzeit damit, auf einen Menschen oder einen externen Trigger zu warten. Echte Rechenarbeit findet in diesem Zeitfenster nicht statt. Auf Kubernetes kostet diese Leerlaufzeit trotzdem reale Ressourcen – Kapazität, die sonst aktive Workloads bedienen könnte.
Standard-Kubernetes bindet jeden Workload an einen eigenen Pod. Der Scheduling-Durchsatz und die Startlatenz von Pods setzen eine harte Obergrenze, und Kubernetes kennt kein natives Konzept, um einen Pod in den Ruhezustand zu versetzen. Wer Millionen inaktiver Agenten als laufende Pods parkt, erschöpft Pod-Limits und Control-Plane-Speicher, lange bevor die eigentliche Rechenleistung ausgereizt ist. Der übliche Workaround – Pods abbauen und den Agenten-Zustand bei jedem Aufwachen aus externem Storage rekonstruieren – funktioniert. Er bedeutet aber, dass jedes Team dieselbe Mechanik zur State-Externalisierung neu baut und bei jedem Fortsetzen den vollen Cold-Start-Preis zahlt.
Agent Substrate verfolgt einen anderen Ansatz: Inaktive Agenten werden pausiert, ihr RAM und ihre lokalen Dateien als Snapshot gesichert – und dieser Zustand wird in unter einer Sekunde auf eine verfügbare Sandbox zurückgespielt, sobald der Agent wieder aktiv werden muss.
Hinweis: Agent Substrate befindet sich in einer frühen Entwicklungsphase und ist nicht für den Produktiveinsatz geeignet. Änderungen an den APIs sind zu erwarten, Abwärtskompatibilität ist nicht garantiert.
Was Agent Substrate ist
Agent Substrate ist eine standardmäßig abgesicherte Agent-Execution-Runtime, ausgelegt auf Millionen von Sandboxes mit der zehnfachen Dichte gängiger Container-Runtimes – bei einer Resume-Zeit von unter 500 ms und über 500 Suspend/Resume-Aktivierungen pro Sekunde. Die Isolation übernimmt standardmäßig gVisor; für Workloads, die eine härtere Grenze brauchen, steht optional eine Micro-VM-Sandbox-Klasse (Kata Containers plus Cloud Hypervisor) bereit.
Die Kernidee ist Multiplexing. Substrate bildet eine große Zahl von Actors – Ihren Agent-Instanzen – auf einen deutlich kleineren Pool von Workern ab, den Sandboxes, die sie tatsächlich ausführen. Die Annahme dahinter: Agent-artige Workloads verbringen die meiste Zeit im Leerlauf.
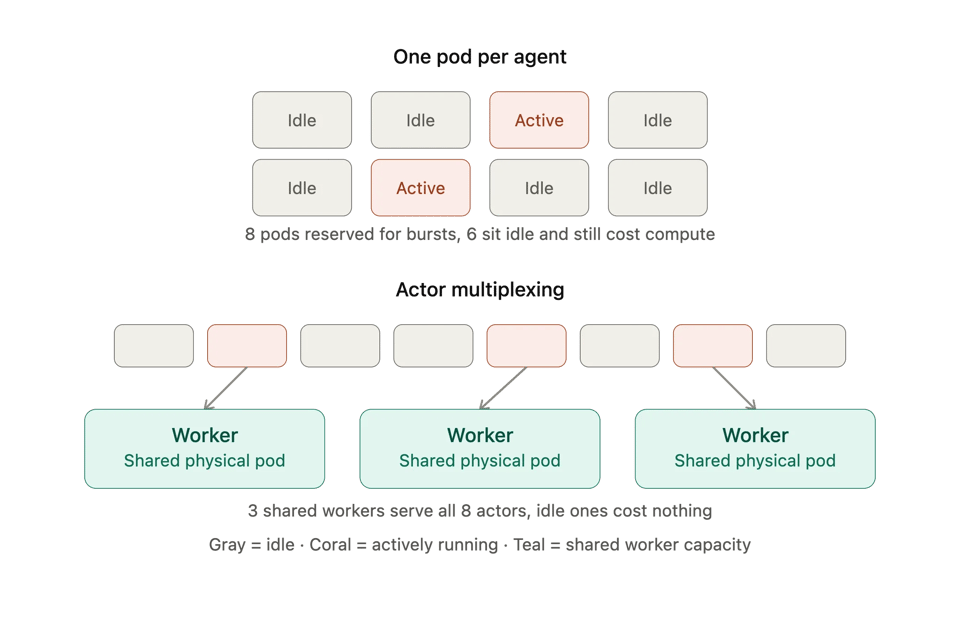
Ein paar Begriffe, die Sie kennen sollten, bevor sich der Rest erschließt:
- Actor: eine laufende Instanz eines Agenten
- ActorTemplate: die unveränderliche Blaupause (Container-Image, Umgebung, Snapshot-Richtlinie), aus der Actors einer bestimmten Version erstellt werden
- Worker: der Sandbox-Pod, in dem ein aktiver Actor ausgeführt wird
- WorkerPool: eine Flotte vorgewärmter Worker, bereit, einen Actor aufzunehmen
- Atespace: eine Namespace-ähnliche Gruppierung, in der Actors und Templates leben
Der Grund, warum das so viel dichter läuft als ein Pod pro Agent: Substrate nimmt die Kubernetes Control Plane aus dem kritischen Pfad. Kubernetes provisioniert und verwaltet weiterhin die zugrunde liegenden Pods – Substrate schickt nur nicht jeden Suspend- und Resume-Zyklus durch das Pod-Scheduling. Das erledigt seine eigene Control Plane direkt: ateapi für den Actor- und Worker-Lifecycle, atecontroller für die Reconciliation der WorkerPools, atenet für DNS und Routing, atelet als DaemonSet auf Node-Ebene.
Agent Substrate funktioniert mit jedem Framework, das standardkonforme OCI-Container erzeugt. Das Projekt listet Integrationsmuster für das Agent Development Kit, LangChain und Claude Code auf. Es ist selbst kein Agent-Framework oder SDK, sondern das Substrat darunter.
Warum sich die Komplexität lohnt
Nicht vertrauenswürdiger Code – ob KI-generiert oder ein einmaliger Tool-Call – läuft in Kernel- und Netzwerk-Isolation, ohne den Rest des Clusters zu exponieren. Arbeitsspeicher und Dateien eines Actors bleiben über Suspend-Zyklen hinweg erhalten – er macht also exakt dort weiter, wo er pausiert wurde, statt von vorn zu beginnen. Die Wiederherstellung ist mit einem Bruchteil einer Sekunde schnell genug, dass die Antwortlatenz auch für stoßweise aktive Agenten mit direktem Nutzerkontakt akzeptabel bleibt. Und weil ein gemeinsamer Pool warmer Worker viele Actors bedient, zahlen Sie nicht für Rechenleistung, die inaktive Actors gar nicht nutzen.
Diese Kombination passt gut zu einer bestimmten Klasse von Workloads. Hintergrund-Assistenten, die über Tage Kontext halten, aber nur in kurzen Schüben aktiv sind, sparen vor allem durch das Pausieren zwischen diesen Schüben. Wegwerf-Sandboxes für nicht vertrauenswürdigen, LLM-generierten Code profitieren vom Restore in unter einer Sekunde: hochfahren, Task ausführen, freigeben – ohne jedes Mal einen kompletten Kaltstart. Coding-Agenten, die in Echtzeit mit einem Entwickler interagieren, behalten Terminal- und Dateisystem-Zustand zwischen den Prompts, während der Cluster nur für Entwickler Rechenleistung aufwendet, die tatsächlich aktiv sind.
Wie ein Request tatsächlich durch das System läuft
Wird ein Actor aus einem Template erstellt, startet Substrate einen temporären "Golden Pod", führt die Startlogik Ihres Containers einmal aus und erstellt einen Golden Snapshot, sobald die Initialisierung abgeschlossen ist. Jeder weitere Actor dieses Templates setzt auf diesem Snapshot auf, statt kalt zu booten. Deshalb gehört teure Initialisierung (ein Modell laden, Basisverbindungen öffnen) in Ihren Entry Point – und nicht an eine Stelle, an der sie bei jedem Aufwachen wiederholt würde.
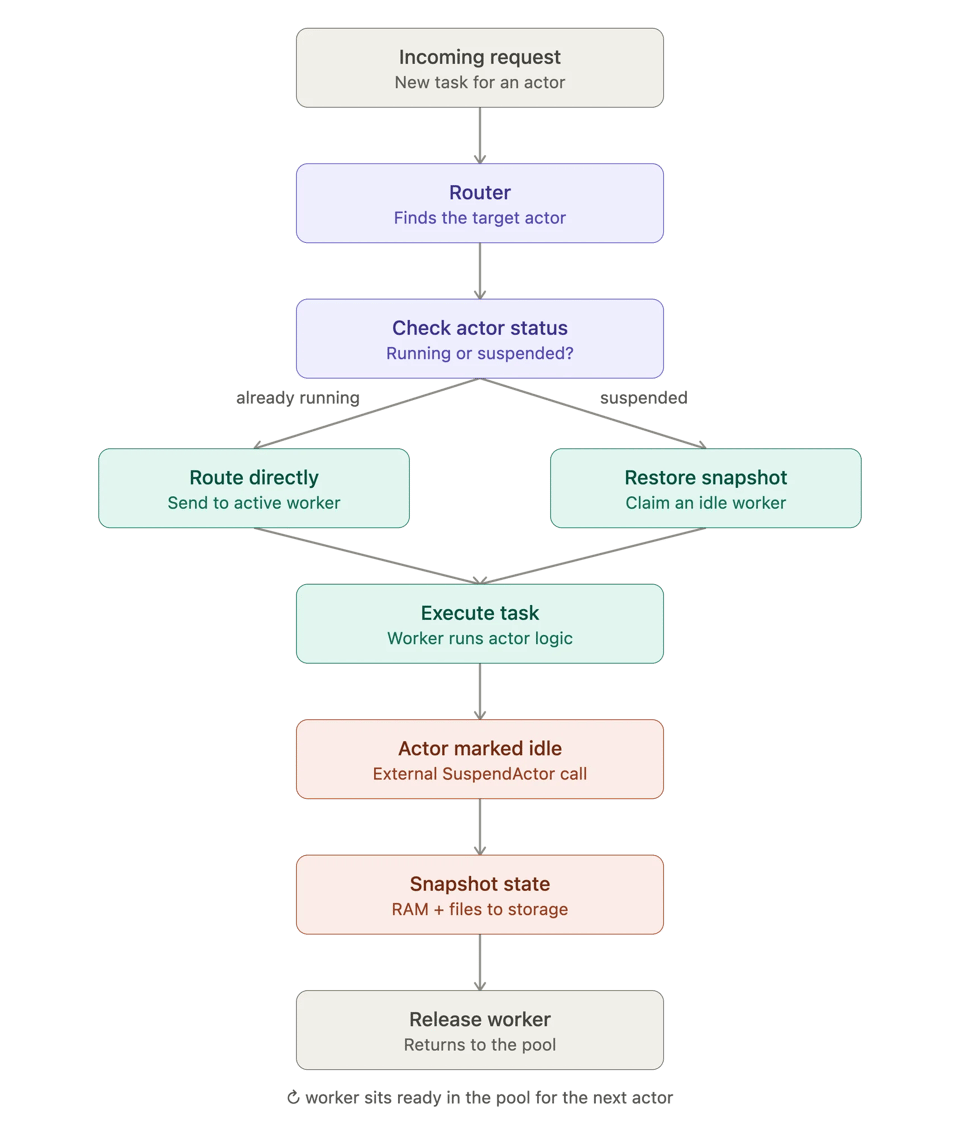
Eine wichtige Einschränkung: Substrate erkennt Inaktivität derzeit nicht selbst. Das Pausieren wird durch einen expliziten API-Aufruf des Systems ausgelöst, das die Actors orchestriert – nicht dadurch, dass Substrate die Aktivität beobachtet und selbst entscheidet.
Konfiguration: WorkerPool und ActorTemplate
Substrate-Ressourcen sind Kubernetes-CRDs unter der API-Gruppe ate.dev/v1alpha1 und fügen sich damit in einen normalen GitOps-Flow ein. Zwei Ressourcen erledigen den Großteil der Arbeit.
Ein WorkerPool definiert die physische Kapazität: wie viele warme Pods bereitstehen, welche Sandbox-Runtime sie nutzen und welche Regeln für die Node-Platzierung gelten.
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.Ein ActorTemplate definiert den Workload selbst: seinen Container, den Speicherort der Snapshots und die Worker-Pools, auf denen er laufen darf.
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/Ein paar Details, die Sie kennen sollten, bevor Sie Ihr eigenes Template schreiben. Container-Images müssen per Digest gepinnt werden, da eine Änderung des Images bestehende Snapshots ungültig macht. Die readyz-Probe ist optional, aber empfehlenswert: Sie stellt sicher, dass Cold Boot und Restore erst dann als abgeschlossen gelten, wenn Ihr Workload tatsächlich Traffic bedienen kann – und nicht nur gestartet ist. Und jede neue Version Ihres Agenten sollte ihr eigenes ActorTemplate bekommen (research-agent-v2 und so weiter), da Substrate ein Template als unveränderlichen State-Root behandelt – und nicht als etwas, das man in-place ändert.
Sobald das Template den Status Ready erreicht, erstellen Sie einen Actor logisch über die CLI:
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agentund er läuft auf dem nächsten freien Worker im referenzierten Pool weiter, sobald ein Request eintrifft.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Wo Sie die Details finden
Für die konkrete Konfiguration ist die Dokumentation des Projekts selbst die richtige Anlaufstelle – verlassen Sie sich nicht darauf, dass ein Blogbeitrag mit einem System Schritt hält, dessen APIs sich erklärtermaßen noch bewegen:
- README und Quickstart, inklusive eines lokalen Setups auf
kind-Basis, das außer Go,kubectlund Docker nichts benötigt - API Configuration Guide mit der vollständigen Feldreferenz für
WorkerPool,ActorTemplateundSandboxConfig - Architecture Guide dazu, wie Control Plane, Node Supervisor und Networking-Stack zusammenspielen
- Demos-Verzeichnis mit ausgearbeiteten Beispielen: ein zustandsbehafteter Counter, eine abgeschottete Shell-Umgebung, eine Claude-Code-Multiplexing-Demo und ein per HPA autoskalierter Worker-Pool
Speziell: Der Betrieb auf GKE
Alles oben Beschriebene funktioniert auf jedem Kubernetes-Cluster. Läuft Ihre Infrastruktur auf GKE, hat Google zusätzlich einen geführten Einstieg gebaut. Seit dem 11. September 2026 steht Agent Substrate auf GKE allen Google-Cloud-Kunden für Evaluierung und Non-Production-Einsatz offen; Produktions-Support ist im Rahmen eines Limited-GA-Programms an eine Allowlist gebunden.
Der schnellste Weg ist ein einzelner Installer im Repo ai-on-gke/substrate-gke. Er führt Sie durch das Provisionieren oder Auswählen eines GKE-Clusters, aktiviert anschließend die von Substrate benötigten Konfigurationen und deployt die Control Plane darauf.
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash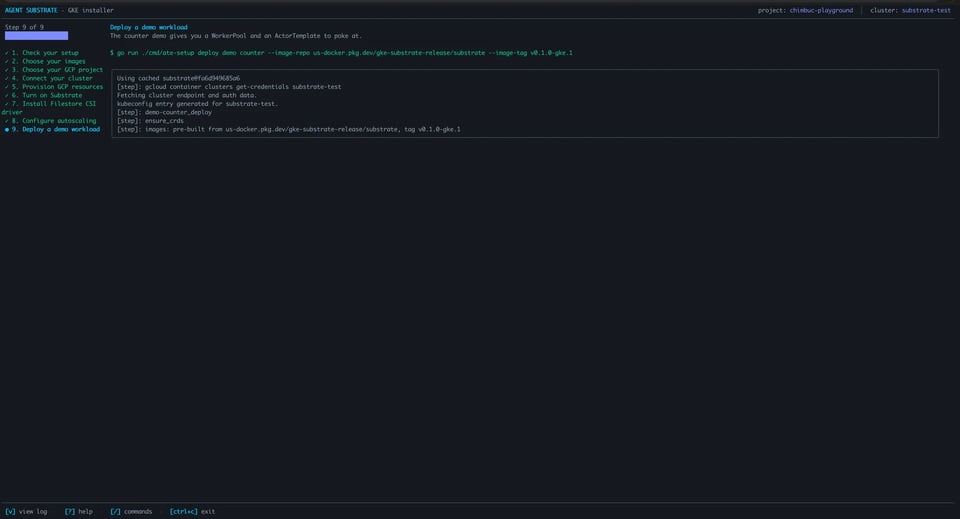
Den Rest decken Googles eigene Dokumentation zu Agent Substrate auf GKE und der Install Guide ab.
Das Kostenzuordnungsproblem, das dabei entsteht
Tausende Actors auf einen gemeinsamen WorkerPool zu multiplexen löst das Problem des Leerlauf-Computes. Es schafft aber ein neues: Die klassische Kostenzuordnung funktioniert nicht mehr. Tag-basiertes FinOps-Tooling setzt eine halbwegs stabile Zuordnung zwischen einem Pod und dem Team oder Kunden voraus, den er bedient. Sobald Actors pausiert, auf dem gerade freien Worker fortgesetzt werden und sich einen Pool mit Hunderten anderer Actors teilen, ist diese Zuordnung dahin. Der Compute-Posten eines gemeinsamen WorkerPools sagt zudem nichts darüber aus, welche LLM-Token-Kosten jeder einzelne Actor über das jeweils aufgerufene Modell oder Gateway verursacht.
DoiT Attribute™ ist genau für diese Lücke gebaut. Es liest Gateway-Traffic zur Laufzeit mit einem eBPF-Sensor aus, statt sich auf Tags zu verlassen, und führt jeden Inference-Aufruf auf den Agenten, das Feature oder den Kunden zurück, der ihn ausgelöst hat – und trennt dabei menschlichen von nicht-menschlichem (Agenten-)Traffic. Für eine Plattform, die viele Substrate-Actors über gemeinsam genutzte LLM-Gateways laufen lässt, macht das den Unterschied, ob Sie nur Ihre gesamten AI-Ausgaben kennen – oder wissen, welcher Actor, Kunde oder welches Feature sie tatsächlich verursacht.
Fazit
Agent Substrate löst ein reales Problem: Agent-Workloads liegen die meiste Zeit brach, und weder Kubernetes noch die Cloud-Abrechnung tragen dem Rechnung. Gleichzeitig steht das Projekt noch ganz am Anfang. Die eigene Dokumentation beschreibt es als nicht produktionsreif, und die APIs werden sich voraussichtlich weiter ändern; die Erkennung von Inaktivität müssen Sie nach wie vor selbst implementieren – Substrate übernimmt das nicht für Sie.
Wenn Sie es in nennenswertem Volumen mit gemeinsam genutzten LLM-Gateways betreiben, ist die Frage, was jeder Actor tatsächlich kostet, das nächste Problem, auf das Sie stoßen.


