
OpenAI entwickeln, ausliefern und produktiv betreiben
OpenAI auf DoiT
Bringen Sie die OpenAI Platform vom Pilotprojekt in die Produktion – auf AWS, Google Cloud und Azure. Das richtige Modell, transparente Kosten und ein Betrieb, der standhält.
OpenAI-Practice auf Enterprise-Niveau
Die meisten KI-Projekte bleiben nach der Demo stecken
Das Modell funktioniert. Die Rechnung, die Latenz und die Zuverlässigkeit nicht. Unsere OpenAI-Practice auf Enterprise-Niveau hat genau eine Aufgabe: KI vom Pilotprojekt in die Produktion zu bringen.
Wir kombinieren tiefes OpenAI-Know-how mit unserer FinOps- und CloudOps-DNA. Unsere Forward Deployed Engineers arbeiten direkt in Ihrem Team und liefern – statt Ihnen ein Strategiepapier zu übergeben und zu verschwinden.
Warum DoiT
Einen OpenAI-Workshop können viele anbieten. Den Workload nach dem Go-live betreiben nur wenige. Genau in dieser Lücke arbeiten wir.
Multicloud als Standard
OpenAI auf Amazon Bedrock plus direkte API. Wir wählen den Weg, der zu Ihrem Stack passt – nicht zu unserem.
FinOps in der DNA
Seit 2011 kalkulieren und optimieren wir Cloud-Ausgaben. Tokens, GPUs und Anbieter-Trade-offs – auf den Dollar genau gemessen.
Umsetzung direkt im Team
Senior Engineers werden Teil Ihres Teams. Sie kennen Ihre Architektur, Ihren Kontext und Ihre Rahmenbedingungen.
Instrumentierung inklusive
KI-Ausgaben nach Team, Feature und Kunde zugeordnet – damit Sie sehen, was OpenAI wirklich kostet.
Das bringt Ihnen die Partnerschaft
Vom Pilotprojekt in die Produktion – schneller
Das richtige Modell. Echte Zielwerte. Kosten, die Sie vertreten können.
Das richtige Modell für die Aufgabe
Ein Modell für anspruchsvolles Reasoning, eines für die Balance und ein weiteres für Aufgaben mit hohem Volumen.
Schneller in die Produktion
Referenzarchitekturen verkürzen Wochen auf Tage.
Kosten unter Kontrolle
Unit Economics vom ersten Tag an, auf Marge optimiert.
Zuverlässig unter Last
HA-Patterns und Rollback-Pläne – fest verankert vor dem Go-live.
Eval-Harnesses inklusive
Qualität wird mit automatisierten Evaluationen gemessen – nicht geschätzt.
Governance von Anfang an
Least-Privilege-Zugriff und klare Datenverantwortung über alle Teams hinweg.
So liefern wir
Forward Deployed Engineers statt Ticket-Warteschlange
FDEs sind Senior Cloud Architects, die direkt in Ihrem Team arbeiten. Sie implementieren, testen und deployen gemeinsam mit Ihren Engineers. Sie verantworten Ergebnisse über den gesamten OpenAI-Lifecycle: Agent- und Workflow-Engineering, RAG- und Wissenssysteme, Eval-Harnesses, Optimierung der Inferenzkosten, Zuverlässigkeit und Sicherheit.
So läuft die Zusammenarbeit ab
Fünf Phasen. Echte Code-Änderungen statt Empfehlungen.
Kickoff
Use Cases, SLOs und die dringendsten Schmerzpunkte abstimmen. Ihre Umgebung erfassen.
Planen
Umfang definieren. Modelle wählen, Evals festlegen, Kosten- und Latenzziele setzen.
Umsetzen
Gemeinsam mit Ihren Engineers implementieren. Echte Änderungen in Ihrer Codebase.
Automatisieren
Monitoring, Guardrails und Policy-Kontrollen verankern. Kein Babysitting nötig.
Belegen
Qualität, Kosten und Zuverlässigkeit an den Zielen messen. Dann weiter zum Nächsten.
OpenAI wie einen Produktiv-Workload betreiben
Lastspitzen, GPU-Scheduling, Model Drift, unberechenbare Kosten. Unser FDE-Team betreibt OpenAI so, wie wir jeden geschäftskritischen Workload betreiben.
GPU-Effizienz
Unterausgelastete Inferenz- und Trainingsläufe aufspüren. Beschleuniger auslasten, ohne Ressourcen zu verschwenden.
Skalierungs-Patterns
Autoscaling-Strategien, abgestimmt auf LLM- und Agent-Traffic.
Datenpipelines
Ingestion und Preprocessing härten, damit Retrieval und Training nie ins Stocken geraten.
FinOps für OpenAI
Token-Verbrauch, Anbieterkosten und Trade-offs klar im Blick.
Resilienz als Standard
HA-Patterns, Failure Domains und Graceful Degradation von Anfang an eingebaut.
Produktionsvalidierung
Lasttests, Chaos-Drills und Rollback-Pläne vor dem Go-live.
Sehen, was OpenAI wirklich kostet
Token-Rechnungen verschleiern die Wahrheit
Die Gesamtsumme kennen Sie. Welches Team, welches Feature oder welcher Kunde sie verursacht hat, nicht. Das ändern wir.
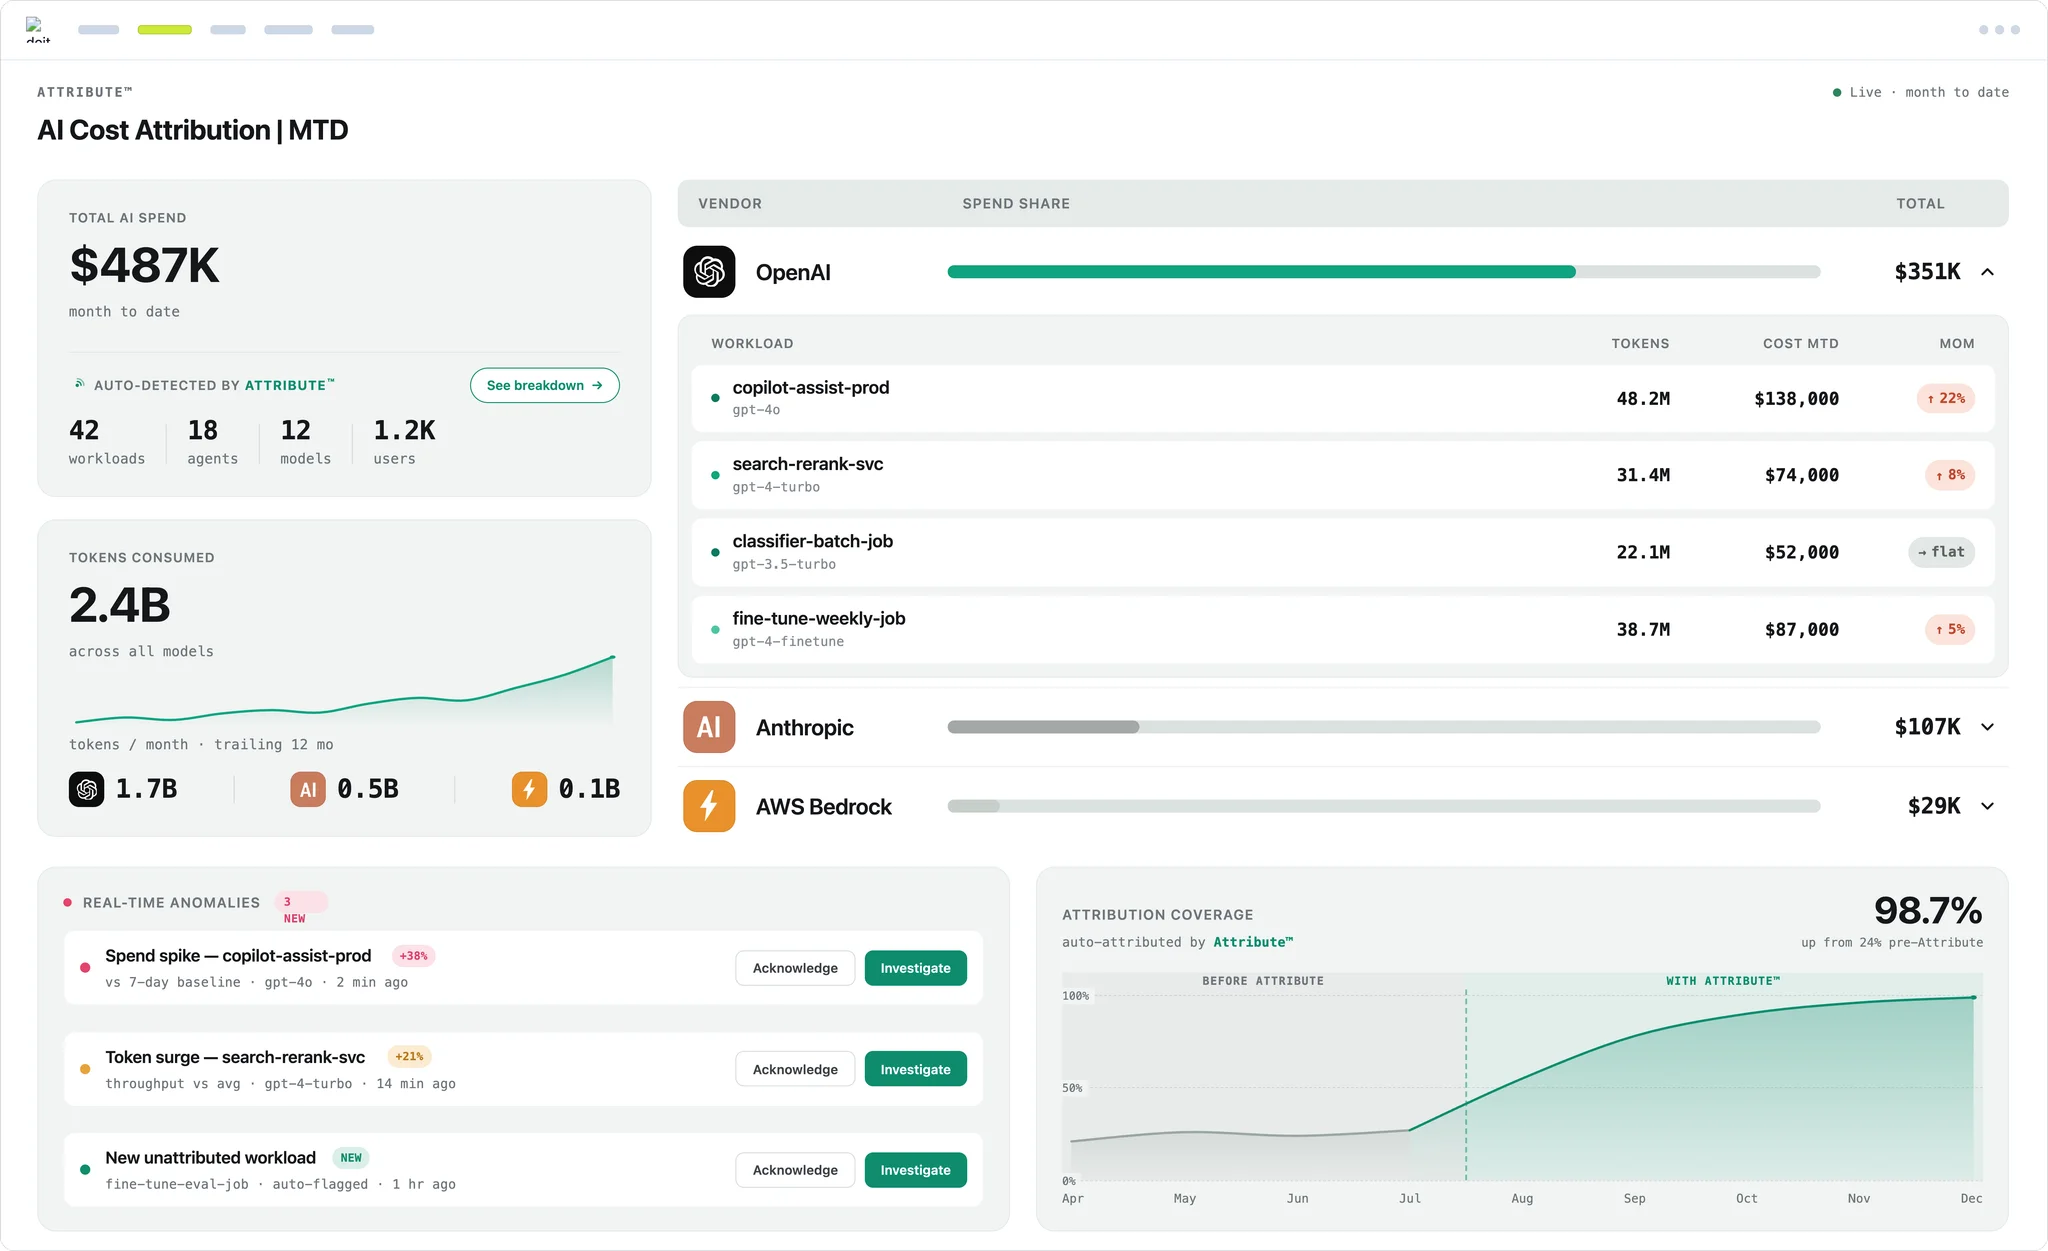
Mit Instrumentierung auf Kernel-Ebene ordnen wir KI- und Cloud-Ausgaben direkt an der Quelle zu – ganz ohne Code-Änderungen. Jeder API-Call wird dem dahinterliegenden Workload zugeordnet. So treffen Sie Trade-off-Entscheidungen auf Basis echter Zahlen.
Was wir bauen
Jedes Engagement beginnt mit einem Problem, nicht mit einem Feature.
Agentische Workflows
OpenAI übernimmt die mehrstufigen Aufgaben, die Ihr Team heute manuell erledigt.
Wissens- und RAG-Systeme
Antworten, die auf Ihren Daten basieren – nicht auf dem offenen Web.
Coding- und SDLC-Beschleunigung
Schnellere Reviews, Refactorings und Migrationen mit Codex an Bord.
Support-Automatisierung
Tickets lösen und Volumen abfangen, ohne den Kunden zu verlieren.
Dokumenten- und Vertragsanalyse
Extrahieren, zusammenfassen und prüfen – in großem Maßstab.
Individuelle Workloads
Maßgeschneidert für Ihren Stack, Ihre Daten und Ihre SLOs – nicht nach Schablone.
Jetzt mit OpenAI entwickeln
Wir ermitteln Ihre Prioritäten und den schnellsten Weg in die Produktion.