
Cloud Intelligence™
I Suoi agenti sono inattivi. La Sua bolletta Kubernetes no.
Kubernetes non ha alcun concetto nativo di Pod in sospensione. Agent Substrate esegue il multiplexing di migliaia di agenti stateful su un pool condiviso di worker, senza la penalizzazione del cold start.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Chimbu Chinnadurai
Senior Cloud Architect II
I've probably debugged a Kubernetes issue in more time zones than I care to count. Based in London, I help engineering teams across EMEA get their clusters to behave — and actually understand why they misbehaved in the first place.
I write, speak, and guest on podcasts about all things cloud-native. Away from the terminal: I enjoy cooking almost as much as simplifying overly complex systems.
My personal pageAgenti interattivi, assistenti personali, agenti di coding e sandbox per tool-calling trascorrono gran parte del loro runtime in attesa di una persona o di un trigger esterno. In quella finestra non eseguono alcun calcolo effettivo. Su Kubernetes, quel tempo di inattività costa comunque risorse reali: capacità che potrebbe altrimenti servire workloads attivi.
Kubernetes standard lega ogni workload a un Pod dedicato. Il throughput di scheduling dei Pod e la latenza di avvio impongono un tetto rigido, e Kubernetes non ha alcun concetto nativo di ibernazione di un Pod. Parcheggiando milioni di agenti inattivi come Pod attivi si esauriscono i limiti di Pod e la memoria del control plane molto prima di esaurire la capacità di calcolo effettiva. Il workaround abituale, smantellare i Pod e ricostruire lo stato dell'agente da storage esterno a ogni risveglio, funziona. Ma significa che ogni team ricostruisce la stessa infrastruttura di esternalizzazione dello stato e paga il costo pieno del cold start a ogni ripresa.
Agent Substrate adotta un approccio diverso: sospendere gli agenti inattivi, catturare uno snapshot della loro RAM e dei file locali, e ripristinare quello stato su una sandbox disponibile in meno di un secondo, nel momento esatto in cui l'agente deve tornare in azione.
Nota: Agent Substrate è nelle prime fasi di sviluppo e non è pronto per l'uso in produzione. Le API sono destinate a cambiare e la retrocompatibilità non è garantita.
Che cos'è Agent Substrate
Agent Substrate è un runtime di esecuzione per agenti secure-by-default, progettato per eseguire milioni di sandbox con una densità 10 volte superiore rispetto ai runtime container standard, con ripristino in meno di 500 ms e oltre 500 attivazioni di suspend/resume al secondo. L'isolamento è garantito da gVisor per impostazione predefinita, con una classe di sandbox micro-VM opzionale (Kata Containers più Cloud Hypervisor) per i workloads che richiedono un isolamento più rigoroso.
L'idea centrale è il multiplexing. Substrate mappa un gran numero di actor, le istanze degli agenti, su un pool molto più ridotto di worker, le sandbox che li eseguono effettivamente, partendo dal presupposto che i workloads di tipo agente trascorrano la maggior parte del tempo inattivi.
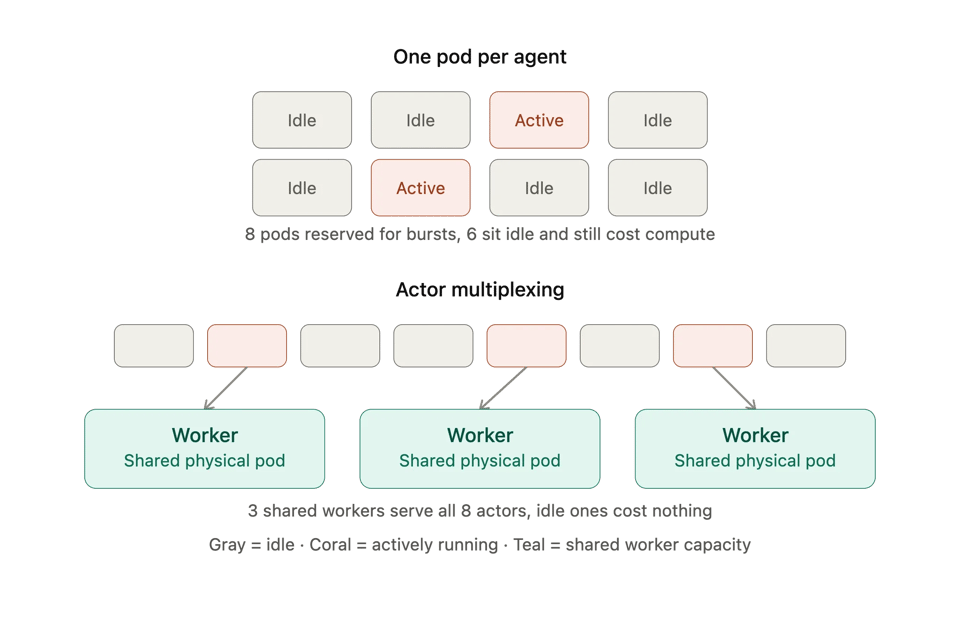
Alcuni termini utili da conoscere per orientarsi nel resto:
- Actor: un'istanza in esecuzione di un agente
- ActorTemplate: il blueprint immutabile (immagine container, environment, policy di snapshot) usato per creare gli actor di una determinata versione
- Worker: il pod sandbox in cui viene eseguito un actor attivo
- WorkerPool: una flotta di worker pre-riscaldati pronti a ricevere un actor
- Atespace: un raggruppamento simile a un namespace in cui vivono actor e template
Il motivo per cui questo approccio raggiunge una densità molto maggiore rispetto a un Pod per agente è che Substrate toglie il control plane di Kubernetes dal percorso critico. Kubernetes continua a effettuare il provisioning e a gestire i Pod sottostanti; Substrate semplicemente non fa passare ogni ciclo di suspend e resume attraverso lo scheduling dei Pod. Se ne occupa direttamente il suo control plane: ateapi per il ciclo di vita di actor e worker, atecontroller che riconcilia i WorkerPool, atenet per DNS e routing, atelet in esecuzione come DaemonSet a livello di nodo.
Agent Substrate funziona con qualsiasi framework che produca container OCI standard. Il progetto elenca pattern di integrazione per Agent Development Kit, LangChain e Claude Code. Non è un framework per agenti né un SDK: è il substrato su cui poggiano.
Perché vale la pena affrontarne la complessità
Il codice non attendibile, che sia generato dall'AI o una singola chiamata a un tool, viene eseguito all'interno di un isolamento a livello di kernel e di rete senza esporre il resto del cluster. La memoria di lavoro e i file di un actor persistono attraverso i cicli di sospensione, quindi l'actor riprende esattamente da dove si era fermato invece di ripartire da zero. Il ripristino è abbastanza veloce, una frazione di secondo, da mantenere una latenza di risposta accettabile anche per agenti rivolti alle persone e con attività a raffiche. E poiché un pool condiviso di worker caldi serve molti actor, non si paga per capacità di calcolo che gli actor inattivi non stanno usando.
Questa combinazione si adatta bene a un insieme specifico di workloads. Gli assistenti in background che mantengono il contesto per giorni ma sono attivi solo in brevi raffiche ottengono la maggior parte dei risparmi dalla sospensione tra una raffica e l'altra. Le sandbox usa e getta per eseguire codice non attendibile generato da LLM beneficiano del ripristino in meno di un secondo: se ne avvia una, si esegue il task, la si rilascia, senza un cold boot completo ogni volta. Gli agenti di coding che mantengono un botta e risposta in tempo reale con uno sviluppatore conservano intatto lo stato del terminale e del filesystem tra un prompt e l'altro, mentre il cluster spende risorse di calcolo solo per gli sviluppatori effettivamente attivi.
Come fluisce effettivamente una richiesta
Quando un actor viene creato da un template, Substrate avvia un "golden pod" temporaneo, esegue una sola volta la logica di avvio del container e cattura un golden snapshot nel momento in cui l'inizializzazione è completata. Ogni actor successivo di quel template riprende da quello snapshot invece di avviarsi a freddo: ecco perché l'inizializzazione costosa (caricare un modello, aprire le connessioni di base) va messa nell'entry point e non in un punto in cui verrebbe ripetuta a ogni risveglio.
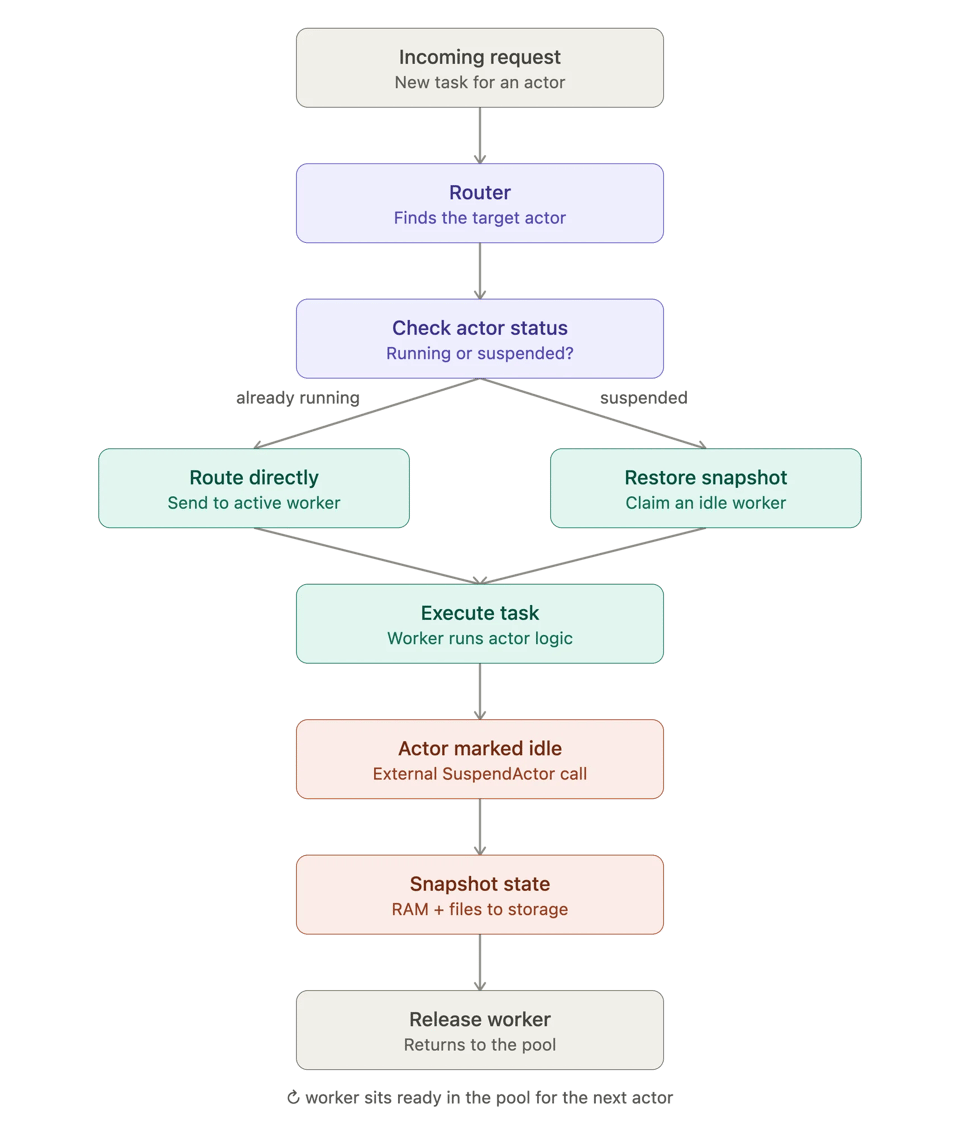
Una precisazione doverosa: al momento Substrate non rileva autonomamente l'inattività. La sospensione viene attivata da una chiamata API esplicita da parte del sistema che orchestra gli actor, non da Substrate che osserva l'attività e decide da sé.
Come configurarlo: WorkerPool e ActorTemplate
Le risorse di Substrate sono CRD Kubernetes sotto il gruppo API ate.dev/v1alpha1, quindi si inseriscono in un normale flusso GitOps. Due risorse fanno la maggior parte del lavoro.
Un WorkerPool definisce la capacità fisica: quanti pod caldi tenere in standby, quale runtime sandbox utilizzano ed eventuali regole di posizionamento sui nodi.
apiVersion: ate.dev/v1alpha1kind: WorkerPoolmetadata: name: research-agent-pool namespace: ate-demospec: replicas: 10 ateomImage: ko://github.com/agent-substrate/substrate/cmd/ateom-gvisor # sandboxClass defaults to gvisor; set to microvm for a Kata + Cloud # Hypervisor pool if your workload needs stronger isolation.Un ActorTemplate definisce il workload vero e proprio: il suo container, dove vengono archiviati gli snapshot e su quali worker pool è autorizzato a girare.
apiVersion: ate.dev/v1alpha1kind: ActorTemplatemetadata: name: research-agent namespace: ate-demospec: pauseImage: "gcr.io/gke-release/pause@sha256:<digest>" containers: - name: agent image: registry.example.com/research-agent@sha256:<digest> readyz: httpGet: path: /readyz port: 8080 sandboxClass: gvisor workerSelector: matchLabels: workload: research-agent snapshotsConfig: location: gs://my-bucket/snapshots/research-agent/Alcuni dettagli da conoscere prima di scrivere il proprio. Le immagini container devono essere bloccate tramite digest, perché cambiare l'immagine invalida gli snapshot esistenti. La probe readyz è facoltativa ma vale la pena impostarla: condiziona sia il cold boot sia il ripristino al fatto che il workload sia effettivamente pronto a servire traffico, non solo avviato. E ogni nuova versione dell'agente dovrebbe avere il proprio ActorTemplate (research-agent-v2, e così via), perché Substrate tratta un template come una radice di stato immutabile e non come qualcosa da modificare in place.
Una volta che il template raggiunge lo stato Ready, si crea logicamente un actor con la CLI:
kubectl ate create atespace demokubectl ate create actor my-agent-1 -a demo --template=research-agente questo riprende su qualsiasi worker libero del pool referenziato nel momento in cui arriva una richiesta.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Dove trovare i dettagli
La documentazione ufficiale del progetto è il posto giusto per una configurazione reale, invece di affidarsi a un blog post per restare al passo con un sistema le cui API sono dichiaratamente ancora in evoluzione:
- README e quickstart, incluso un setup locale basato su
kindche non richiede altro che Go,kubectle Docker - API Configuration Guide per il riferimento completo ai campi di
WorkerPool,ActorTemplateeSandboxConfig - Guida all'architettura per capire come si incastrano control plane, supervisore di nodo e stack di rete
- Directory delle demo per esempi completi: un contatore stateful, un ambiente shell in sandbox, una demo di multiplexing con Claude Code e un worker pool con autoscaling pilotato da un HPA
Il caso specifico di GKE
Tutto quanto descritto sopra funziona su qualsiasi cluster Kubernetes. Se la Sua infrastruttura è su GKE, Google ha predisposto anche un percorso di adozione guidato. A partire dall'11 settembre 2026, Agent Substrate su GKE è aperto a tutti i clienti Google Cloud per valutazione e uso non di produzione, con il supporto in produzione riservato ai clienti in allowlist nell'ambito di un programma di GA limitata.
Il percorso più rapido è un unico installer nel repo ai-on-gke/substrate-gke. Guida l'utente nel provisioning o nella selezione di un cluster GKE, poi abilita le configurazioni necessarie a Substrate e vi distribuisce il control plane.
curl -sSL https://raw.githubusercontent.com/ai-on-gke/substrate-gke/main/install.sh | bash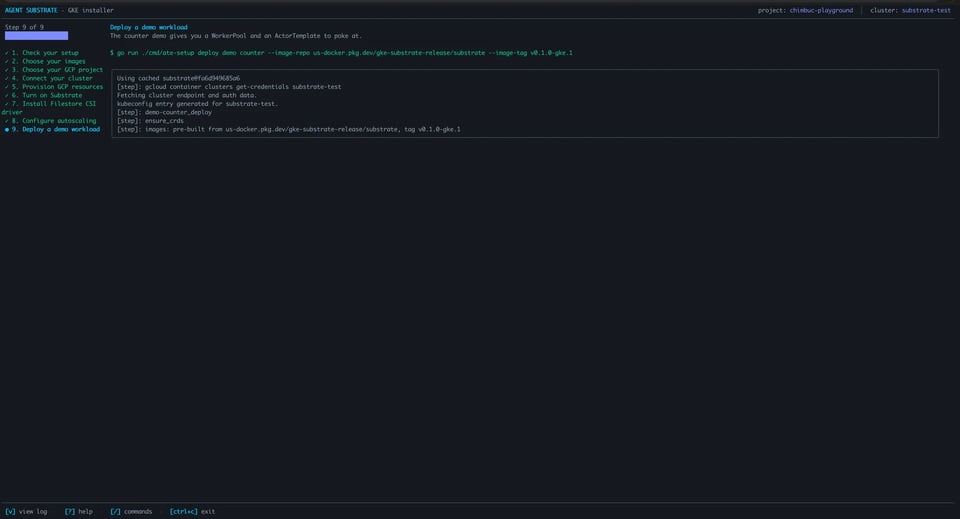
La documentazione di Agent Substrate su GKE di Google e la guida all'installazione coprono il resto.
Il problema di attribuzione dei costi che ne deriva
Eseguire il multiplexing di migliaia di actor su un WorkerPool condiviso risolve il problema del compute inattivo. Ne crea però un altro: l'attribuzione dei costi standard smette di funzionare. Gli strumenti FinOps basati su tag presuppongono una mappatura ragionevolmente stabile tra un Pod e il team o il cliente che serve. Quando gli actor vengono sospesi, ripresi su qualunque worker risulti libero al momento e condividono un pool con centinaia di altri actor, quella mappatura scompare. Inoltre, la voce di costo del compute su un WorkerPool condiviso non dice nulla sulla spesa in token LLM che ogni singolo actor sta generando attraverso il modello o il gateway che chiama.
DoiT Attribute™ è costruito esattamente per colmare questa lacuna. Legge il traffico del gateway a runtime con un sensore eBPF invece di affidarsi ai tag, e riconduce ogni chiamata di inferenza all'agente, alla funzionalità o al cliente che l'ha attivata, separando nel processo il traffico umano da quello non umano (degli agenti). Per una piattaforma che esegue grandi quantità di actor Substrate su gateway LLM condivisi, è la differenza tra conoscere la spesa AI aggregata e sapere quale actor, cliente o funzionalità la sta effettivamente generando.
Considerazioni finali
Agent Substrate risolve un problema reale: i workloads degli agenti restano inattivi per la maggior parte del tempo, e né Kubernetes né la fatturazione cloud ne tengono conto. Ed è anche, oggettivamente, in una fase molto iniziale. La documentazione del progetto stesso lo descrive come non pronto per l'uso in produzione e le API sono destinate a continuare a cambiare; il rilevamento dell'inattività resta qualcosa da implementare per conto proprio, non qualcosa di cui Substrate si occupa al posto Suo.
Se lo esegue su gateway LLM condivisi con volumi reali, sapere quanto costa effettivamente ciascun actor è il prossimo problema che incontrerà.


