
Crea, lanza y opera OpenAI en producción
OpenAI en DoiT
Lleva OpenAI Platform del piloto a producción en AWS, Google Cloud y Azure. El modelo correcto, costos visibles y operaciones que resisten.
práctica de OpenAI de nivel empresarial
La mayoría de los proyectos de IA se estancan después de la demo
El modelo funciona. La factura, la latencia y la confiabilidad, no. Operamos una práctica de OpenAI de nivel empresarial creada para una sola misión: llevar la IA del piloto a producción.
Combinamos nuestra experiencia en OpenAI con nuestro ADN de FinOps y CloudOps. Nuestros Forward Deployed Engineers se integran a tu equipo y entregan resultados, en lugar de dejarte una presentación de estrategia y desaparecer.
¿Por qué DoiT?
Muchas firmas pueden organizar un workshop de OpenAI. Pocas pueden operar el workload cuando entra en producción. Ahí es donde trabajamos nosotros.
Multicloud por defecto
OpenAI en Amazon Bedrock, más la API directa. Elegimos el camino que se ajusta a tu stack, no al nuestro.
ADN FinOps
Desde 2011 cotizamos y optimizamos el gasto en la nube. Tokens, GPUs y trade-offs entre proveedores medidos al dólar.
Entrega integrada
Engineers senior se suman a tu equipo. Conocen tu arquitectura, tu contexto y tus restricciones.
Instrumentación incorporada
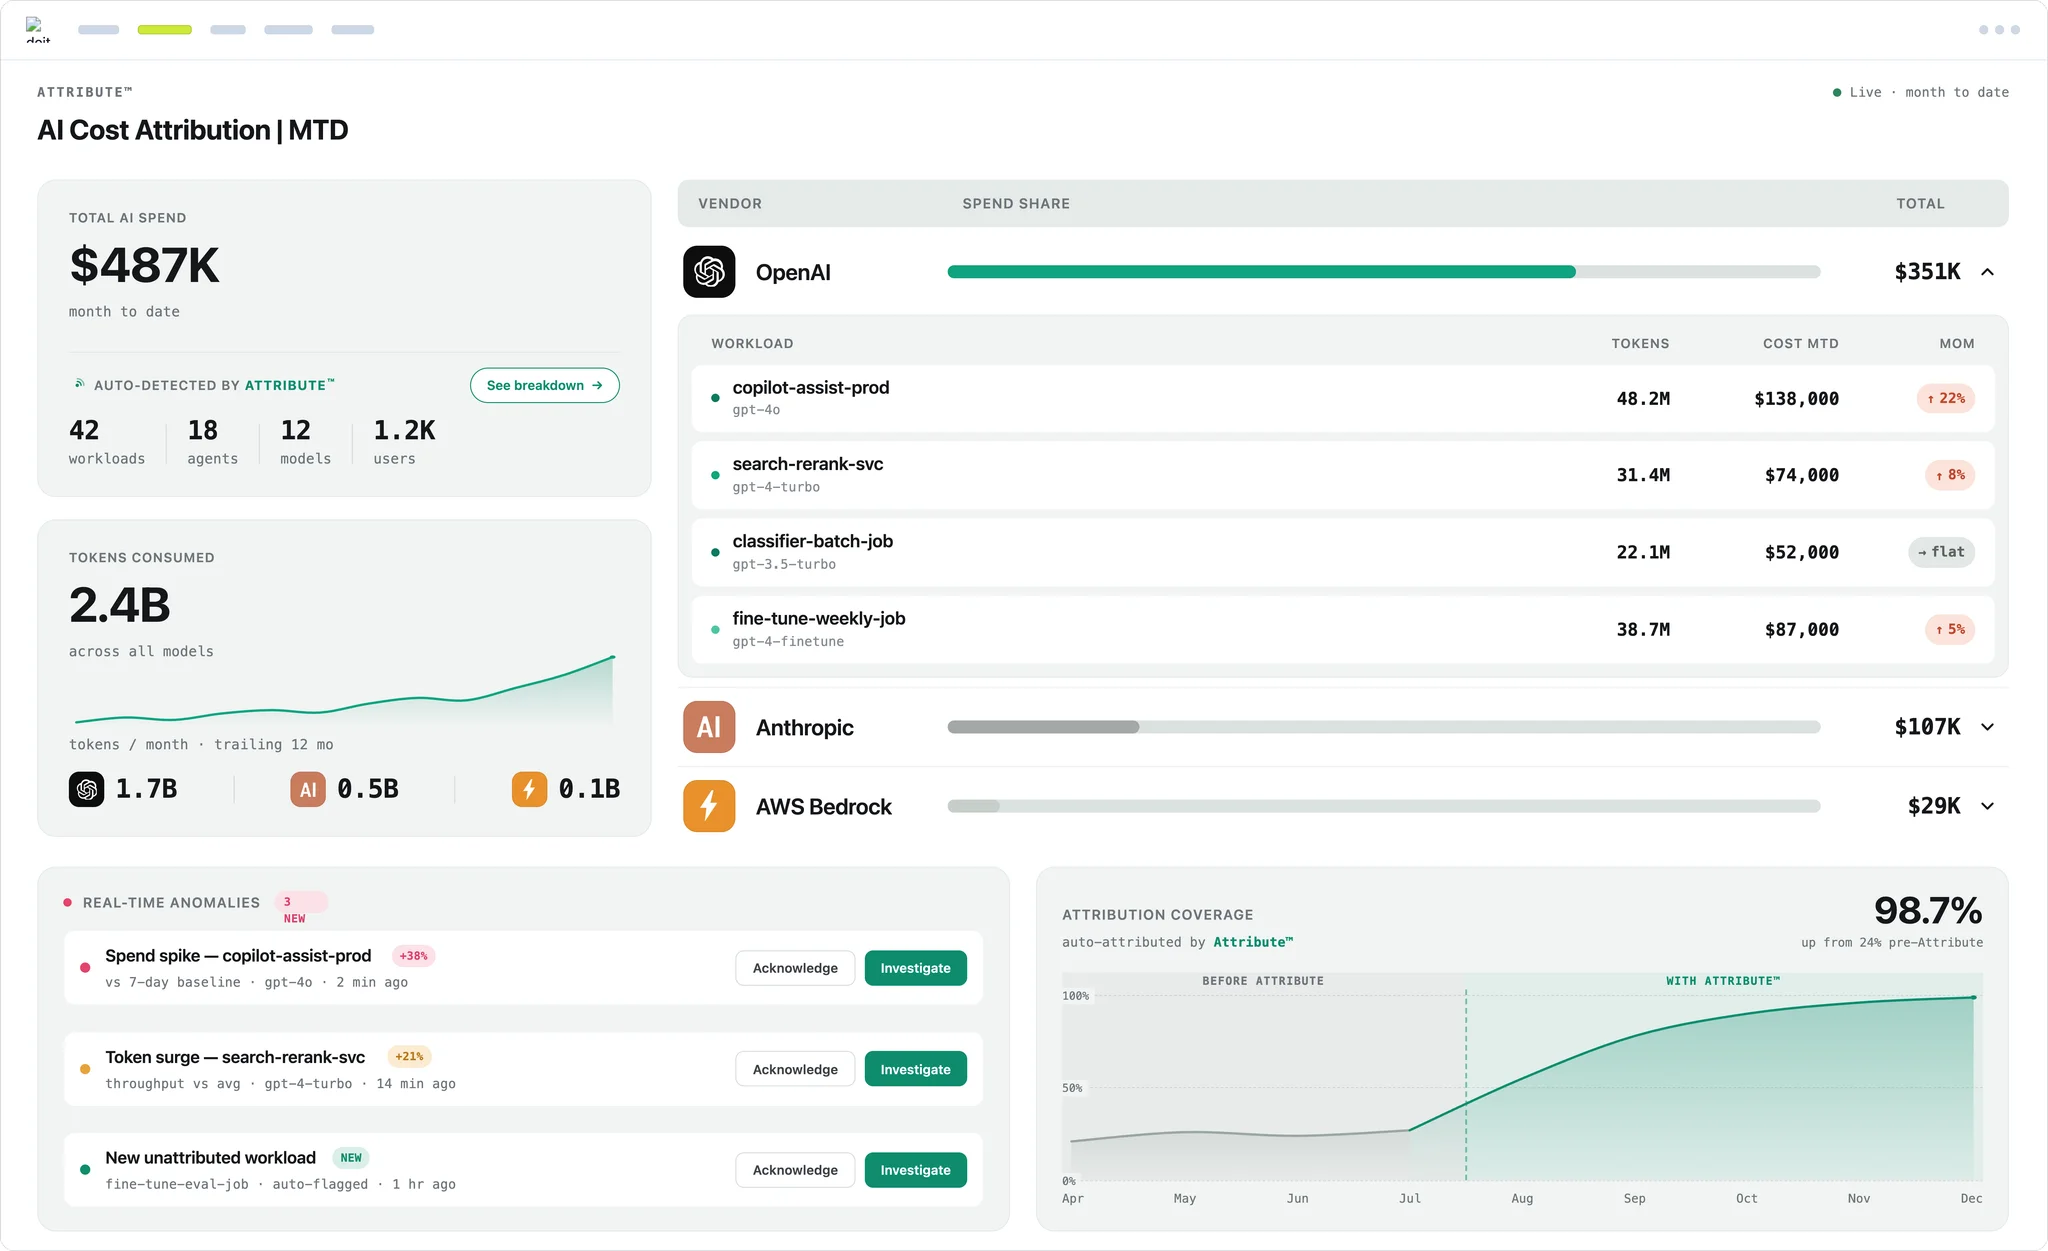
Atribuye el gasto en IA por equipo, funcionalidad y cliente para que veas cuánto cuesta OpenAI en realidad.
lo que te aporta la alianza
Del piloto a producción, más rápido
El modelo correcto. Objetivos reales. Costos que puedes defender.
El modelo correcto para cada tarea
Un modelo para el razonamiento complejo, otro para el equilibrio y otro más para el trabajo de alto volumen.
Camino más rápido a producción
Las arquitecturas de referencia comprimen semanas en días.
Costos bajo tu control
Unit economics desde el día uno, ajustados para cuidar el margen.
Confiabilidad bajo carga
Patrones de alta disponibilidad y planes de rollback incorporados antes del lanzamiento.
Evaluaciones automatizadas incluidas
La calidad se mide con evaluaciones automatizadas, no se adivina.
Gobernanza integrada
Acceso de privilegio mínimo y propiedad clara de los datos entre equipos.
cómo entregamos
Forward Deployed Engineers, no una cola de tickets
Los FDE son arquitectos de nube senior que se integran directamente a tu equipo. Trabajan codo a codo con tus Engineers para implementar, probar y desplegar. Se hacen responsables de los resultados en todo el ciclo de vida de OpenAI: ingeniería de agentes y flujos de trabajo, RAG y sistemas de conocimiento, evaluaciones automatizadas, optimización de costos de inferencia, confiabilidad y seguridad.
Así se desarrolla el proyecto
Cinco fases. Cambios reales en el código, no recomendaciones.
Inicio
Alineamos casos de uso, SLOs y los puntos de dolor más urgentes. Mapeamos tu entorno.
Planeación
Definimos el alcance. Elegimos modelos, establecemos evaluaciones y fijamos objetivos de costo y latencia.
Entrega
Implementamos junto a tus Engineers. Cambios reales en tu código.
Automatización
Integramos monitoreo, guardrails y controles de políticas. Sin supervisión constante.
Validación
Medimos calidad, costo y confiabilidad contra los objetivos. Y seguimos adelante.
Opera OpenAI como un workload de producción
Picos de demanda, programación de GPUs, drift de modelos, costos impredecibles. Nuestro equipo de FDE gestiona las operaciones de OpenAI como cualquier workload crítico.
Eficiencia de GPU
Detecta inferencias y entrenamientos subutilizados. Mantén los aceleradores ocupados sin pérdida.
Patrones de escalado
Estrategias de autoescalado ajustadas al tráfico de LLMs y agentes.
Pipelines de datos
Refuerza la ingesta y el preprocesamiento para que la recuperación y el entrenamiento nunca se detengan.
FinOps para OpenAI
Visualiza con claridad el uso de tokens, los costos por proveedor y los trade-offs.
Resiliencia por defecto
Patrones de alta disponibilidad, dominios de falla y degradación controlada incorporados.
Validación de producción
Pruebas de carga, simulacros de caos y planes de rollback antes del lanzamiento.
descubre cuánto cuesta OpenAI en realidad
Las facturas de tokens ocultan la verdad
Conoces el total. Lo que no sabes es qué equipo, funcionalidad o cliente lo generó. Eso es lo que cambiamos.
Usamos instrumentación a nivel de kernel para atribuir el gasto en IA y nube directamente en el origen, sin cambios en el código. Vincula cada llamada a la API con el workload que hay detrás. Toma decisiones con números reales.
Qué construimos
Cada proyecto parte de un problema, no de una funcionalidad.
Flujos de trabajo agénticos
OpenAI hace el trabajo de varios pasos que hoy tu equipo hace a mano.
Sistemas de conocimiento y RAG
Respuestas basadas en tus datos, no en la web abierta.
Aceleración de código y SDLC
Revisión, refactorización y migración más rápidas con Codex en el proceso.
Automatización de soporte
Resuelve tickets y reduce el volumen sin perder al cliente.
Análisis de documentos y contratos
Extrae, resume y verifica a escala.
Workloads a la medida
Diseñados en torno a tu stack, tus datos y tus SLOs, no a una plantilla.
Empieza a construir con OpenAI
Mapeamos tus prioridades y el camino más rápido a producción.