
Concevez, déployez et exploitez OpenAI en production
OpenAI sur DoiT
Faites passer OpenAI Platform du pilote à la production sur AWS, Google Cloud et Azure. Le bon modèle, des coûts visibles, des opérations qui tiennent la route.
une expertise OpenAI de niveau entreprise
La plupart des projets IA s'arrêtent après la démo
Le modèle fonctionne. La facture, la latence et la fiabilité, beaucoup moins. Nous avons bâti une expertise OpenAI de niveau entreprise avec un seul objectif : faire passer l'IA du pilote à la production.
Nous combinons une connaissance approfondie d'OpenAI avec notre ADN FinOps et CloudOps. Nos Forward Deployed Engineers s'intègrent à votre équipe et livrent du concret, au lieu de vous remettre un plan stratégique et de repartir.
Pourquoi DoiT
Beaucoup d'entreprises savent animer un atelier OpenAI. Peu savent exploiter le workload une fois en production. C'est précisément là que nous intervenons.
Multicloud par défaut
OpenAI sur Amazon Bedrock, ainsi que l'API directe. Nous choisissons la voie adaptée à votre stack, pas à la nôtre.
Un ADN FinOps
Nous optimisons les dépenses cloud depuis 2011. Tokens, GPU et arbitrages entre fournisseurs, mesurés au dollar près.
Une équipe intégrée
Des ingénieurs seniors rejoignent votre équipe. Ils connaissent votre architecture, votre contexte et vos contraintes.
Instrumentation native
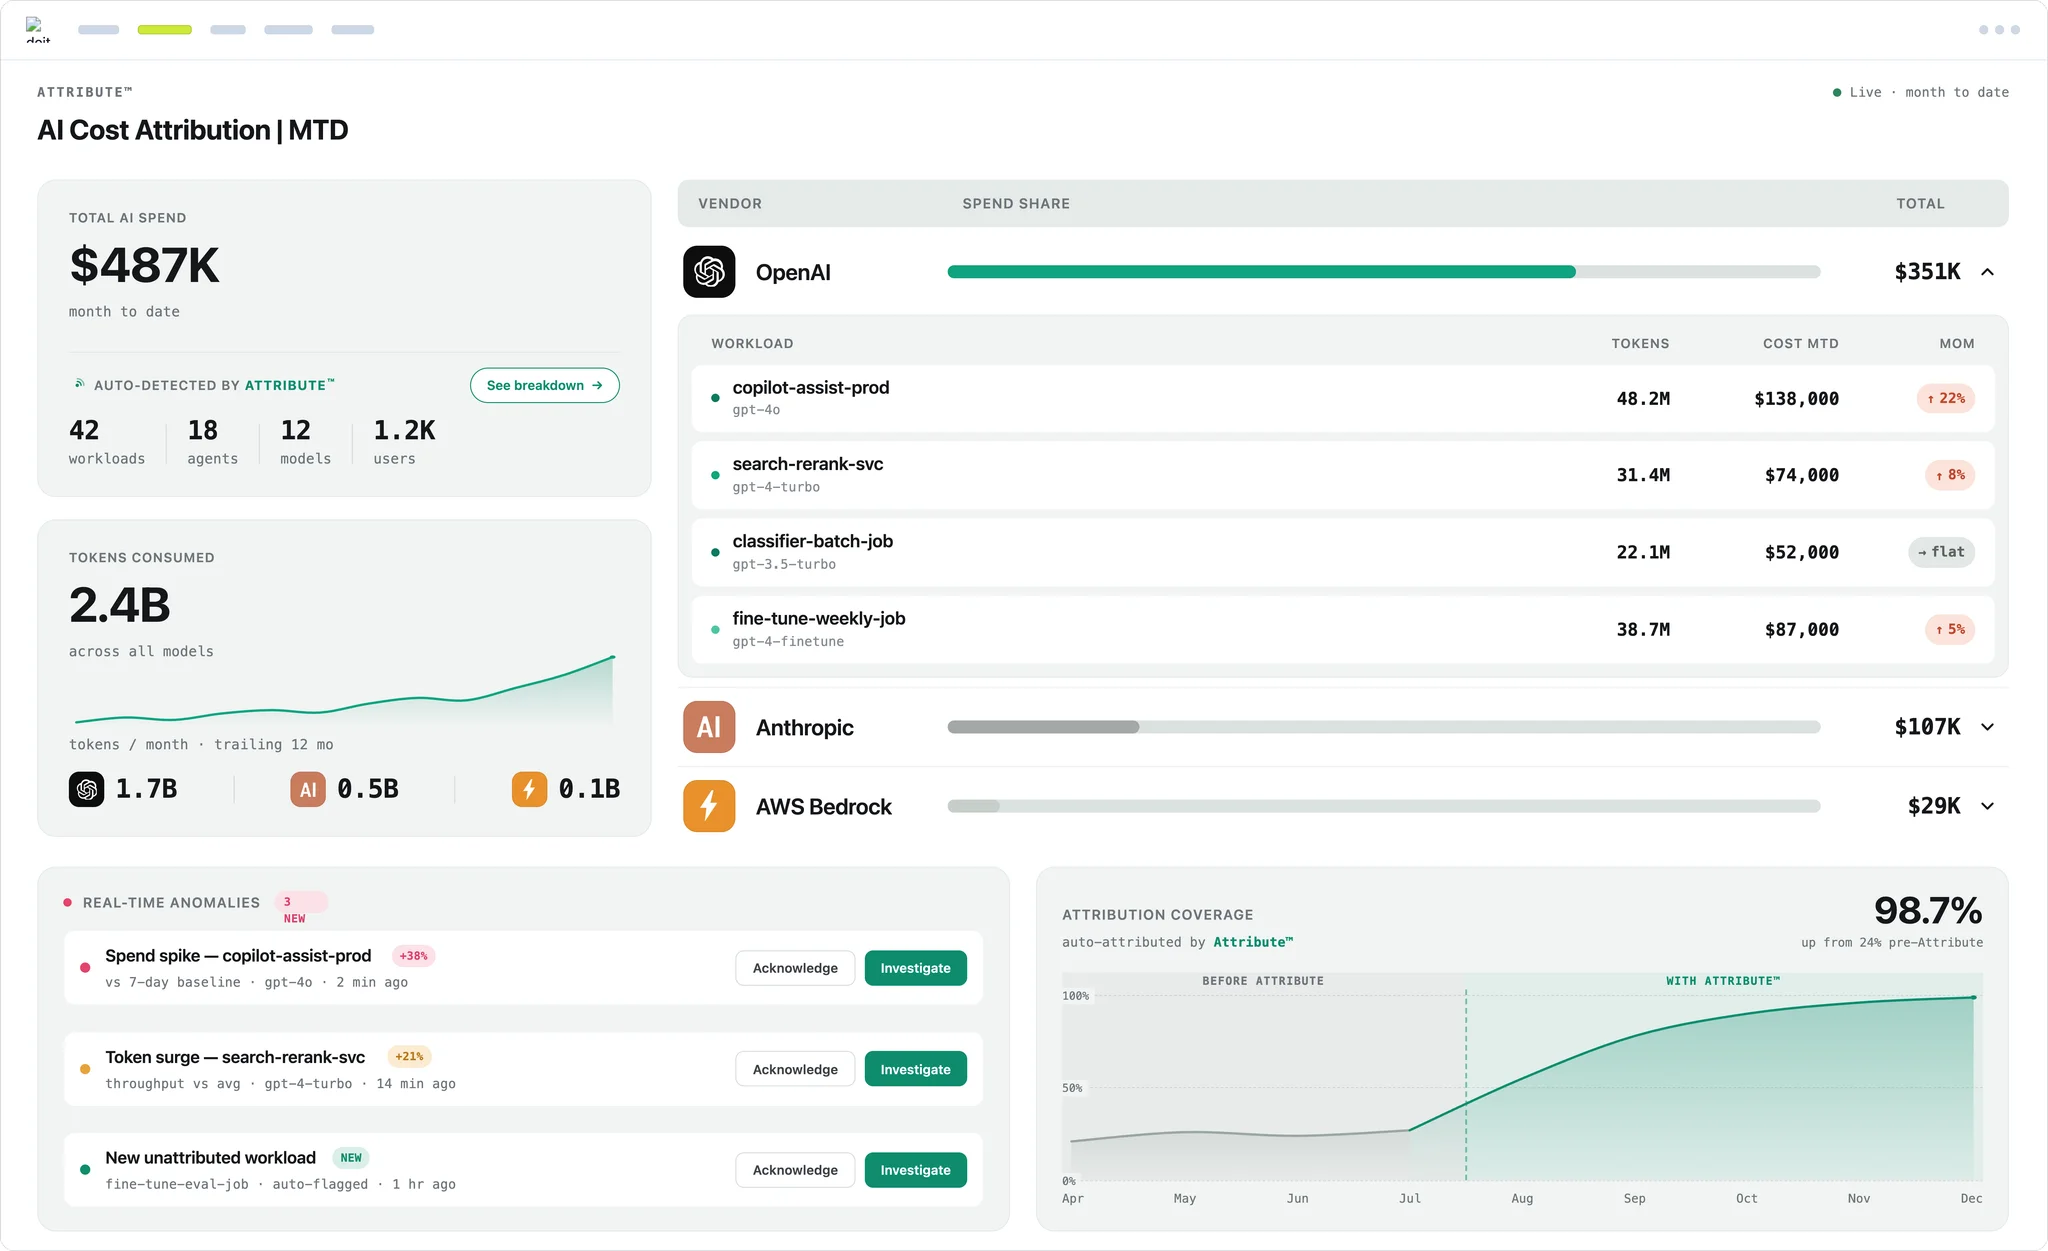
Attribuez les dépenses IA par équipe, fonctionnalité et client pour voir ce qu'OpenAI coûte réellement.
ce que le partenariat vous apporte
Du pilote à la production, plus vite
Le bon modèle. Des objectifs concrets. Des coûts que vous pouvez justifier.
Le bon modèle pour chaque tâche
Un modèle pour le raisonnement complexe, un autre pour l'équilibre, un troisième pour les gros volumes.
Mise en production accélérée
Des architectures de référence qui compressent des semaines en quelques jours.
Des coûts sous contrôle
Des coûts unitaires maîtrisés dès le premier jour, optimisés pour la marge.
Fiabilité sous charge
Patterns de haute disponibilité et plans de rollback intégrés avant la mise en production.
Évaluations automatisées incluses
La qualité se mesure avec des évaluations automatisées, elle ne se devine pas.
Gouvernance intégrée
Accès selon le principe du moindre privilège et propriété des données clairement définie entre les équipes.
notre façon de livrer
Des Forward Deployed Engineers, pas une file de tickets
Les FDE sont des architectes cloud seniors qui s'intègrent directement à votre équipe. Ils travaillent en binôme avec vos ingénieurs pour implémenter, tester et déployer. Ils assument les résultats sur l'ensemble du cycle de vie OpenAI : ingénierie d'agents et de workflows, RAG et systèmes de connaissances, dispositifs d'évaluation, optimisation des coûts d'inférence, fiabilité et sécurité.
Le déroulement de la mission
Cinq phases. De vraies modifications de code, pas des recommandations.
Lancement
Alignement sur les cas d'usage, les SLO et les priorités urgentes. Cartographie de votre environnement.
Cadrage
Définition du périmètre. Choix des modèles, définition des évaluations, objectifs de coûts et de latence.
Livraison
Implémentation aux côtés de vos ingénieurs. De vraies modifications dans votre codebase.
Automatisation
Mise en place du monitoring, des garde-fous et des politiques de contrôle. Sans supervision constante.
Validation
Mesure de la qualité, des coûts et de la fiabilité par rapport aux objectifs. Puis on passe à la suite.
Exploitez OpenAI comme un workload de production
Demande en pics, scheduling GPU, dérive des modèles, coûts imprévisibles. Notre équipe FDE gère les opérations OpenAI comme n'importe quel workload critique.
Efficacité GPU
Repérez les inférences et les entraînements sous-utilisés. Gardez vos accélérateurs occupés, sans gaspillage.
Stratégies de scaling
De l'autoscaling adapté au trafic des LLM et des agents.
Pipelines de données
Fiabilisez l'ingestion et le prétraitement pour que la récupération et l'entraînement ne s'arrêtent jamais.
FinOps pour OpenAI
Visualisez clairement l'utilisation des tokens, les coûts des fournisseurs et les arbitrages.
Résilience par défaut
Patterns de haute disponibilité, domaines de défaillance et dégradation progressive intégrés.
Validation en production
Tests de charge, exercices de chaos engineering et plans de rollback avant la mise en production.
ce qu'OpenAI coûte vraiment
Les factures de tokens cachent l'essentiel
Vous connaissez le total. Mais vous ignorez quelle équipe, quelle fonctionnalité ou quel client en est à l'origine. Nous changeons la donne.
Notre instrumentation au niveau du kernel attribue les dépenses IA et cloud à la source, sans modifier votre code. Reliez chaque appel d'API au workload qui le génère. Arbitrez avec de vrais chiffres.
Ce que nous construisons
Chaque mission part d'un problème, pas d'une fonctionnalité.
Workflows agentiques
OpenAI prend en charge le travail multi-étapes que votre équipe fait encore à la main.
Systèmes de connaissances et RAG
Des réponses ancrées dans vos données, pas sur le web ouvert.
Accélération du code et du SDLC
Revue, refactoring et migration plus rapides avec Codex dans la boucle.
Automatisation du support
Résolvez les tickets et réduisez le volume sans perdre le client.
Analyse de documents et de contrats
Extraction, synthèse et vérification à grande échelle.
Workloads sur mesure
Conçus autour de votre stack, de vos données et de vos SLO, pas d'un template.
Lancez-vous avec OpenAI
Nous cartographions vos priorités et le chemin le plus rapide vers la production.