Announcement
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.
Sehen Sie, was Ihre Coding-Agents auf Valar kosten – nach Modell und API-Key
Valar-Inferenz- und ValarCode-Ausgaben in Cloud Intelligence™, direkt neben Ihrer Cloud-Rechnung und Ihren anderen KI-Anbietern
Viele Unternehmen schätzen Valar, weil der Einstieg kaum Aufwand erfordert. Die Inference-API ist sowohl mit dem OpenAI- als auch mit dem Anthropic-Format kompatibel – bestehender Code funktioniert also, sobald Sie die Base-URL ändern.
ValarCode schaltet sich vor Claude Code, Cursor oder Codex und leitet jede Anfrage an ein passendes Modell weiter. Dabei entscheiden Sie, wie schnell Sie eine Antwort brauchen – und zahlen weniger, wenn eine Anfrage warten kann. Als wir es für diese Integration getestet haben, funktionierte alles auf Anhieb.
Gerade diese Einfachheit macht Kostentransparenz so wichtig. Ein Team verbindet seine Coding-Agents mit ValarCode, ein paar Services beginnen, die Inference-API aufzurufen – und innerhalb einer Woche verteilen sich die Kosten auf ein Dutzend API-Keys und auf die Modelle, die der Router für die einzelnen Anfragen ausgewählt hat. Das Valar-Dashboard stellt das gut dar, aber eben nur dort – getrennt vom Rest Ihrer KI- und Cloud-Ausgaben.
Das bekommen Sie
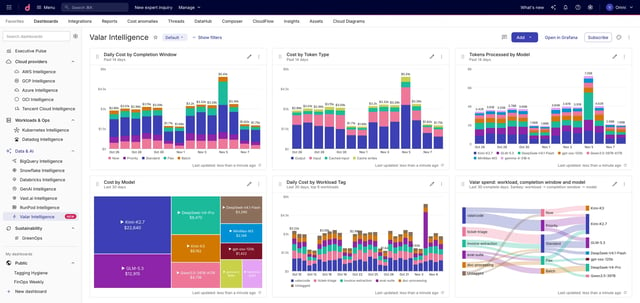
Ausgaben nach Modell und API-Key, pro Tag. Jede Zeile enthält das Modell, das die Anfragen bedient hat, den Entwickler des Modells (DeepSeek, GLM usw.) sowie den Namen des API-Keys, über den die Anfragen gestellt wurden. Benennen Sie Ihre Keys nach Teams oder Services, und Sie erhalten die Kosten pro Team – ganz ohne Tagging-Aufwand.
ValarCode wird unter dem Modell ausgewiesen, das tatsächlich zum Einsatz kam. ValarCode routet Anfragen, daher kann das Modell, das eine Anfrage bedient hat, von dem abweichen, das der Coding-Agent angefordert hat. Die Kosten werden dem Modell zugeordnet, das die Arbeit erledigt hat.
Token-Verbrauch als Metriken. Input-, Cached-Input- und Output-Tokens stehen neben den Kosten zur Verfügung – genug, um zu erkennen, wie viel Ihres Inputs aus dem Cache bedient wird und wie viel eine Million Tokens Sie pro Modell kostet.
Ein fester Platz in Ihrem GenAI-Reporting. Valar-Kosten erscheinen im AI Hub neben Ihren anderen KI-Anbietern sowie in Cloud-Analytics-Reports über die standardmäßigen Dimensionen und Labels.
Anfragen, die über Valar mit Ihrem eigenen Model-Provider-Key laufen, rechnet dieser Anbieter ab, nicht Valar – sie erscheinen also, sobald Sie den jeweiligen Anbieter verbinden. Erstellen Sie für diese Verbindung einen dedizierten Key mit Ablaufdatum. Cloud Intelligence™ liest damit ausschließlich Nutzungsdaten.
So starten Sie
- Erstellen Sie im Valar-Dashboard einen API-Key für diese Verbindung. Beide Key-Typen funktionieren. Siehe API-Key erstellen.
- Öffnen Sie in Cloud Intelligence™ den Bereich Integrations, suchen Sie Valar und fügen Sie den Key ein. Testen Sie die Verbindung und speichern Sie. Siehe Ihre Valar-Organisation verbinden.
- Cloud Intelligence™ importiert bis zu 90 Tage Historie und aktualisiert die Daten anschließend stündlich.
- Erstellen Sie einen Report, gruppiert nach Modell oder API-Key, oder öffnen Sie das GenAI-Intelligence-Dashboard. Die verfügbaren Felder finden Sie unter Reporting-Dimensionen.
Related documentation
- help.doit.com/docs/dashboards/ai-hub
- help.doit.com/docs/cloud-analytics/reports/report-dimensions-groupings-and-filters
- help.doit.com/docs/connect-third-party/connect-valar#create-api-key
- help.doit.com/docs/connect-third-party/connect-valar#connect-your-valar-organization
- help.doit.com/docs/connect-third-party/connect-valar#reporting-dimensions