Announcement
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.
Veja quanto seus agentes de código custam no Valar, por modelo e chave de API
Gastos com inferência do Valar e com o ValarCode no Cloud Intelligence™, lado a lado com sua fatura de nuvem e seus outros provedores de IA
Muitas empresas gostam do Valar porque é muito fácil começar a usar. A API de inferência é compatível com os formatos da OpenAI e da Anthropic, então o código que você já tem funciona só trocando a URL base.
O ValarCode fica na frente do Claude Code, Cursor ou Codex e direciona cada requisição para o modelo mais adequado. E você escolhe a rapidez com que precisa da resposta, pagando menos quando a requisição pode esperar. Quando testamos para esta integração, tudo funcionou de primeira.
Essa facilidade é justamente o motivo pelo qual a observabilidade de gastos importa. Um time aponta seus agentes de código para o ValarCode, alguns serviços começam a chamar a API de inferência e, em uma semana, o custo está espalhado por uma dúzia de chaves de API e pelo modelo que o roteador escolheu para cada requisição. O dashboard do Valar mostra isso bem, mas só ali, separado de todo o resto que você paga por IA e nuvem.
O que você ganha
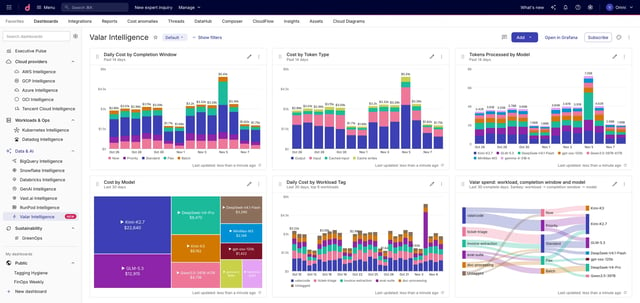
Gastos por modelo e chave de API, dia a dia. Cada linha traz o modelo que atendeu às requisições, o desenvolvedor do modelo (DeepSeek, GLM e assim por diante) e o nome da chave de API que as fez. Nomeie suas chaves com os nomes dos times ou serviços e você terá o custo por time sem nenhum trabalho de tagueamento.
ValarCode reportado sob o modelo que realmente executou. O ValarCode roteia as requisições, então o modelo que atendeu uma requisição pode ser diferente daquele que o agente de código pediu. O custo é atribuído ao modelo que fez o trabalho.
Uso de tokens como métricas. Tokens de entrada, de entrada em cache e de saída ficam disponíveis junto com o custo — o suficiente para ver quanto da sua entrada está sendo atendida pelo cache e quanto um milhão de tokens custa por modelo.
Um lugar nos seus relatórios de GenAI. Os custos do Valar aparecem no AI Hub junto com seus outros provedores de IA, e nos relatórios do Cloud Analytics por meio das dimensões e labels padrão.
Requisições que usam sua própria chave de provedor de modelo via Valar são cobradas por esse provedor, não pelo Valar, então elas aparecem quando você conecta esse provedor. Crie uma chave dedicada com data de expiração para esta conexão. O Cloud Intelligence™ só lê dados de uso com ela.
Comece agora
- No dashboard do Valar, crie uma chave de API para esta conexão. Os dois tipos de chave funcionam. Veja Criar uma chave de API.
- No Cloud Intelligence™, abra Integrações, localize Valar e cole a chave. Teste a conexão e salve. Veja Conectar sua organização Valar.
- O Cloud Intelligence™ importa até 90 dias de histórico e, depois, atualiza a cada hora.
- Crie um relatório agrupado por Modelo ou chave de API, ou abra o dashboard GenAI Intelligence. Os campos disponíveis estão listados em Dimensões de relatório.
Related documentation
- help.doit.com/docs/dashboards/ai-hub
- help.doit.com/docs/cloud-analytics/reports/report-dimensions-groupings-and-filters
- help.doit.com/docs/connect-third-party/connect-valar#create-api-key
- help.doit.com/docs/connect-third-party/connect-valar#connect-your-valar-organization
- help.doit.com/docs/connect-third-party/connect-valar#reporting-dimensions