Announcement
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.
Visualisez le coût de vos agents de codage sur Valar, par modèle et par clé API
Les dépenses d'inférence Valar et ValarCode dans Cloud Intelligence™, aux côtés de votre facture cloud et de vos autres fournisseurs d'IA
De nombreuses entreprises apprécient Valar pour sa simplicité de prise en main. L'API d'inférence est compatible avec les formats OpenAI et Anthropic : il suffit de modifier une URL de base pour que votre code existant fonctionne.
ValarCode se place devant Claude Code, Cursor ou Codex et achemine chaque requête vers le modèle le plus adapté. Vous choisissez aussi la rapidité de réponse souhaitée, en payant moins lorsqu'une requête peut attendre. Lors de nos tests pour cette intégration, tout a fonctionné du premier coup.
Cette simplicité explique aussi pourquoi l'observabilité des dépenses est essentielle. Une équipe dirige ses agents de codage vers ValarCode, quelques services commencent à appeler l'API d'inférence, et en une semaine le coût se retrouve réparti sur une douzaine de clés API et sur les modèles choisis par le routeur pour chaque requête. Le dashboard Valar l'affiche clairement, mais uniquement à cet endroit, séparé du reste de vos dépenses d'IA et de cloud.
Ce que vous obtenez
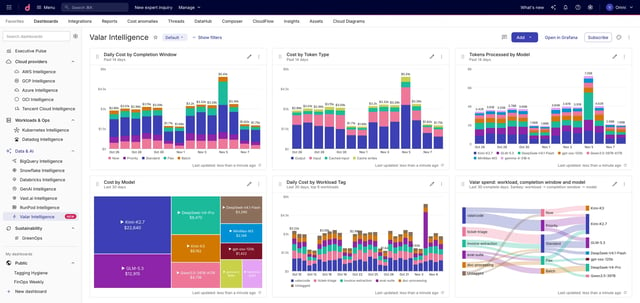
Les dépenses par modèle et par clé API, jour par jour. Chaque ligne indique le modèle ayant servi les requêtes, son développeur (DeepSeek, GLM, etc.) et le nom de la clé API utilisée. Nommez vos clés d'après vos équipes ou services, et vous obtenez le coût par équipe sans aucun travail de tagging.
ValarCode comptabilisé sous le modèle réellement utilisé. ValarCode achemine les requêtes : le modèle qui répond peut donc différer de celui demandé par l'agent de codage. Le coût est attribué au modèle qui a effectué le travail.
L'utilisation des tokens sous forme de métriques. Les tokens d'entrée, d'entrée mis en cache et de sortie sont disponibles aux côtés des coûts — de quoi voir quelle part de vos entrées est servie depuis le cache et ce que vous coûte un million de tokens par modèle.
Une place dans votre reporting GenAI. Les coûts Valar apparaissent dans l'AI Hub avec vos autres fournisseurs d'IA, ainsi que dans les rapports Cloud Analytics via les dimensions et libellés standard.
Les requêtes qui passent par Valar avec votre propre clé de fournisseur de modèles sont facturées par ce fournisseur, et non par Valar : elles apparaissent donc lorsque vous connectez ce fournisseur. Créez une clé dédiée avec une date d'expiration pour cette connexion. Cloud Intelligence™ l'utilise uniquement pour lire les données d'utilisation.
Pour commencer
- Dans le dashboard Valar, créez une clé API pour cette connexion. Les deux types de clés fonctionnent. Voir Créer une clé API.
- Dans Cloud Intelligence™, ouvrez Integrations, recherchez Valar et collez la clé. Testez la connexion, puis enregistrez. Voir Connecter votre organisation Valar.
- Cloud Intelligence™ récupère jusqu'à 90 jours d'historique, puis actualise les données toutes les heures.
- Créez un rapport groupé par modèle ou par clé API, ou ouvrez le dashboard GenAI Intelligence. Les champs disponibles sont listés dans Dimensions de reporting.
Related documentation
- help.doit.com/docs/dashboards/ai-hub
- help.doit.com/docs/cloud-analytics/reports/report-dimensions-groupings-and-filters
- help.doit.com/docs/connect-third-party/connect-valar#create-api-key
- help.doit.com/docs/connect-third-party/connect-valar#connect-your-valar-organization
- help.doit.com/docs/connect-third-party/connect-valar#reporting-dimensions