Announcement
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.
Scopra quanto costano i suoi coding agent su Valar, per modello e chiave API
La spesa per l'inferenza Valar e per ValarCode in Cloud Intelligence™, accanto alla fattura cloud e agli altri provider AI
Molte aziende apprezzano Valar perché per iniziare a usarlo basta davvero poco. L'API di inferenza è compatibile sia con il formato OpenAI sia con quello Anthropic, quindi il codice esistente funziona semplicemente cambiando la base URL.
ValarCode si colloca davanti a Claude Code, Cursor o Codex e instrada ogni richiesta verso il modello più adatto. E decide Lei quanto rapidamente ricevere la risposta, pagando meno quando una richiesta può attendere. Quando lo abbiamo testato per questa integrazione, tutto ha funzionato al primo tentativo.
È proprio questa semplicità a rendere importante l'osservabilità della spesa. Un team punta i propri coding agent su ValarCode, alcuni servizi iniziano a chiamare l'API di inferenza e nel giro di una settimana i costi si distribuiscono su una dozzina di chiavi API e sui modelli scelti dal router per ciascuna richiesta. La dashboard di Valar li mostra chiaramente, ma solo lì, separati dal resto della spesa per AI e cloud.
Cosa ottiene
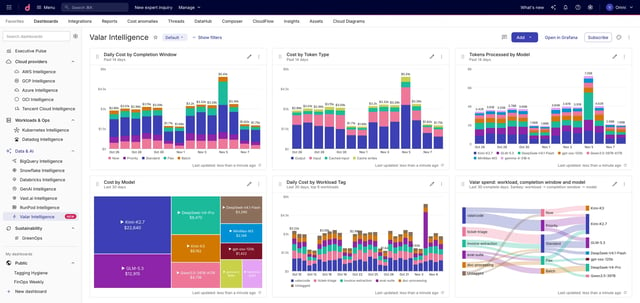
Spesa per modello e chiave API, giorno per giorno. Ogni riga riporta il modello che ha servito le richieste, lo sviluppatore del modello (DeepSeek, GLM e così via) e il nome della chiave API che le ha effettuate. Assegni alle chiavi i nomi dei team o dei servizi e otterrà il costo per team senza alcun lavoro di tagging.
ValarCode attribuito al modello che ha effettivamente eseguito la richiesta. ValarCode instrada le richieste, quindi il modello che serve una richiesta può essere diverso da quello richiesto dal coding agent. Il costo viene attribuito al modello che ha svolto il lavoro.
Il consumo di token sotto forma di metriche. I token di input, di input in cache e di output sono disponibili insieme ai costi: quanto basta per capire quale parte dell'input viene servita dalla cache e quanto le costa un milione di token per ciascun modello.
Un posto nel suo reporting GenAI. I costi di Valar compaiono nell'AI Hub insieme agli altri provider AI e nei report di Cloud Analytics tramite le dimensioni ed etichette standard.
Le richieste che passano per Valar utilizzando la sua chiave del provider del modello vengono fatturate da quel provider, non da Valar, quindi compariranno quando collegherà quel provider. Crei una chiave dedicata con scadenza per questa connessione: Cloud Intelligence™ la utilizza esclusivamente per leggere i dati di utilizzo.
Per iniziare
- Nella dashboard di Valar, crei una chiave API per questa connessione. Va bene qualsiasi tipo di chiave. Consulti Creare una chiave API.
- In Cloud Intelligence™, apra Integrations, individui Valar e incolli la chiave. Verifichi la connessione e salvi. Consulti Collegare la propria organizzazione Valar.
- Cloud Intelligence™ importa fino a 90 giorni di dati storici e poi si aggiorna ogni ora.
- Crei un report raggruppato per modello o per chiave API, oppure apra la dashboard GenAI Intelligence. I campi disponibili sono elencati in Dimensioni di reporting.
Related documentation
- help.doit.com/docs/dashboards/ai-hub
- help.doit.com/docs/cloud-analytics/reports/report-dimensions-groupings-and-filters
- help.doit.com/docs/connect-third-party/connect-valar#create-api-key
- help.doit.com/docs/connect-third-party/connect-valar#connect-your-valar-organization
- help.doit.com/docs/connect-third-party/connect-valar#reporting-dimensions