

De 60 % à 100 % de visibilité : Jupiter reprend la main sur ses dépenses d'infrastructure avec DoiT
- 26
- De fournisseurs intégrés
- From 60% to 100%
- De couverture des données
Si vous utilisez Amazon RDS, vous connaissez le scénario : une version de moteur qui tourne sans accroc depuis des années bascule discrètement en fin de support standard, et vous voilà face à une mise à niveau forcée ou à une facture d'Extended Support salée.
La tarification AWS Extended Support s'applique dès qu'une version majeure atteint sa fin de vie, et l'addition est lourde : un surcoût par vCPU-heure vient s'ajouter à vos dépenses RDS habituelles, appliqué automatiquement à chaque instance encore en version non supportée. Sur un parc de taille significative, manquer une date d'EOL ne serait-ce que d'un trimestre peut se traduire en silence par cinq à six chiffres de dépenses évitables.
L'information est techniquement disponible dans la documentation AWS, mais la gérer sur un parc composé de moteurs de bases de données variés est précisément le genre de corvée que personne ne traite vraiment avant que tout casse — d'autant que planifier une maintenance sur des bases RDS critiques s'accompagne généralement de délais incompressibles côté métier.
Raptive se trouvait précisément à ce carrefour. Son équipe avait commencé à évaluer ce qu'impliquerait de documenter et de suivre manuellement les moteurs RDS obsolètes sur l'ensemble de son parc — un travail chronophage, sans moyen intégré de rester à jour à mesure que de nouvelles dates d'EOL apparaissent.
Plutôt que de bâtir et de maintenir son propre système de suivi en interne, Raptive s'est tourné vers CloudFlow, le moteur d'automatisation de Cloud Intelligence™ dédié aux workflows FinOps et CloudOps.
Pour Raptive, l'enjeu consistait à suivre les moteurs RDS approchant la fin du support standard sur un parc de plus de 30 bases de données.
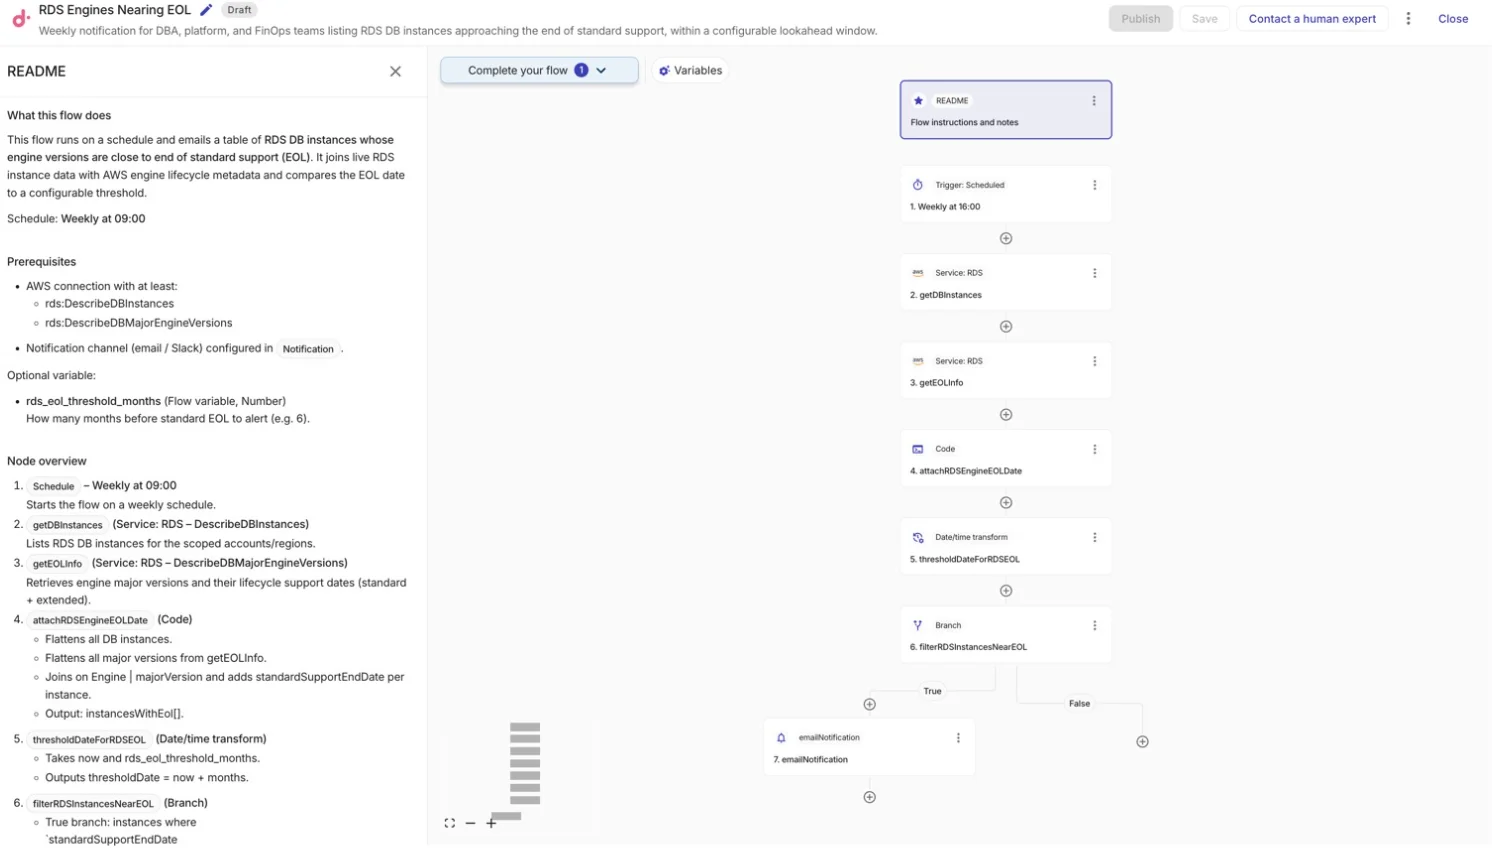
L'équipe a déployé un modèle DoiT CloudFlow qui automatise tout cela selon une planification définie. Le flow analyse l'ensemble des instances RDS sur tous les comptes et toutes les régions AWS disponibles, et envoie une alerte à un destinataire préconfiguré dès qu'un moteur RDS s'apprête à atteindre la fin du support standard dans les six prochains mois (paramétrable).
Le flow est aujourd'hui pleinement opérationnel et fournit chaque semaine à Raptive un rapport sur les moteurs de bases de données encore en version proche de la fin du support standard.
Les nouvelles alertes RDS End of Life de CloudFlow nous permettent d'être plus proactifs dans la mise à jour de nos instances de bases de données. Cette solution nous donne une visibilité interne en amont, ce qui nous laisse le temps de préparer les mises à niveau, au lieu de devoir les mener dans l'urgence en encaissant des coûts d'extended support.
Jon Fairbanks, Site Reliability Engineering Manager
Désormais averti suffisamment tôt des moteurs RDS bientôt obsolètes, Raptive dispose de la visibilité interne nécessaire pour planifier ses mises à niveau en amont, au lieu d'avoir à courir une fois le support terminé.
Un préavis de six mois transforme l'urgence en exercice de planification. Les équipes d'engineering ont le temps de programmer des fenêtres de maintenance, de tester la compatibilité applicative et de procéder aux mises à niveau à leur rythme, plutôt que d'être appelées en catastrophe la semaine où le support s'achève.
Aujourd'hui, le flow couvre automatiquement plus de 30 instances RDS sur l'ensemble des régions AWS de Raptive, et lui a permis d'éviter environ 10 k$ de coûts annuels d'extended support qui se seraient autrement accumulés en silence.
Raptive n'a plus besoin de mobiliser de ressources d'engineering pour construire ou maintenir ce système de suivi en interne, et peut s'appuyer sur Cloud Intelligence™ pour faire tourner le flow sur le long terme.
Envie de mettre cela en place dans votre propre environnement ? Le modèle RDS Engines Nearing EOL est disponible directement dans Cloud Intelligence™. Ouvrez CloudFlow, cliquez sur l'onglet Templates et recherchez "RDS Engines Nearing EOL" pour démarrer.
Découvrez CloudFlow et Cloud Intelligence™
Recommandations d'économies, planification des ressources, ressources inutilisées : agissez automatiquement.



On integrating DataHub, the DoiT team was very hands-on to the point where DoiT support put together the first ingestion script and pipeline to unlock us.
Kyle Espinola, Head of Platform Engineering
“PerfectScale gives us the confidence to automate Kubernetes optimization while letting our engineers focus on building what matters.”
Josh Zarrabi, Infrastructure Engineer
“Without PerfectScale by DoiT, I don't know how we would do it. We'd have to have twice the number of people on my team to stay on top of it. With PerfectScale, we can focus on the more strategic issues.”
David Adkins, Director of Software and Platform Engineering
Connecting IBM and AWS privately was the piece we needed to get right, and we wanted to move faster on it than we could on our own. DoiT worked through the options with us, found the subnet overlap that was breaking the routing, and made it stable. That unblocked everything else.
DevOps Lead, Software Projects

Attribute™'s platform is truly unique. We now have crystal-clear visibility into our cloud spend at the workload and tenant level, and that insight has already led to actionable savings and powerful insights as we further scale our service.
Paul White, VP of Engineering, Shasta Cloud
We have worked with DoiT for many years, and there has been an increasing number of capabilities and features in DoiT Cloud Intelligence. We've embedded features such as Cloud Analytics and Reports in our own FinOps processes, it's become core to what we do.
Martin Lee, Director of Operations
DoiT gave us the confidence to move from experimentation to production. They helped us understand the right way to build AI for the real world.
Milad Rezazadeh, CTO
Attribute™'s cost grouping technology took our cost visibility and allocation to a whole new level. Now, our teams are fully accountable for their budgets, significantly improving our cloud efficiency and helping us minimize unnecessary costs.
Eli Zilbershtein, Head of DevOps, Hippo
You can't tag a customer in a multi-tenant environment. Attribute™ finally shows us what each customer costs and what's driving those costs.
Omri Cohen, Director of Engineering, Platform

Attribute™'s data is truly unmatched. No other solution on the market could deliver the precise customer cost and usage profiles we needed in such a complex infrastructure. Within weeks, the data from Attribute™ transformed our understanding of cost structures, influencing key strategic decisions in pricing, renegotiations, and market positioning.
Jonathan Langer, COO, Claroty

Attribute™ simplified tracking customer costs in our multi-tenant environments. Customer cost measurement is now clear and standardized, and finance gets the business context they need. Integration was quick and required no changes.
Kfir Lippmann, CFO, Salt Security

Attribute™ translates complex cloud bills into actionable, business-centric insights that empower our engineering teams to take true ownership of their costs.
Balamurugan Mohandossgandhi, Head of IT and Infrastructure, PropertyGuru

This has let us get a better idea of what our cost of goods sold really is. It's not every day you come across something that delivers value as quickly as yours did for us. I was seeing useful insights inside the POC, and we had only deployed it to a couple of real clusters.
Jason Moore, Principal DevOps Engineer, Accrete AI
Let us show you what ships this week.