

Jupiter fecha uma lacuna de 20% a 40% na visibilidade dos gastos de infraestrutura com a DoiT
- 26
- Fornecedores com dados ingeridos
- From 60% to 100%
- Cobertura de dados
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.
Agora a Raptive recebe um aviso com seis meses de antecedência antes de qualquer engine do RDS expirar, evitando cerca de US$ 10 mil por ano em custos inesperados.
Se você roda qualquer coisa no Amazon RDS, já conhece o roteiro: uma versão de engine que você vinha rodando tranquilamente há anos cai silenciosamente no fim do suporte padrão e, de uma hora pra outra, você se vê diante de um upgrade forçado ou de uma conta salgada de Extended Support.
O preço do AWS Extended Support entra em vigor no momento em que uma versão major chega ao EOL, e não é barato — é um acréscimo por vCPU-hora em cima do seu gasto normal de RDS, aplicado automaticamente a toda instância que ainda esteja rodando uma versão sem suporte. Para uma frota de qualquer porte relevante, perder uma data de EOL por apenas um trimestre pode silenciosamente virar cinco ou seis dígitos de gasto evitável.
A informação até está lá na documentação da AWS, mas gerenciar isso em uma frota com diferentes engines de banco de dados é o tipo de trabalho braçal que ninguém encara de fato até as coisas quebrarem — ainda mais porque agendar manutenções em bancos RDS críticos costuma vir com atrasos inegociáveis do lado do negócio.
A Raptive estava chegando exatamente nessa encruzilhada. O time tinha começado a dimensionar o que seria preciso para documentar e acompanhar manualmente as engines RDS desatualizadas em sua frota — um esforço demorado e sem nenhuma forma nativa de se manter em dia conforme novas datas de EOL fossem surgindo.
Em vez de criar e manter um sistema de rastreamento próprio internamente, a Raptive recorreu ao CloudFlow, o motor de automação do Cloud Intelligence™ para workflows de FinOps e CloudOps.
Para a Raptive, o desafio era acompanhar as engines RDS que se aproximavam do fim do suporte padrão na sua frota de mais de 30 bancos de dados.
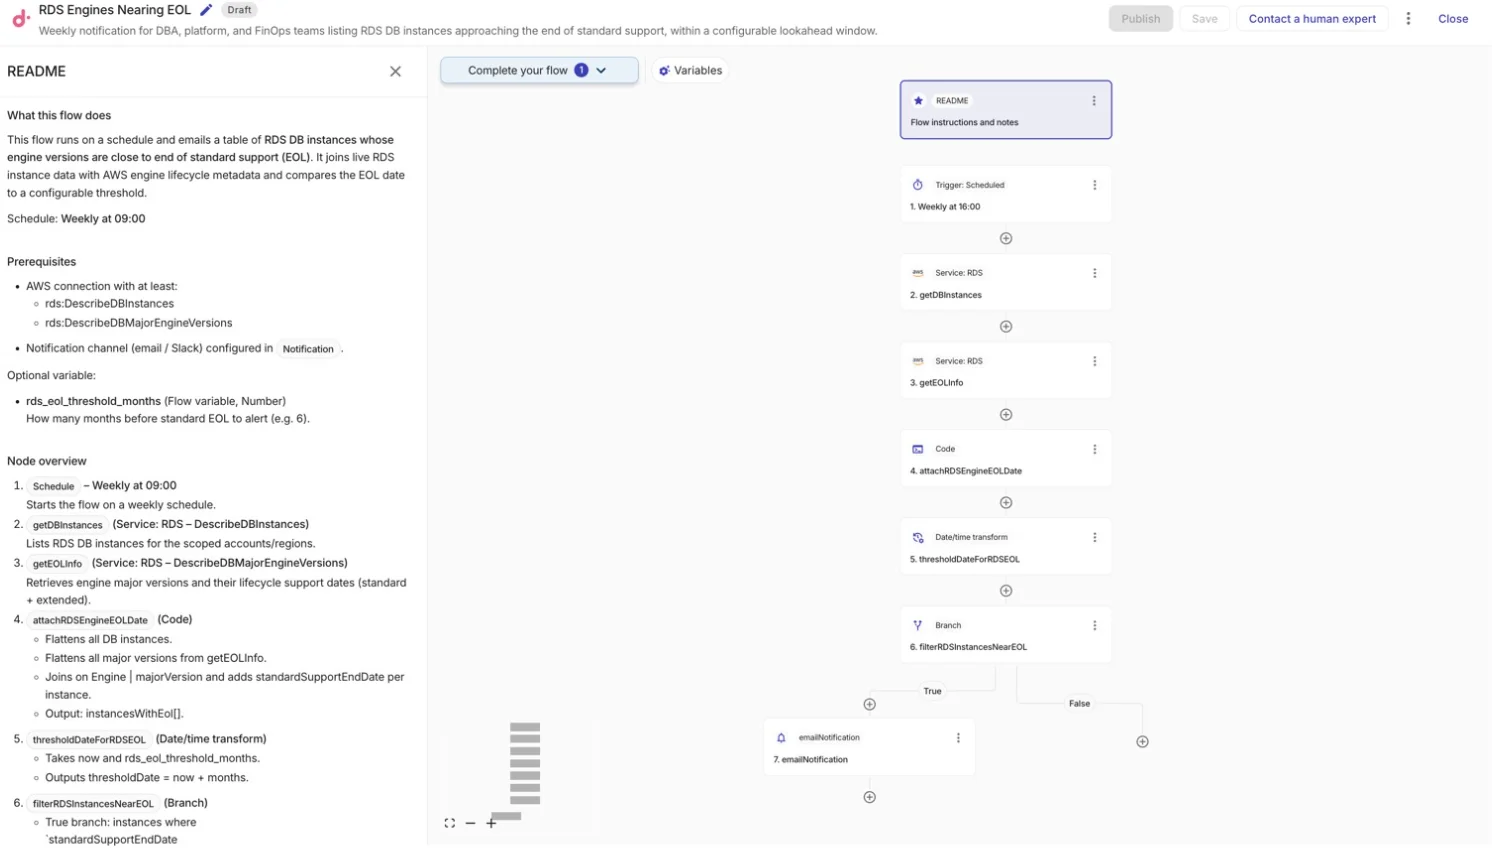
A empresa implantou um template do DoiT CloudFlow que automatiza esse processo de forma agendada. O fluxo varre todas as instâncias RDS em todas as contas e regiões da AWS disponíveis e dispara um alerta para um destinatário pré-configurado sempre que uma engine RDS estiver para chegar ao fim do suporte padrão nos próximos seis meses (configurável).
Hoje o fluxo está totalmente operacional e entrega à Raptive relatórios semanais sobre quais engines de banco ainda rodam versões próximas do fim do suporte padrão.
Os novos alertas de fim de vida do RDS no CloudFlow nos permitiram ser mais proativos em manter nossas instâncias de banco de dados atualizadas. A nova solução nos dá visibilidade interna com antecedência, para que possamos nos preparar para os upgrades, em vez de ter que atualizar sob pressão e ainda pagar custos de suporte estendido.
Jon Fairbanks, Site Reliability Engineering Manager
Com aviso suficiente sobre as engines RDS prestes a ficar desatualizadas, a Raptive agora tem a visibilidade interna para planejar upgrades com antecedência, em vez de correr atrás depois que o suporte termina.
Um aviso de seis meses transforma isso de uma emergência em um exercício de planejamento. Os times de engenharia ganham fôlego para agendar janelas de manutenção, testar a compatibilidade das aplicações e fazer o upgrade nos seus próprios termos, em vez de serem acionados na semana em que o suporte acaba.
Hoje, o fluxo cobre automaticamente mais de 30 instâncias RDS em todas as regiões da AWS usadas pela Raptive e já ajudou a empresa a evitar cerca de US$ 10 mil por ano em custos de suporte estendido que, de outra forma, teriam se acumulado silenciosamente.
A Raptive não precisa mais dedicar recursos de engenharia para criar ou manter esse sistema de rastreamento internamente e pode contar com o Cloud Intelligence™ para manter o fluxo rodando no longo prazo.
Quer configurar isso no seu próprio ambiente? O template RDS Engines Nearing EOL está disponível diretamente no Cloud Intelligence™. Basta abrir o CloudFlow, clicar na aba Templates e buscar por "RDS Engines Nearing EOL" para começar.
Saiba mais sobre o CloudFlow e o Cloud Intelligence™
Aplique recomendações de economia, agendamento de recursos e tratamento de recursos ociosos. Automaticamente.



On integrating DataHub, the DoiT team was very hands-on to the point where DoiT support put together the first ingestion script and pipeline to unlock us.
Kyle Espinola, Head of Platform Engineering
“PerfectScale gives us the confidence to automate Kubernetes optimization while letting our engineers focus on building what matters.”
Josh Zarrabi, Infrastructure Engineer
“Without PerfectScale by DoiT, I don't know how we would do it. We'd have to have twice the number of people on my team to stay on top of it. With PerfectScale, we can focus on the more strategic issues.”
David Adkins, Director of Software and Platform Engineering
Connecting IBM and AWS privately was the piece we needed to get right, and we wanted to move faster on it than we could on our own. DoiT worked through the options with us, found the subnet overlap that was breaking the routing, and made it stable. That unblocked everything else.
DevOps Lead, Software Projects

Attribute™'s platform is truly unique. We now have crystal-clear visibility into our cloud spend at the workload and tenant level, and that insight has already led to actionable savings and powerful insights as we further scale our service.
Paul White, VP of Engineering, Shasta Cloud
We have worked with DoiT for many years, and there has been an increasing number of capabilities and features in DoiT Cloud Intelligence. We've embedded features such as Cloud Analytics and Reports in our own FinOps processes, it's become core to what we do.
Martin Lee, Director of Operations
DoiT gave us the confidence to move from experimentation to production. They helped us understand the right way to build AI for the real world.
Milad Rezazadeh, CTO
Attribute™'s cost grouping technology took our cost visibility and allocation to a whole new level. Now, our teams are fully accountable for their budgets, significantly improving our cloud efficiency and helping us minimize unnecessary costs.
Eli Zilbershtein, Head of DevOps, Hippo
You can't tag a customer in a multi-tenant environment. Attribute™ finally shows us what each customer costs and what's driving those costs.
Omri Cohen, Director of Engineering, Platform

Attribute™'s data is truly unmatched. No other solution on the market could deliver the precise customer cost and usage profiles we needed in such a complex infrastructure. Within weeks, the data from Attribute™ transformed our understanding of cost structures, influencing key strategic decisions in pricing, renegotiations, and market positioning.
Jonathan Langer, COO, Claroty

Attribute™ simplified tracking customer costs in our multi-tenant environments. Customer cost measurement is now clear and standardized, and finance gets the business context they need. Integration was quick and required no changes.
Kfir Lippmann, CFO, Salt Security

Attribute™ translates complex cloud bills into actionable, business-centric insights that empower our engineering teams to take true ownership of their costs.
Balamurugan Mohandossgandhi, Head of IT and Infrastructure, PropertyGuru

This has let us get a better idea of what our cost of goods sold really is. It's not every day you come across something that delivers value as quickly as yours did for us. I was seeing useful insights inside the POC, and we had only deployed it to a couple of real clusters.
Jason Moore, Principal DevOps Engineer, Accrete AI
Let us show you what ships this week.