

Jupiter cierra una brecha de visibilidad del 20% al 40% en su gasto de infraestructura con DoiT
- 26
- Datos de proveedores integrados
- From 60% to 100%
- Cobertura de datos
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.
Raptive recibe un aviso con seis meses de anticipación antes de que cualquier motor de RDS expire, lo que le evita unos $10k al año en costos inesperados.
Si tienes algo corriendo en Amazon RDS, ya conoces el patrón: una versión de motor que llevas años usando sin problemas se queda sin soporte estándar casi sin que te des cuenta, y de un día para otro te enfrentas a una actualización forzada o a una factura considerable de Extended Support.
Los precios de AWS Extended Support se activan en el momento en que una versión mayor llega al EOL, y no son baratos: se trata de un recargo por vCPU-hora sobre tu gasto habitual de RDS, aplicado automáticamente a cada instancia que siga corriendo una versión sin soporte. En una flota de tamaño relevante, pasar por alto una fecha de EOL aunque sea por un trimestre puede traducirse, sin que nadie lo note, en un gasto evitable de cinco o seis cifras.
La información está en la documentación de AWS, sí, pero gestionarla en una flota con distintos motores de base de datos es de esas tareas tediosas que nadie aborda hasta que algo se rompe, sobre todo porque programar mantenimiento para bases de datos RDS críticas suele venir con demoras innegociables desde el lado del negocio.
Raptive estaba justo en esa encrucijada. Su equipo había empezado a evaluar lo que implicaría documentar y rastrear manualmente los motores de RDS desactualizados en toda su flota: un esfuerzo intensivo en tiempo y sin una forma integrada de mantenerse al día con las nuevas fechas de EOL.
En lugar de construir y mantener su propio sistema de seguimiento internamente, Raptive recurrió a CloudFlow, el motor de automatización de Cloud Intelligence™ para workflows de FinOps y CloudOps.
Para Raptive, el reto era hacerle seguimiento a los motores de RDS que se acercaban al fin del soporte estándar en su flota de más de 30 bases de datos.
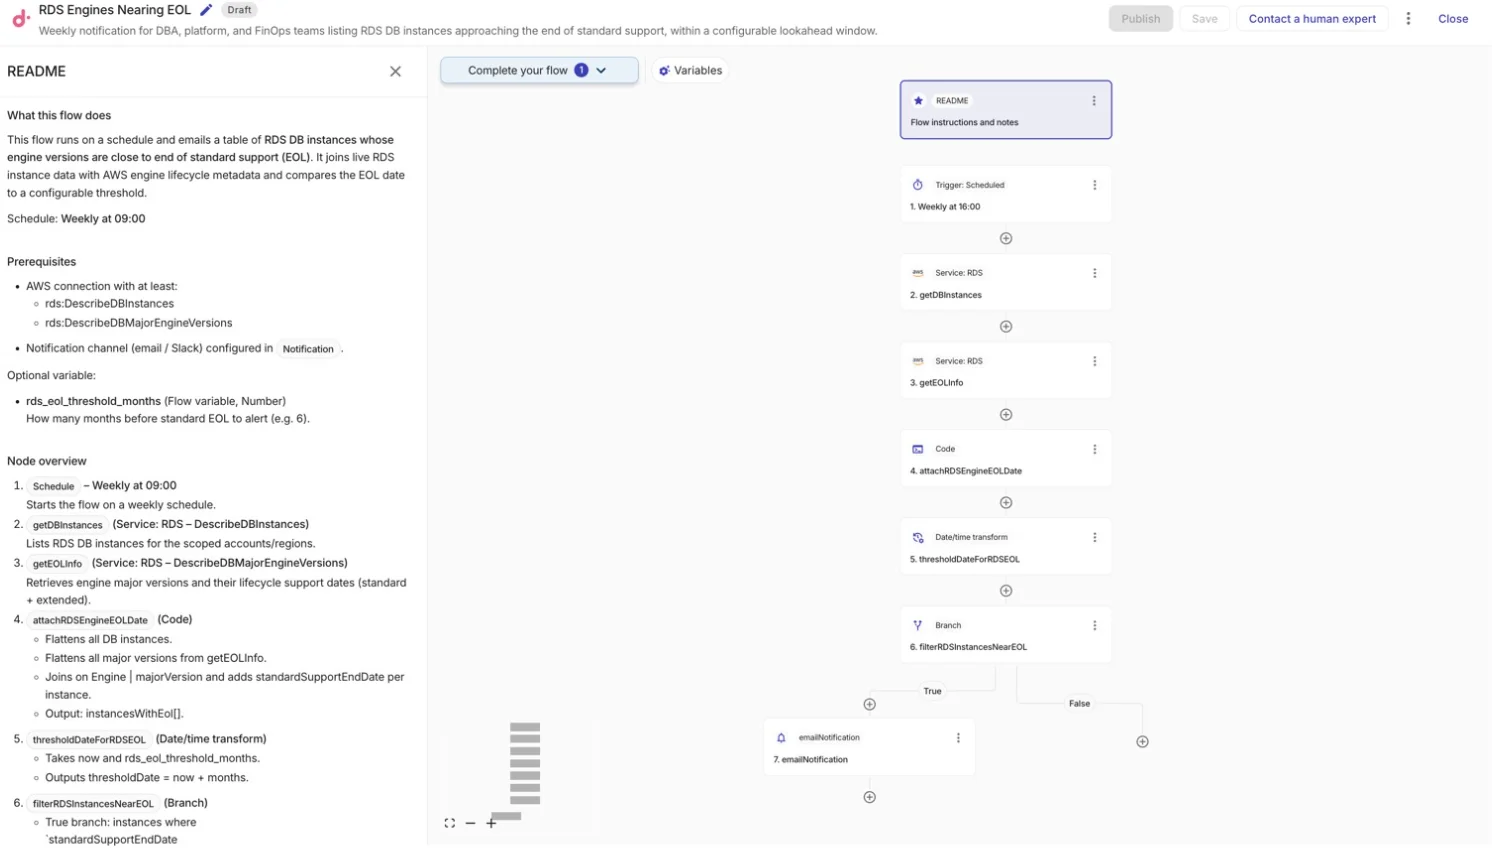
Desplegaron una plantilla de DoiT CloudFlow que automatiza la tarea de forma programada. El flujo escanea todas las instancias de RDS en todas las cuentas y regiones disponibles de AWS, y envía una alerta a un destinatario preconfigurado si un motor de RDS va a llegar al fin del soporte estándar en los próximos seis meses (configurable).
Hoy el flujo está totalmente operativo y le entrega a Raptive reportes semanales con los motores de base de datos que aún corren versiones próximas al fin del soporte estándar.
Las nuevas alertas de fin de vida de RDS en CloudFlow nos permitieron ser más proactivos a la hora de mantener nuestras instancias de base de datos al día. La nueva solución nos da visibilidad interna con tiempo para preparar las actualizaciones, en vez de tener que actualizar bajo presión asumiendo costos de soporte extendido.
Jon Fairbanks, Site Reliability Engineering Manager
Ahora que cuenta con suficiente anticipación sobre los motores de RDS próximos a quedar desactualizados, Raptive tiene la visibilidad interna para planear las actualizaciones con tiempo, en vez de salir corriendo cuando el soporte termina.
Un aviso con seis meses de anticipación transforma eso de una emergencia en un ejercicio de planeación. Los equipos de Engineering ganan margen para agendar ventanas de mantenimiento, probar la compatibilidad de las aplicaciones y actualizar a su ritmo, en lugar de recibir una alerta urgente la semana en que termina el soporte.
Hoy el flujo cubre automáticamente más de 30 instancias de RDS en todas las regiones de AWS de Raptive, y les ha ayudado a evitar cerca de $10k al año en costos de soporte extendido que, de otra forma, se habrían acumulado en silencio.
Raptive ya no necesita dedicar recursos de Engineering a construir o mantener ese sistema de seguimiento internamente, y puede apoyarse en Cloud Intelligence™ para mantener el flujo funcionando a largo plazo.
¿Quieres configurar esto en tu propio entorno? La plantilla RDS Engines Nearing EOL está disponible directamente en Cloud Intelligence™. Solo abre CloudFlow, haz clic en la pestaña Templates y busca "RDS Engines Nearing EOL" para empezar.
Conoce más sobre CloudFlow y Cloud Intelligence™
Actúa sobre recomendaciones de ahorro, programación de recursos y recursos inactivos. De forma automática.



On integrating DataHub, the DoiT team was very hands-on to the point where DoiT support put together the first ingestion script and pipeline to unlock us.
Kyle Espinola, Head of Platform Engineering
“PerfectScale gives us the confidence to automate Kubernetes optimization while letting our engineers focus on building what matters.”
Josh Zarrabi, Infrastructure Engineer
“Without PerfectScale by DoiT, I don't know how we would do it. We'd have to have twice the number of people on my team to stay on top of it. With PerfectScale, we can focus on the more strategic issues.”
David Adkins, Director of Software and Platform Engineering
Connecting IBM and AWS privately was the piece we needed to get right, and we wanted to move faster on it than we could on our own. DoiT worked through the options with us, found the subnet overlap that was breaking the routing, and made it stable. That unblocked everything else.
DevOps Lead, Software Projects

Attribute™'s platform is truly unique. We now have crystal-clear visibility into our cloud spend at the workload and tenant level, and that insight has already led to actionable savings and powerful insights as we further scale our service.
Paul White, VP of Engineering, Shasta Cloud
We have worked with DoiT for many years, and there has been an increasing number of capabilities and features in DoiT Cloud Intelligence. We've embedded features such as Cloud Analytics and Reports in our own FinOps processes, it's become core to what we do.
Martin Lee, Director of Operations
DoiT gave us the confidence to move from experimentation to production. They helped us understand the right way to build AI for the real world.
Milad Rezazadeh, CTO
Attribute™'s cost grouping technology took our cost visibility and allocation to a whole new level. Now, our teams are fully accountable for their budgets, significantly improving our cloud efficiency and helping us minimize unnecessary costs.
Eli Zilbershtein, Head of DevOps, Hippo
You can't tag a customer in a multi-tenant environment. Attribute™ finally shows us what each customer costs and what's driving those costs.
Omri Cohen, Director of Engineering, Platform

Attribute™'s data is truly unmatched. No other solution on the market could deliver the precise customer cost and usage profiles we needed in such a complex infrastructure. Within weeks, the data from Attribute™ transformed our understanding of cost structures, influencing key strategic decisions in pricing, renegotiations, and market positioning.
Jonathan Langer, COO, Claroty

Attribute™ simplified tracking customer costs in our multi-tenant environments. Customer cost measurement is now clear and standardized, and finance gets the business context they need. Integration was quick and required no changes.
Kfir Lippmann, CFO, Salt Security

Attribute™ translates complex cloud bills into actionable, business-centric insights that empower our engineering teams to take true ownership of their costs.
Balamurugan Mohandossgandhi, Head of IT and Infrastructure, PropertyGuru

This has let us get a better idea of what our cost of goods sold really is. It's not every day you come across something that delivers value as quickly as yours did for us. I was seeing useful insights inside the POC, and we had only deployed it to a couple of real clusters.
Jason Moore, Principal DevOps Engineer, Accrete AI
Let us show you what ships this week.