
Cloud Intelligence™
LLMjacking : quand des attaquants font tourner des LLM sur votre facture AWS
Les enseignements des compromissions Bedrock de 2026, les contrôles AWS qui les stoppent et comment configurer DoiT Cloud Intelligence en système d'alerte précoce
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.
À propos de l'auteur : Richard Kang est APJ Field Engineer Lead, basé à Singapour. À propos des données : les chiffres d'incidents de cet article proviennent de cas de LLMjacking sur AWS traités par l'équipe support de DoiT entre juin et octobre 2026. Les détails clients sont anonymisés et les montants en dollars sont ceux rapportés dans chaque cas.
Un compte sandbox qui coûte normalement 120 $ par jour génère 85 000 $ de facturation en quatorze heures. Un compte membre dormant, inactif depuis onze mois, accumule 75 000 $ avant que quiconque n'ouvre la facture. Le compte d'un distributeur européen passe de quelques centaines de dollars par mois à 522 000 $ en moins de deux jours.
Aucun de ces attaquants n'a volé de données ni déployé de ransomware. Ils ont dérobé des identifiants cloud et les ont utilisés pour appeler les grands modèles de langage les plus coûteux d'Amazon Bedrock, puis ont laissé la facture à la victime. C'est le LLMjacking. En 2026, il est devenu l'un des incidents de sécurité les plus fréquents, et les plus coûteux, traités par l'équipe support de DoiT.
Cet article explique le fonctionnement de l'attaque et ce que nous avons observé dans les incidents de cette année. Il détaille ensuite les contrôles AWS qui permettent de la prévenir. Enfin, il montre comment configurer DoiT Cloud Intelligence™ (DCI) pour être prévenu par une alerte plutôt que par votre facture.
Qu'est-ce que le LLMjacking ?
La Sysdig Threat Research Team a forgé le terme en mai 2024. Elle a observé des attaquants exploiter une application Laravel vulnérable, en extraire des identifiants AWS et sonder Amazon Bedrock ainsi que neuf autres services d'IA hébergée (Sysdig, 2024). Sur le plan opérationnel, c'est du cryptojacking avec une autre marchandise : l'attaquant revend la capacité LLM payante de quelqu'un d'autre au lieu de miner des cryptomonnaies.
Le marché a mûri depuis. Sysdig a documenté des services de reverse proxy qui mutualisent les comptes volés et vendent un accès "illimité" aux modèles (Sysdig, 2026). Elle a aussi vu des attaquants utiliser des capacités de modèles volées pour alimenter des outils offensifs automatisés (Sysdig, juin 2026). Les équipes de renseignement sur les menaces de Google signalent le même schéma sur Google Cloud (Google Cloud Threat Horizons).
Ce que nous avons observé en 2026
Sur l'ensemble des cas de LLMjacking sur AWS que DoiT a aidé ses clients à traiter cette année :
- Les frais non autorisés signalés totalisent environ 1,4 million de dollars. L'incident médian s'élevait à environ 72 000 $, le plus important à 522 000 $.
- Des pics de 80 000 à 113 000 $ par jour étaient fréquents. Les attaquants se déploient sur toutes les régions activées et choisissent les modèles les plus chers. Les variantes de Claude Opus représentaient l'essentiel de la dépense dans presque tous les cas.
- La plupart des incidents ont commencé par une clé d'accès utilisateur IAM de longue durée. Ces clés étaient généralement vieilles de plusieurs années, surprivilégiées et partagées entre pipelines CI, fichiers de configuration ou fichiers d'identifiants d'agents. Deux cas ont débuté par une prise de contrôle du compte root. Dans l'un d'eux, l'adresse e-mail root était rattachée à un domaine expiré que l'attaquant a réenregistré, avant de réinitialiser le mot de passe et de configurer son propre MFA.
- Seuls deux incidents ont d'abord été détectés par la supervision du client ou une alerte DoiT. Tous les autres l'ont appris autrement : la facture, une notification de sécurité AWS ou une restriction de compte. Certains ont reçu un e-mail AWS Marketplace inattendu de type "merci pour votre abonnement".
Anatomie d'une attaque
Les détails varient d'un cas à l'autre, mais la plupart des attaques suivent les mêmes étapes.
1. Obtenir un identifiant. Les clés d'accès IAM divulguées dominent. Dans plusieurs cas, les preuves pointaient vers des scanners de secrets automatisés. La même clé a été utilisée par plusieurs outils depuis plusieurs pays, y compris des appels de validation de TruffleHog. Les autres points d'entrée : une application interne accidentellement exposée sur Internet, une politique de confiance de rôle autorisant des comptes externes, et des identifiants root.
2. Mener une reconnaissance discrète, parfois pendant des semaines. Les attaquants appellent GetCallerIdentity, énumèrent IAM et les quotas de service, et listent les modèles de fondation disponibles dans chaque région. Dans un cas, la reconnaissance a commencé 17 jours avant le pic de dépenses. Certains attaquants vérifient GetModelInvocationLoggingConfiguration pour savoir si vous journalisez les prompts (référence API AWS). L'un d'eux a ouvert la console AWS, vérifié qui recevait les notifications AWS Budgets du compte et modifié un budget avant de se mettre au travail.
3. Obtenir une session console et assurer la persistance. sts:GetFederationToken transforme une clé d'accès en session console sans MFA. Les attaquants créent de nouvelles clés d'accès sur des utilisateurs existants, ajoutent des utilisateurs à des groupes admin ou créent des utilisateurs IAM servant de porte dérobée.
4. Activer les modèles. AWS a supprimé l'étape explicite d'activation des modèles en octobre 2025, et les modèles serverless sont désormais disponibles par défaut, sous réserve d'IAM (AWS). Les modèles tiers comme Claude sont facturés via AWS Marketplace. En pratique, tout principal autorisé à invoquer un modèle peut y abonner votre compte. Nous avons vu huit contrats Marketplace acceptés en douze secondes.
5. Monétiser à plein régime. Les requêtes partent vers toutes les régions activées et passent par des profils d'inférence inter-régions pour contourner les quotas par région. AWS en limite la majorité (2,3 millions sur 2,58 millions d'appels dans un cas), et vous payez le reste. Un trafic intensif de prompt cache est une signature courante d'un proxy de revente servant de nombreux utilisateurs finaux.
6. Monter des activités annexes. Des attaquants ont utilisé le même accès pour envoyer des dizaines de milliers d'e-mails de spam via Amazon SES. D'autres ont acheté un GPU Capacity Block à date future ou lancé des notebooks SageMaker et des flottes EC2. Dans un cas, le spam SES a commencé deux jours avant la facture Bedrock, et personne ne surveillait le volume d'envoi.
Pourquoi la facture est souvent la première alerte
Le LLMjacking est difficile à repérer avec une supervision des coûts classique, pour trois raisons structurelles :
- La dépense ne ressemble pas à "Amazon Bedrock". AWS Marketplace facture chaque modèle tiers sur Bedrock comme un produit distinct, par exemple "Claude Opus 5 (Amazon Bedrock Edition)". Un budget ou un dashboard filtré sur le service Amazon Bedrock peut ne rien afficher du tout.
- Chaque nouveau modèle est un service tout neuf, sans historique. La détection d'anomalies par machine learning apprend ce qui est normal à partir de votre historique de dépenses. C'est vrai d'AWS Cost Anomaly Detection comme de DCI. La détection d'anomalies de DCI basée sur la facturation requiert une référence de 14 jours avant de classer quoi que ce soit comme anormal (DoiT Help Center). Un modèle que votre compte n'a jamais utilisé n'a pas de référence, et les attaquants répartissent la dépense sur de nombreux modèles.
- Les données de facturation arrivent en différé. Les données de coûts AWS mettent 24 à 72 heures à atteindre tout outil en aval, DCI compris (DoiT Help Center). À 100 000 $ par jour, ce délai coûte cher.
La détection d'anomalies reste utile. Elle a signalé l'attaque dans certains cas, et elle repère les abus EC2 et GPU qui l'accompagnent souvent. Mais elle ne peut pas être votre seule alarme antifraude. Il vous faut des contrôles de prévention dans AWS et des alertes à seuil qui n'ont pas besoin de référence.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Partie 1 : les contrôles AWS qui préviennent le LLMjacking
Supprimez les identifiants qui valent la peine d'être volés
- Cessez d'émettre des clés utilisateur IAM de longue durée. Utilisez IAM Identity Center pour les personnes. Donnez aux workloads des rôles IAM avec identifiants temporaires : OIDC pour GitHub Actions, IRSA ou EKS Pod Identity, et des profils d'instance. Les bonnes pratiques IAM d'AWS sont explicites à ce sujet.
- Auditez les clés que vous avez déjà. Supprimez les clés inutilisées depuis 90 jours ; ne vous contentez pas de les désactiver. AWS exigera de toute façon leur suppression après un incident. Ne placez jamais de clés partagées dans des variables CI, des values Helm ou des fichiers d'identifiants d'agents/MCP.
- Traitez les clés API Bedrock comme des secrets. Privilégiez les clés de courte durée, valables jusqu'à 12 heures, et inventoriez et restreignez toutes les clés de longue durée (AWS).
- Activez le scan de secrets et la protection push dans votre gestion de code source (GitHub). Si AWS attache la politique
AWSCompromisedKeyQuarantineV3à l'un de vos utilisateurs, lancez la réponse à incident. La politique limite ce que la clé peut faire, mais elle n'élimine pas l'attaquant (AWS).
Protégez le compte root
Utilisez un MFA matériel, aucune clé d'accès root et une adresse e-mail root sur un domaine que vous contrôlez et surveillez activement. Configurez les contacts alternatifs SECURITY et OPERATIONS sur chaque compte, y compris les comptes dormants, pour que les avertissements d'AWS atteignent quelqu'un qui les lit.
Placez des garde-fous au niveau de l'Organization
Le principe du moindre privilège IAM doit limiter chaque workload aux modèles et régions spécifiques dont il a besoin (exemples de politiques AWS). Les service control policies ajoutent ensuite un filet de sécurité qu'un principal compromis ne peut pas retirer. Voici un point de départ, à tester d'abord dans une OU hors production :
{ "Version": "2012-10-17", "Statement": [ { "Sid": "DenyMarketplaceSubscribeExceptPlatformRole", "Effect": "Deny", "Action": "aws-marketplace:Subscribe", "Resource": "*", "Condition": { "ArnNotLike": { "aws:PrincipalArn": "arn:aws:iam::*:role/ai-platform-admin" } } }, { "Sid": "DenyBedrockOutsideApprovedRegions", "Effect": "Deny", "Action": "bedrock:*", "Resource": "*", "Condition": { "StringNotEquals": { "aws:RequestedRegion": ["us-east-1", "us-west-2"] } } }, { "Sid": "DenyFederationTokenConsoleBypass", "Effect": "Deny", "Action": "sts:GetFederationToken", "Resource": "*" } ]}Quelques précautions. Les profils d'inférence inter-régions routent les requêtes vers d'autres régions : validez donc la condition de région par rapport aux profils que vous utilisez réellement (AWS). Certains comptes ne devraient jamais utiliser d'IA générative : sandboxes, comptes dormants et la plupart des comptes de production hors de votre plateforme IA. Pour ceux-là, un deny pur et simple sur bedrock:* est plus facile à gérer et plus sûr.
Limitez la vitesse à laquelle l'argent peut sortir
- Abaissez les quotas de tokens par minute de Bedrock au besoin réel de chaque workload, et exigez une approbation pour toute augmentation (AWS). Un quota plafonne le débit, pas le total, mais il vous fait gagner du temps.
- Cantonnez l'expérimentation à des comptes cloisonnés dotés de leurs propres budgets.
Journalisez et détectez
- Un trail CloudTrail d'organisation multi-régions livré dans un compte d'archivage de logs verrouillé.
- La journalisation des invocations de modèles Bedrock pour les workloads approuvés (AWS).
- Amazon GuardDuty dans chaque compte et chaque région, avec les protections liées à l'IA activées. Après un incident, AWS a vérifié la présence de services de sécurité dans le compte membre affecté, pas seulement dans le compte de gestion.
- Des alertes sur les signaux apparus tôt dans des incidents réels :
- nouveaux contrats Marketplace
- appels
GetFederationToken CreateAccessKeyappelé par un rôle assumé- connexions root ou changements de MFA
- hausses soudaines du volume d'envoi SES
Partie 2 : configurer DoiT Cloud Intelligence comme système d'alerte précoce
DCI ne remplacera ni GuardDuty ni CloudTrail. Sa valeur ici tient au fait qu'il s'agit d'un plan de contrôle des coûts extérieur à vos comptes AWS. Un attaquant détenant vos clés AWS peut lire et modifier AWS Budgets, et nous en avons vu un le faire. Il ne peut pas toucher aux alertes et budgets que vous avez configurés dans DCI.
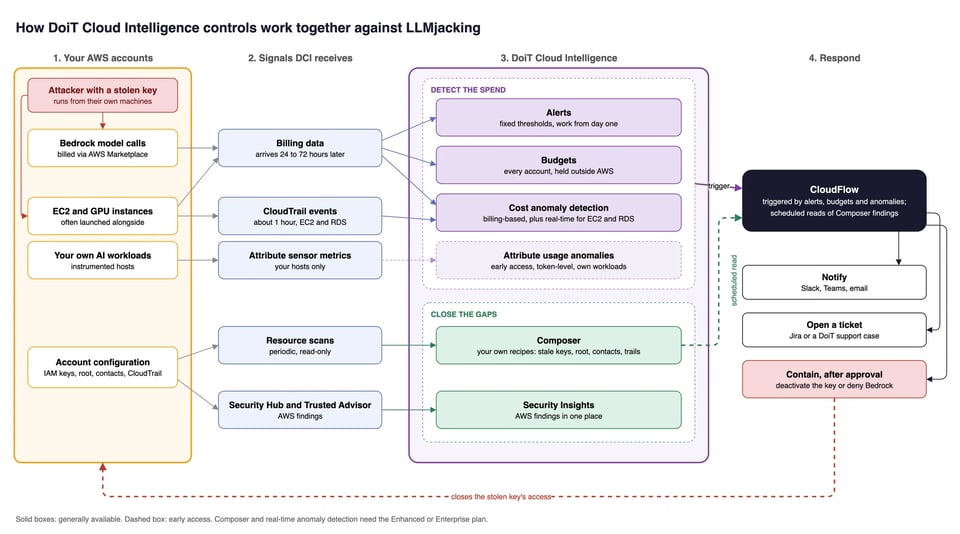
Les alertes, les budgets et la détection d'anomalies surveillent la dépense. Composer et Security Insights ferment les brèches qu'exploitent les attaquants. CloudFlow transforme chacun d'eux en notification, en ticket ou en action de confinement approuvée.
1. Des alertes à seuil qui n'ont pas besoin de référence
Les alertes se déclenchent sur une règle fixe : elles fonctionnent dès le premier jour, même sur un modèle que vous n'avez jamais utilisé. C'est le contrôle DCI le plus fiable contre le LLMjacking.
- Créez une allocation regroupant toutes les dépenses de modèles d'IA : Amazon Bedrock et les produits Marketplace "(Amazon Bedrock Edition)". Les nouveaux modèles y sont alors intégrés automatiquement, et vos alertes ne ratent pas silencieusement le lancement de modèle du mois prochain.
- Alerte de dépense quotidienne par compte : limitez-la à cette allocation, avec Metric sur Cost et Interval sur Daily. Définissez la condition sur
is > $X, où X vaut deux à trois fois une journée normale. Activez Evaluate for each: Account pour qu'une seule règle couvre tous les comptes. - Alerte "doit rester à zéro" : pour les sandboxes, les comptes dormants et tout ce qui n'exécute pas de workloads d'IA, alertez à
> $10par jour. - Variation d'un jour à l'autre :
percentage change is > 100%. - Alerte de prévision : mensuelle,
is forecasted to be >votre dépense IA prévue.
Acheminez les alertes par e-mail et vers un canal Slack que quelqu'un surveille vraiment (envoi des alertes vers Slack).
2. Des budgets sur chaque compte, surtout les plus discrets
Placez un budget mensuel récurrent sur chaque compte AWS, avec des seuils à 50 %, 85 % et 100 %. Les suggestions de budget peuvent les dimensionner pour vous. Ajoutez un budget quotidien sur l'allocation IA comme second signal d'alerte, facile à lire. Les comptes dormants et sandbox sont les cibles préférées des attaquants, précisément parce que personne ne leur affecte de budget. Un compte à 0 $ avec un budget de 50 $ est une excellente alarme.
Les budgets n'arrêteront pas la dépense, mais ils vous en informeront depuis l'extérieur du compte compromis.
3. Réglez la détection d'anomalies pour qu'elle vous parvienne vraiment
La détection d'anomalies de coûts garde toute sa place, surtout pour le volet EC2, GPU et SageMaker d'une attaque. Trois réglages comptent :
- Élargissez le filtre de sévérité. Les notifications par e-mail sont limitées par défaut au niveau Critical. Réglez-les sur "Warning and above" ou "All severity levels" (paramètres de notification).
- Activez la renotification, pour qu'une anomalie active qui continue de croître vous relance.
- Vérifiez qu'un destinataire est configuré. Dans plus d'un incident, DCI a détecté l'anomalie mais personne n'en a entendu parler. Aucune cible de notification n'était définie.
Sur les plans Enhanced et Enterprise, activez la détection d'anomalies en temps réel pour AWS. Elle s'appuie sur CloudTrail et remonte l'information en une heure environ. Elle couvre aujourd'hui EC2 et RDS plutôt que Bedrock. Cela détecte tout de même le volet GPU et instances de l'attaque, qui accompagne souvent l'abus de modèles. Vous pouvez aussi activer la détection d'anomalies sur l'allocation IA elle-même (supervision des allocations).
Si vous instrumentez vos workloads d'IA avec Attribute, DoiT propose aussi, en accès anticipé, des anomalies d'usage au niveau des tokens. Elles peuvent signaler un workload hors de contrôle plus vite que les données de facturation. Elles ne voient que le trafic de vos propres hôtes instrumentés : elles ne détecteront donc pas une clé volée utilisée depuis la machine d'un attaquant.
4. Automatisez la première réponse avec CloudFlow
CloudFlow peut se déclencher sur les alertes DCI, les seuils de budget et les anomalies de coûts, ce qui transforme une notification en action :
- Alerte → Slack → approbation → confinement. Quand l'alerte Bedrock se déclenche, publiez le compte et le montant dans votre canal d'incident. Puis, après approbation humaine, exécutez une action AWS : désactivez la clé d'accès suspectée, ou attachez un deny explicite sur
bedrock:InvokeModel*etbedrock:Converse*. Les étapes d'approbation évitent qu'un faux positif ne mette la production hors service. - Détection de première utilisation d'un service. Un modèle de flow planifié signale la première dépense sur tout service ou SKU AWS. Cela comble la lacune des nouveaux modèles décrite plus haut.
- Révocation des clés API des fournisseurs d'IA. Un modèle déclenché par webhook, avec approbation intégrée, supprime les identifiants Bedrock de longue durée (ainsi que les clés OpenAI, Anthropic ou Gemini). Vous pouvez l'appeler depuis EventBridge, votre SIEM ou un finding GuardDuty (tutoriel).
Toute action de confinement exige que le rôle CloudFlow du compte cible dispose des permissions IAM correspondantes. Décidez de ces permissions avant un incident.
5. Fermez les brèches avant qu'un attaquant ne les trouve
Security Insights intègre les findings d'AWS Security Hub et de Trusted Advisor : clés d'accès jamais renouvelées, comptes root sans MFA, comptes sans GuardDuty ni CloudTrail. Presque tous les incidents décrits ci-dessus ont commencé par l'un de ces problèmes.
Ces findings reposent sur les règles génériques d'AWS. Composer vous permet d'écrire les vôtres, sur les plans Enhanced et Enterprise. C'est le moteur de politiques de DCI. Il analyse les ressources de chaque compte connecté et les confronte à des recettes, c'est-à-dire des règles que vous construisez sans code. Vous pouvez dupliquer une recette DoiT et la modifier, ou décrire le contrôle à l'assistant IA. Les correspondances apparaissent comme des Security insights.
Voici comment les brèches à l'origine des incidents de cette année se traduisent en recettes que vous pouvez créer dès aujourd'hui :
| Brèche observée dans les incidents | Recette à créer | Données lues par Composer |
|---|---|---|
| Des clés vieilles de plusieurs années, oubliées de tous | Clés d'accès inutilisées depuis 90 jours, ou jamais utilisées | Date de dernière utilisation des clés d'accès |
| Des utilisateurs admin avec des clés de longue durée | Utilisateurs avec politiques admin et au moins une clé active | Politiques utilisateur et clés d'accès |
| Prise de contrôle du compte root | Root sans MFA, ou avec une clé d'accès | Rapport d'identifiants IAM |
| Des avertissements AWS envoyés à personne | Comptes sans contact alternatif de sécurité | Contacts du compte |
| Des lacunes dans la piste d'audit | Trails non multi-régions, non à l'échelle de l'organisation ou sans journalisation | Statut des trails CloudTrail |
| Des clés appelant Bedrock depuis le mauvais endroit | Clés utilisées en dernier pour Bedrock dans des comptes hors de votre liste d'autorisation IA | Service et région de dernière utilisation des clés |
La dernière ligne est ce qui rapproche le plus Composer de la détection d'abus. Une clé d'un compte sandbox dont la dernière utilisation concerne Bedrock mérite un examen, même si la dépense n'a pas encore bougé.
Pour agir sur les findings, planifiez un CloudFlow qui lit les Security findings ouverts via le nœud Composer Insights. Publiez-les sur Slack ou ouvrez un ticket chaque matin. Pour les clés obsolètes, ajoutez une étape d'approbation qui désactive la clé une fois que son propriétaire confirme qu'elle est inutilisée.
Composer effectue des analyses périodiques : c'est donc un contrôle d'hygiène plutôt qu'une alarme d'attaque. Il ne vérifie ni le statut de GuardDuty ou Security Hub, ni la journalisation des invocations Bedrock, ni les clés API Bedrock, ni le contenu des SCP. Security Insights et AWS Config couvrent ces aspects. Utilisez Composer pour fermer les portes par lesquelles les attaquants sont passés cette année, et conservez les alertes à seuil ci-dessus pour la dépense elle-même.
Si cela arrive malgré tout
Lancez le confinement dès que vous soupçonnez une compromission. N'attendez ni une alerte d'anomalie ni les chiffres de facturation définitifs.
- Confinez d'abord. Désactivez, puis supprimez, les clés d'accès compromises. Révoquez les sessions de rôle actives avec une politique de deny conditionnée sur
aws:TokenIssueTime, et désactivez toute clé API Bedrock suspecte. S'il vous faut un outil radical, une SCP d'urgence refusantbedrock:*sur le compte affecté stoppe l'hémorragie (elle bloque aussi l'usage légitime de Bedrock). Attendez-vous à ce que des appels continuent d'aboutir quelques minutes après la désactivation d'une clé. - Traquez la persistance. Cherchez de nouveaux utilisateurs IAM, clés d'accès, rôles et changements de politiques de confiance, contrats Marketplace, identités SES, Capacity Blocks et instances dans chaque région. Renouvelez chaque clé potentiellement exposée, pas seulement celle qu'AWS a signalée. Nous avons vu une deuxième vague arriver six jours après l'ouverture d'un incident, via une clé que personne n'avait renouvelée.
- Préservez les preuves. Exportez CloudTrail (l'Event History ne conserve que 90 jours), les logs d'invocation, un inventaire des ressources et un export des coûts par service.
- Répondez à AWS avant l'échéance. Les notifications de sécurité AWS laissent généralement cinq jours avant la suspension des services. Les restrictions peuvent tomber plusieurs jours après l'incident et affecter des services de production comme Lambda, ECS et EC2.
- Demandez explicitement l'ajustement de facturation. Dans les cas que nous avons vus, AWS attend au moins deux contrôles de surveillance des coûts, comme AWS Budgets et Cost Anomaly Detection. La présence du MFA root, de GuardDuty ou de Security Hub est également attendue. Ces points sont vérifiés dans le compte affecté. Les contrats Marketplace créés par l'attaquant doivent être résiliés. Les issues ont varié : crédits complets, crédits partiels ou refus. Le processus a pris de deux à douze semaines. Une chronologie claire, un confinement rapide et des preuves complètes font la différence. AWS a aussi indiqué qu'il pourrait ne pas examiner les factures futures si les contrôles ne sont pas en place.
Si DoiT est le revendeur de votre compte AWS, ouvrez un ticket de support DoiT dès que vous soupçonnez une compromission. Notre équipe assure la coordination avec AWS sur le dossier de sécurité et la demande d'ajustement de facturation, et vous aide à rassembler les preuves demandées par AWS.
Votre checklist LLMjacking
Dans AWS
- Aucune clé utilisateur IAM de longue durée pour les personnes ou les workloads. Anciennes clés auditées et supprimées.
- Root : MFA matériel, aucune clé d'accès et une adresse e-mail surveillée sur un domaine que vous possédez.
- Contacts alternatifs SECURITY et OPERATIONS configurés sur chaque compte.
- Des SCP qui refusent Bedrock là où il n'est pas nécessaire, restreignent les abonnements Marketplace et bloquent
GetFederationToken. - Quotas de tokens par minute Bedrock dimensionnés au besoin réel.
- CloudTrail d'organisation, journalisation des invocations Bedrock et GuardDuty dans chaque compte et chaque région.
Dans DoiT Cloud Intelligence
- Une allocation couvrant Bedrock et les dépenses Marketplace "(Amazon Bedrock Edition)".
- Des alertes à seuil quotidiennes par compte sur cette allocation, y compris les comptes "doit rester à zéro".
- Un budget sur chaque compte AWS, comptes dormants compris.
- Notifications d'anomalies réglées sur Warning ou supérieur, avec renotification et un vrai destinataire.
- Détection d'anomalies en temps réel sur AWS (plans Enhanced et Enterprise).
- Recettes Composer pour les clés obsolètes et admin, la posture root, les contacts de sécurité, la couverture des trails et l'usage de clés Bedrock hors de vos comptes IA.
- CloudFlow : confinement avec approbation et détection de première utilisation d'un service.
Les attaquants gagnent de l'argent avec le LLMjacking : ils continueront donc de chercher les comptes que personne ne surveille. Une détection parfaite n'est pas réaliste. Vous pouvez néanmoins faire de votre compte une cible coûteuse, bruyante et éphémère. Et si quelque chose passe malgré tout, vous pouvez l'apprendre en quelques heures plutôt que sur la facture.
Besoin d'aide pour passer en revue vos garde-fous AWS ou configurer les alertes, budgets et CloudFlow de DCI pour vos workloads d'IA ? Parlez à DoiT.


