
Cloud Intelligence™
LLMjacking: quando gli aggressori eseguono LLM a carico della sua fattura AWS
Cosa abbiamo imparato dalle compromissioni di Bedrock del 2026, i controlli AWS che le bloccano e come configurare DoiT Cloud Intelligence come campanello d'allarme
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.
Informazioni sull'autore: Richard Kang è l'APJ Field Engineer Lead, con sede a Singapore. Informazioni sui dati: le cifre degli incidenti citate in questo articolo provengono da casi di LLMjacking su AWS gestiti dal team di supporto di DoiT tra giugno e ottobre 2026. I dettagli dei clienti sono anonimizzati e gli importi in dollari sono quelli riportati in ciascun caso.
Un account sandbox che normalmente costa 120 $ al giorno fattura 85.000 $ in quattordici ore. Un account membro dormiente, fermo da undici mesi, accumula 75.000 $ prima che qualcuno apra la fattura. L'account di un retailer europeo passa da poche centinaia di dollari al mese a 522.000 $ in meno di due giorni.
Nessuno di questi aggressori ha rubato dati o distribuito ransomware. Hanno sottratto credenziali cloud e le hanno usate per invocare i modelli linguistici di grandi dimensioni più costosi su Amazon Bedrock, lasciando il conto alla vittima. Questo è l'LLMjacking. Nel 2026 è diventato uno degli incidenti di sicurezza più comuni, e più costosi, che arrivano al team di supporto di DoiT.
Questo articolo spiega come funziona l'attacco e cosa abbiamo osservato negli incidenti di quest'anno. Illustra poi i controlli AWS che lo prevengono. Infine, mostra come configurare DoiT Cloud Intelligence™ (DCI) per scoprire l'attacco da un avviso anziché dalla fattura.
Che cos'è l'LLMjacking
Il Sysdig Threat Research Team ha coniato il termine nel maggio 2024, dopo aver osservato aggressori sfruttare un'applicazione Laravel vulnerabile, estrarre credenziali AWS e sondare Amazon Bedrock insieme ad altri nove servizi di AI in hosting (Sysdig, 2024). In termini operativi è un cryptojacking con una merce diversa: l'aggressore rivende la capacità LLM a pagamento di qualcun altro invece di minare criptovalute.
Da allora il mercato è maturato. Sysdig ha poi documentato servizi di reverse proxy che aggregano account rubati e vendono accesso "illimitato" ai modelli (Sysdig, 2026). Ha anche osservato aggressori usare la capacità dei modelli rubata per alimentare strumenti offensivi automatizzati (Sysdig, giugno 2026). I team di threat intelligence di Google segnalano lo stesso schema su Google Cloud (Google Cloud Threat Horizons).
Cosa abbiamo visto nel 2026
Nei casi di LLMjacking su AWS che DoiT ha aiutato i clienti a gestire quest'anno:
- Gli addebiti non autorizzati segnalati hanno raggiunto complessivamente circa 1,4 milioni di dollari. L'incidente mediano è stato di circa 72.000 $ e il più grande di 522.000 $.
- Erano frequenti picchi da 80.000 a 113.000 $ al giorno. Gli aggressori si distribuiscono su tutte le region abilitate e scelgono i modelli più costosi. Le varianti di Claude Opus hanno rappresentato la maggior parte della spesa in quasi tutti i casi.
- La maggior parte degli incidenti è iniziata con una chiave di accesso di un utente IAM di lunga durata. In genere si trattava di chiavi vecchie di anni, con privilegi eccessivi e condivise tra pipeline CI, file di configurazione o file di credenziali di agenti. Due casi sono iniziati con la compromissione dell'account root. In uno, l'email root era su un dominio scaduto che l'aggressore ha registrato di nuovo, per poi reimpostare la password e configurare la propria MFA.
- Solo due degli incidenti sono stati individuati per primi dal monitoraggio del cliente o da un avviso DoiT. Tutti gli altri l'hanno scoperto in altro modo: la fattura, una notifica di sicurezza di AWS o una restrizione dell'account. Alcuni hanno ricevuto un'inattesa email "grazie per l'abbonamento" da AWS Marketplace.
Anatomia di un attacco
I dettagli variano da caso a caso, ma la maggior parte degli attacchi segue gli stessi passaggi.
1. Procurarsi una credenziale. Dominano le chiavi di accesso IAM trafugate. In diversi casi le prove indicavano scanner automatici di segreti. La stessa chiave è stata usata da più strumenti da diversi Paesi, incluse chiamate di convalida da TruffleHog. Altri punti d'ingresso: un'app interna esposta per errore su internet, una trust policy di un ruolo che consentiva account esterni e le credenziali root.
2. Ricognizione silenziosa, a volte per settimane. Gli aggressori chiamano GetCallerIdentity, enumerano IAM e le quote di servizio ed elencano i foundation model disponibili in ogni region. In un caso la ricognizione è iniziata 17 giorni prima del picco di spesa. Alcuni aggressori controllano GetModelInvocationLoggingConfiguration per capire se i prompt vengono registrati (AWS API reference). Uno ha aperto la console AWS, verificato chi riceveva le notifiche di AWS Budgets dell'account e modificato un budget prima di mettersi al lavoro.
3. Ottenere una sessione console e la persistenza. sts:GetFederationToken trasforma una chiave di accesso in una sessione console senza MFA. Gli aggressori creano nuove chiavi di accesso su utenti esistenti, aggiungono utenti a gruppi admin o creano utenti IAM backdoor.
4. Abilitare i modelli. AWS ha ritirato il passaggio esplicito di accesso ai modelli nell'ottobre 2025 e i modelli serverless sono ora disponibili per impostazione predefinita, nei limiti di IAM (AWS). I modelli di terze parti come Claude vengono fatturati tramite AWS Marketplace. In pratica, qualsiasi principal autorizzato a invocare un modello può abbonare l'account a quel modello. Abbiamo visto otto accordi Marketplace accettati nel giro di dodici secondi.
5. Monetizzare a pieno regime. Le richieste partono verso tutte le region abilitate e attraverso i profili di inferenza cross-region per aggirare le quote per region. AWS ne limita la maggior parte (2,3 milioni su 2,58 milioni di chiamate in un caso), e il resto lo paga lei. Un traffico intenso di prompt cache è una firma comune di un proxy di rivendita che serve molti utenti finali.
6. Gestire attività collaterali. Gli aggressori hanno usato lo stesso accesso per inviare decine di migliaia di email di spam tramite Amazon SES. Altri hanno acquistato un GPU Capacity Block con data futura o avviato notebook SageMaker e flotte EC2. In un caso lo spam via SES è iniziato due giorni prima della fattura Bedrock, e nessuno monitorava il volume di invio.
Perché la fattura è di solito il primo campanello d'allarme
L'LLMjacking è difficile da intercettare con il monitoraggio dei costi standard per tre ragioni strutturali:
- La spesa non appare come "Amazon Bedrock". AWS Marketplace fattura ogni modello di terze parti su Bedrock come prodotto separato, ad esempio "Claude Opus 5 (Amazon Bedrock Edition)". Un budget o una dashboard filtrati sul servizio Amazon Bedrock possono non mostrare assolutamente nulla.
- Ogni nuovo modello è un servizio nuovo di zecca senza storico. Il rilevamento delle anomalie basato su machine learning impara cos'è normale dalla cronologia di spesa. Vale per AWS Cost Anomaly Detection e per DCI. Il rilevamento anomalie di DCI basato sulla fatturazione richiede una baseline di 14 giorni prima di classificare qualcosa come anomalo (DoiT Help Center). Un modello mai usato dall'account non ha baseline, e gli aggressori distribuiscono la spesa su molti modelli.
- I dati di fatturazione arrivano in ritardo. I dati di costo AWS impiegano da 24 a 72 ore per raggiungere qualsiasi strumento a valle, DCI compreso (DoiT Help Center). A 100.000 $ al giorno, quel ritardo costa caro.
Il rilevamento delle anomalie resta importante. In alcuni casi ha segnalato l'attacco, e intercetta gli abusi di EC2 e GPU che spesso lo accompagnano. Ma non può essere l'unico allarme antifrode. Servono controlli di prevenzione in AWS e allarmi a soglia che non richiedono una baseline.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Parte 1: i controlli AWS che prevengono l'LLMjacking
Eliminare le credenziali che vale la pena rubare
- Smettere di emettere chiavi utente IAM di lunga durata. Usare IAM Identity Center per le persone. Assegnare ai workloads ruoli IAM con credenziali temporanee: OIDC per GitHub Actions, IRSA o EKS Pod Identity e instance profile. Le best practice IAM di AWS sono esplicite al riguardo.
- Verificare le chiavi già esistenti. Eliminare le chiavi inutilizzate da 90 giorni; non limitarsi a disattivarle. Dopo un incidente AWS ne chiederà comunque l'eliminazione. Non inserire mai chiavi condivise in variabili CI, valori Helm o file di credenziali di agenti/MCP.
- Trattare le chiavi API di Bedrock come segreti. Preferire le chiavi a breve termine, che durano fino a 12 ore, e inventariare e limitare l'ambito di quelle a lungo termine (AWS).
- Attivare il secret scanning e la push protection nel source control (GitHub). Se AWS applica la policy
AWSCompromisedKeyQuarantineV3a uno degli utenti, avviare la risposta all'incidente. La policy limita ciò che la chiave può fare, ma non rimuove l'aggressore (AWS).
Proteggere il root
Usare MFA hardware, nessuna chiave di accesso root e un indirizzo email root su un dominio sotto il proprio controllo e monitorato attivamente. Impostare i contatti alternativi SECURITY e OPERATIONS su ogni account, compresi quelli dormienti, così che gli avvisi di AWS raggiungano qualcuno che li legge davvero.
Mettere guardrail a livello di Organization
Il privilegio minimo in IAM dovrebbe limitare ogni workload ai modelli e alle region specifici di cui ha bisogno (esempi di policy AWS). Le service control policy aggiungono poi una rete di sicurezza che un principal compromesso non può rimuovere. Ecco un punto di partenza, da testare prima in una OU non di produzione:
{ "Version": "2012-10-17", "Statement": [ { "Sid": "DenyMarketplaceSubscribeExceptPlatformRole", "Effect": "Deny", "Action": "aws-marketplace:Subscribe", "Resource": "*", "Condition": { "ArnNotLike": { "aws:PrincipalArn": "arn:aws:iam::*:role/ai-platform-admin" } } }, { "Sid": "DenyBedrockOutsideApprovedRegions", "Effect": "Deny", "Action": "bedrock:*", "Resource": "*", "Condition": { "StringNotEquals": { "aws:RequestedRegion": ["us-east-1", "us-west-2"] } } }, { "Sid": "DenyFederationTokenConsoleBypass", "Effect": "Deny", "Action": "sts:GetFederationToken", "Resource": "*" } ]}Qualche avvertenza. I profili di inferenza cross-region instradano le richieste verso altre region, quindi occorre validare la condizione sulla region rispetto ai profili effettivamente utilizzati (AWS). Alcuni account non dovrebbero mai usare l'AI generativa: sandbox, account dormienti e la maggior parte degli account di produzione al di fuori della piattaforma AI. Per questi, un semplice deny su bedrock:* è più semplice e più sicuro.
Limitare la velocità con cui il denaro può uscire
- Abbassare le quote di token al minuto di Bedrock al necessario per ciascun workload e richiedere un'approvazione per gli aumenti (AWS). Una quota limita il ritmo, non il totale, ma fa guadagnare tempo.
- Mantenere la sperimentazione in account circoscritti con budget propri.
Registrare e rilevare
- Un trail CloudTrail a livello di organizzazione multi-region consegnato a un account di archiviazione log blindato.
- Il logging delle invocazioni dei modelli Bedrock per i workloads approvati (AWS).
- Amazon GuardDuty in ogni account e in ogni region, con le protezioni legate all'AI abilitate. Dopo un incidente, AWS ha verificato la presenza di servizi di sicurezza nell'account membro interessato, non solo in quello di gestione.
- Avvisi sui segnali comparsi presto negli incidenti reali:
- nuovi accordi Marketplace
- chiamate
GetFederationToken CreateAccessKeychiamata da un ruolo assunto- accessi root o modifiche alla MFA
- aumenti improvvisi del volume di invio SES
Parte 2: configurare DoiT Cloud Intelligence come campanello d'allarme
DCI non sostituirà GuardDuty o CloudTrail. Il suo valore, in questo scenario, sta nell'essere un control plane dei costi esterno agli account AWS. Un aggressore in possesso delle chiavi AWS può leggere e modificare AWS Budgets, e ne abbiamo visto uno fare esattamente questo. Non può però toccare gli avvisi e i budget configurati in DCI.
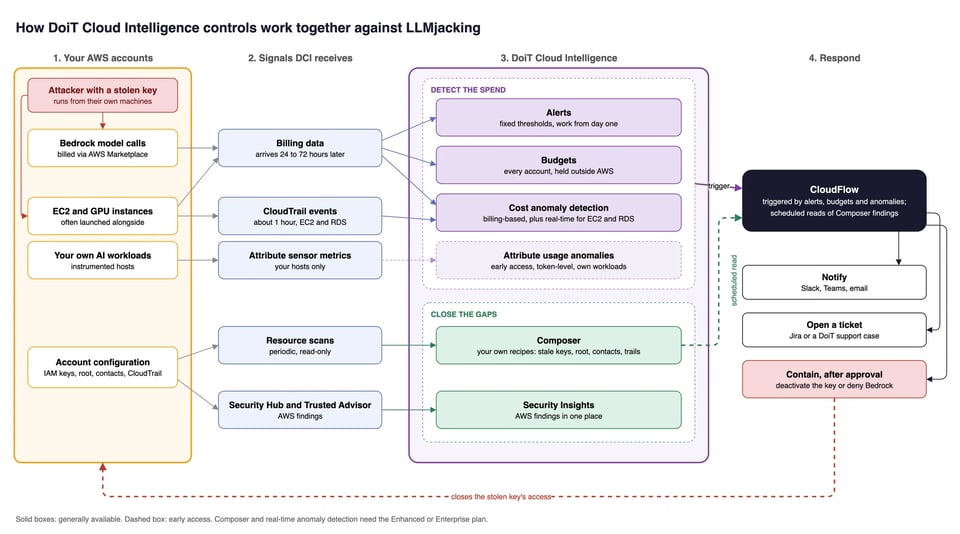
Avvisi, budget e rilevamento delle anomalie sorvegliano la spesa. Composer e Security Insights chiudono le falle usate dagli aggressori per entrare. CloudFlow trasforma ciascuno di questi elementi in una notifica, un ticket o un'azione di contenimento approvata.
1. Avvisi a soglia che non richiedono una baseline
Gli avvisi scattano su una regola fissa, quindi funzionano dal primo giorno, anche su un modello mai usato prima. È il controllo DCI più affidabile contro l'LLMjacking.
- Creare un'allocation che raggruppi tutta la spesa per modelli AI: Amazon Bedrock e i prodotti Marketplace "(Amazon Bedrock Edition)". I nuovi modelli vi confluiranno automaticamente e gli avvisi non ignoreranno in silenzio il modello che verrà lanciato il mese prossimo.
- Avviso di spesa giornaliera per account: circoscritto a quell'allocation, con Metric impostata su Cost e Interval su Daily. Impostare la condizione su
is > $X, dove X è due o tre volte una giornata normale. Attivare Evaluate for each: Account, così una sola regola copre ogni account. - Avviso "dovrebbe essere zero": per sandbox, account dormienti e tutto ciò che non esegue workloads di AI, impostare l'avviso a
> $10al giorno. - Impennata da un giorno all'altro:
percentage change is > 100%. - Avviso di forecast: mensile,
is forecasted to be >la spesa AI pianificata.
Instradare gli avvisi via email e su un canale Slack che qualcuno guarda davvero (consegna degli avvisi su Slack).
2. Budget su ogni account, soprattutto quelli silenziosi
Impostare un budget mensile ricorrente su ogni account AWS, con soglie al 50%, 85% e 100%. I suggerimenti di budget possono dimensionarli automaticamente. Aggiungere un budget giornaliero sull'allocation AI come secondo campanello d'allarme di facile lettura. Gli account dormienti e sandbox sono i bersagli preferiti degli aggressori proprio perché nessuno vi assegna un budget. Un account da 0 $ con un budget di 50 $ è un ottimo allarme.
I budget non fermeranno la spesa, ma la segnaleranno dall'esterno dell'account compromesso.
3. Tarare il rilevamento delle anomalie perché le notifiche la raggiungano davvero
Il rilevamento delle anomalie di costo resta comunque prezioso, soprattutto per il versante EC2, GPU e SageMaker di un attacco. Tre impostazioni fanno la differenza:
- Ampliare il filtro di gravità. Le notifiche email sono impostate di default solo su Critical. Impostarle su "Warning and above" o "All severity levels" (impostazioni di notifica).
- Attivare la rinotifica, così un'anomalia attiva che continua a crescere torna a farsi sentire.
- Verificare che sia configurato un destinatario. In più di un incidente, DCI ha rilevato l'anomalia ma nessuno ne ha avuto notizia: non era impostato alcun destinatario delle notifiche.
Sui piani Enhanced ed Enterprise, abilitare il rilevamento anomalie in tempo reale per AWS. Si basa su CloudTrail e segnala entro circa un'ora. Oggi copre EC2 e RDS, non Bedrock. Intercetta comunque la metà dell'attacco fatta di GPU e istanze, che spesso corre in parallelo all'abuso dei modelli. È anche possibile abilitare il rilevamento anomalie sull'allocation AI stessa (monitoraggio delle allocation).
Se i workloads di AI sono strumentati con Attribute, DoiT offre anche anomalie di utilizzo a livello di token in early access. Possono segnalare un workload fuori controllo più velocemente dei dati di fatturazione. Vedono però solo il traffico proveniente dagli host strumentati, quindi non intercetteranno una chiave rubata usata dalla macchina di un aggressore.
4. Automatizzare la prima risposta con CloudFlow
CloudFlow può attivarsi su avvisi DCI, soglie di budget e anomalie di costo, trasformando una notifica in un'azione:
- Avviso → Slack → approvazione → contenimento. Quando scatta l'avviso Bedrock, pubblicare account e importo nel canale degli incidenti. Poi, dopo l'approvazione di una persona, eseguire un'azione AWS: disattivare la chiave di accesso sospetta o applicare un deny esplicito su
bedrock:InvokeModel*ebedrock:Converse*. I passaggi di approvazione evitano che un falso positivo metta fuori uso la produzione. - Rilevamento del primo utilizzo di un servizio. Un template di flow pianificato segnala la prima spesa su qualsiasi servizio o SKU AWS. Copre la lacuna dei nuovi modelli descritta sopra.
- Revocare le chiavi API dei provider AI. Un template attivato via webhook, con approvazione integrata, elimina le credenziali Bedrock a lungo termine (e le chiavi OpenAI, Anthropic o Gemini). Può essere richiamato da EventBridge, dal SIEM o da un finding di GuardDuty (tutorial).
Qualsiasi azione di contenimento richiede che il ruolo CloudFlow nell'account di destinazione abbia le autorizzazioni IAM corrispondenti. Queste autorizzazioni vanno definite prima di un incidente.
5. Chiudere le falle prima che un aggressore le trovi
Security Insights importa i finding di AWS Security Hub e Trusted Advisor: chiavi di accesso non ruotate, account root senza MFA e account senza GuardDuty o CloudTrail. Quasi tutti gli incidenti descritti sopra sono iniziati da uno di questi problemi.
Questi finding usano le regole generiche di AWS. Composer permette di scriverne di proprie, sui piani Enhanced ed Enterprise. È il motore di policy di DCI: scansiona le risorse di ogni account connesso e le confronta con le recipe, regole che si costruiscono senza codice. È possibile duplicare una recipe di DoiT e modificarla, oppure descrivere il controllo all'assistente AI. Le corrispondenze compaiono come Security insights.
Ecco come le falle alla base degli incidenti di quest'anno si traducono in recipe realizzabili già oggi:
| Falla osservata negli incidenti | Recipe da creare | Dati letti da Composer |
|---|---|---|
| Chiavi vecchie di anni di cui nessuno si ricordava | Chiavi di accesso non usate da 90 giorni, o mai usate | Data di ultimo utilizzo della chiave di accesso |
| Utenti admin con chiavi di lunga durata | Utenti con policy admin e almeno una chiave attiva | Policy utente e chiavi di accesso |
| Takeover dell'account root | Root senza MFA, o con una chiave di accesso | Report delle credenziali IAM |
| Avvisi AWS che non arrivavano a nessuno | Account senza contatto alternativo di sicurezza | Contatti dell'account |
| Lacune nell'audit trail | Trail non multi-region, non a livello di organizzazione o senza logging attivo | Stato dei trail CloudTrail |
| Chiavi che chiamano Bedrock dal posto sbagliato | Chiavi il cui ultimo utilizzo è stato per Bedrock in account al di fuori dell'allowlist AI | Servizio e region di ultimo utilizzo della chiave di accesso |
L'ultima riga è il punto in cui Composer si avvicina di più al rilevamento di un abuso. Una chiave in un account sandbox il cui ultimo utilizzo è stato per Bedrock merita un'occhiata, anche se la spesa non si è ancora mossa.
Per agire sui finding, pianificare un CloudFlow che legga i Security finding aperti tramite il nodo Composer Insights. Pubblicarli su Slack o aprire un ticket ogni mattina. Per le chiavi obsolete, aggiungere un passaggio di approvazione che disattivi la chiave una volta che il proprietario conferma che è inutilizzata.
Composer esegue scansioni periodiche, quindi è un controllo di igiene, non un allarme anti-attacco. Non verifica lo stato di GuardDuty o Security Hub, il logging delle invocazioni Bedrock, le chiavi API Bedrock o il contenuto delle SCP. Per quelli ci sono Security Insights e AWS Config. Usare Composer per chiudere le porte da cui gli aggressori sono entrati quest'anno, e mantenere gli avvisi a soglia descritti sopra per la spesa vera e propria.
Se succede comunque
Avviare il contenimento non appena si sospetta una compromissione. Non aspettare un avviso di anomalia o le cifre definitive di fatturazione.
- Prima di tutto, contenere. Disattivare, e poi eliminare, le chiavi di accesso compromesse. Revocare le sessioni di ruolo attive con una policy di deny condizionata su
aws:TokenIssueTimee disabilitare le eventuali chiavi API Bedrock sospette. Se serve uno strumento drastico, una SCP di emergenza che negabedrock:*sull'account interessato ferma l'emorragia (ferma anche l'uso legittimo di Bedrock). Aspettarsi che le chiamate continuino ad arrivare per qualche minuto dopo la disattivazione di una chiave. - Cercare la persistenza. Controllare nuovi utenti IAM, chiavi di accesso, ruoli e modifiche alle trust policy, accordi Marketplace, identità SES, Capacity Block e istanze in ogni region. Ruotare ogni chiave potenzialmente esposta, non solo quella segnalata da AWS. Abbiamo visto una seconda ondata arrivare sei giorni dopo l'apertura di un incidente, attraverso una chiave che nessuno aveva ruotato.
- Preservare le prove. Esportare CloudTrail (la Event History conserva solo 90 giorni), i log di invocazione, un inventario delle risorse e un'esportazione dei costi per servizio.
- Rispondere ad AWS prima della scadenza. Le notifiche di sicurezza di AWS in genere concedono cinque giorni prima della sospensione dei servizi. Le restrizioni possono arrivare giorni dopo l'incidente e colpire servizi di produzione come Lambda, ECS ed EC2.
- Chiedere esplicitamente la rettifica della fattura. Nei casi che abbiamo visto, AWS si aspetta almeno due controlli di monitoraggio dei costi, come AWS Budgets e Cost Anomaly Detection. Si aspetta anche MFA sul root, GuardDuty o Security Hub. Queste verifiche vengono fatte nell'account interessato. Gli accordi Marketplace creati dall'aggressore vanno annullati. Gli esiti sono andati da crediti totali a crediti parziali fino a dinieghi. Il processo ha richiesto da due a dodici settimane. Una cronologia chiara, un contenimento rapido e prove complete fanno la differenza. AWS ha anche dichiarato che potrebbe non esaminare fatture future se i controlli non sono in atto.
Se il suo account AWS è rivenduto da DoiT, aprire un ticket di supporto DoiT non appena si sospetta una compromissione. Il nostro team si coordina con AWS sul caso di sicurezza e sulla richiesta di rettifica della fattura, e aiuta a raccogliere le prove richieste da AWS.
La checklist anti-LLMjacking
In AWS
- Nessuna chiave utente IAM di lunga durata per persone o workloads. Chiavi vecchie verificate ed eliminate.
- Root: MFA hardware, nessuna chiave di accesso e un indirizzo email monitorato su un dominio di proprietà.
- Contatti alternativi SECURITY e OPERATIONS impostati su ogni account.
- SCP che negano Bedrock dove non serve, limitano le sottoscrizioni Marketplace e bloccano
GetFederationToken. - Quote di token al minuto di Bedrock dimensionate sul fabbisogno.
- CloudTrail a livello di organizzazione, logging delle invocazioni Bedrock e GuardDuty in ogni account e region.
In DoiT Cloud Intelligence
- Un'allocation che copre Bedrock più la spesa Marketplace "(Amazon Bedrock Edition)".
- Avvisi a soglia giornalieri per account su quell'allocation, inclusi gli account "dovrebbe essere zero".
- Un budget su ogni account AWS, dormienti inclusi.
- Notifiche di anomalia impostate su Warning o superiore, con rinotifica e un destinatario reale.
- Rilevamento anomalie in tempo reale su AWS (piani Enhanced ed Enterprise).
- Recipe di Composer per chiavi obsolete e di admin, postura del root, contatti di sicurezza, copertura dei trail e uso di chiavi Bedrock fuori dagli account AI.
- CloudFlow: contenimento da avviso ad approvazione e rilevamento del primo utilizzo di un servizio.
Gli aggressori guadagnano con l'LLMjacking, quindi continueranno a cercare account che nessuno sorveglia. Un rilevamento perfetto non è realistico. Si può però rendere il proprio account un bersaglio costoso, rumoroso e di breve durata. E se qualcosa passa comunque, lo si può scoprire nel giro di ore anziché dalla fattura.
Desidera un supporto per rivedere i guardrail AWS o configurare avvisi DCI, budget e CloudFlow per i workloads di AI? Parli con DoiT.


