
Cloud Intelligence™
LLMjacking: cuando los atacantes ejecutan LLMs con cargo a tu factura de AWS
Lo que aprendimos de los incidentes de Bedrock en 2026, los controles de AWS que los frenan y cómo configurar DoiT Cloud Intelligence como tu alarma temprana
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.
Sobre el autor: Richard Kang es el APJ Field Engineer Lead, con base en Singapur. Sobre los datos: las cifras de incidentes de este artículo provienen de casos de LLMjacking en AWS que el equipo de soporte de DoiT atendió entre junio y octubre de 2026. Los detalles de los clientes están anonimizados y los montos en dólares son los reportados en cada caso.
Una cuenta sandbox que normalmente cuesta $120 al día factura $85,000 en catorce horas. Una cuenta miembro inactiva, sin tocar durante once meses, acumula $75,000 antes de que alguien abra la factura. La cuenta de un retailer europeo pasa de unos cientos de dólares al mes a $522,000 en menos de dos días.
Ninguno de estos atacantes robó datos ni desplegó ransomware. Tomaron credenciales de la nube y las usaron para invocar los modelos de lenguaje más caros de Amazon Bedrock, y luego le dejaron la factura a la víctima. Esto es LLMjacking. En 2026 se ha convertido en uno de los incidentes de seguridad más comunes, y más costosos, que llegan al equipo de soporte de DoiT.
Este artículo explica cómo funciona el ataque y lo que hemos visto en los incidentes de este año. Después repasa los controles de AWS que lo previenen. Por último, muestra cómo configurar DoiT Cloud Intelligence™ (DCI) para que te enteres por una alerta y no por tu factura.
Qué es el LLMjacking
El equipo de Sysdig Threat Research acuñó el término en mayo de 2024. Observaron a atacantes explotar una aplicación Laravel vulnerable, extraer credenciales de AWS y sondear Amazon Bedrock junto con otros nueve servicios de IA alojada (Sysdig, 2024). En términos operativos es cryptojacking con otra mercancía: el atacante revende la capacidad de LLM que otro paga, en lugar de minar criptomonedas.
El mercado ha madurado desde entonces. Sysdig ha documentado servicios de proxy inverso que agrupan cuentas robadas y venden acceso "ilimitado" a modelos (Sysdig, 2026). También ha visto a atacantes usar capacidad de modelos robada para alimentar herramientas ofensivas automatizadas (Sysdig, junio de 2026). Los equipos de inteligencia de amenazas de Google reportan el mismo patrón en Google Cloud (Google Cloud Threat Horizons).
Lo que hemos visto en 2026
En los casos de LLMjacking en AWS que DoiT ayudó a resolver a sus clientes este año:
- Los cargos no autorizados reportados sumaron aproximadamente $1.4 millones. La mediana por incidente fue de unos $72,000 y el mayor llegó a $522,000.
- Fueron comunes los picos de $80,000 a $113,000 al día. Los atacantes se despliegan por todas las regiones habilitadas y eligen los modelos más caros. Las variantes de Claude Opus concentraron la mayor parte del gasto en casi todos los casos.
- La mayoría de los incidentes comenzó con una clave de acceso de usuario IAM de larga duración. Solían tener años de antigüedad, privilegios excesivos y estar compartidas entre pipelines de CI, archivos de configuración o archivos de credenciales de agentes. Dos casos comenzaron con la toma de control de la cuenta root. En uno, el correo del root estaba en un dominio vencido que el atacante volvió a registrar, restableció la contraseña y registró su propio MFA.
- Solo dos de los incidentes fueron detectados primero por el monitoreo del propio cliente o por una alerta de DoiT. El resto se enteró de otra forma: la factura, un aviso de seguridad de AWS o una restricción de la cuenta. Algunos recibieron un inesperado correo de AWS Marketplace de "gracias por suscribirte".
Anatomía de un ataque
Los detalles varían de un caso a otro, pero la mayoría de los ataques sigue los mismos pasos.
1. Conseguir una credencial. Dominan las claves de acceso IAM filtradas. En varios casos la evidencia apuntaba a escáneres automatizados de secretos. La misma clave fue usada por varias herramientas desde distintos países, incluidas llamadas de validación de TruffleHog. Otros puntos de entrada fueron una app interna expuesta a internet por accidente, una política de confianza de rol que permitía cuentas externas y credenciales root.
2. Reconocimiento silencioso, a veces durante semanas. Los atacantes llaman a GetCallerIdentity, enumeran IAM y las cuotas de servicio, y listan los modelos fundacionales disponibles en cada región. En un caso, el reconocimiento comenzó 17 días antes del pico de gasto. Algunos atacantes revisan GetModelInvocationLoggingConfiguration para saber si registras los prompts (referencia de la API de AWS). Uno abrió la consola de AWS, verificó quién recibía las notificaciones de AWS Budgets de la cuenta y editó un presupuesto antes de ponerse a trabajar.
3. Obtener una sesión de consola y persistencia. sts:GetFederationToken convierte una clave de acceso en una sesión de consola sin MFA. Los atacantes crean nuevas claves de acceso en usuarios existentes, agregan usuarios a grupos de administradores o crean usuarios IAM como puerta trasera.
4. Habilitar los modelos. AWS retiró el paso explícito de acceso a modelos en octubre de 2025, y los modelos serverless ahora están disponibles por defecto, sujetos a IAM (AWS). Los modelos de terceros como Claude se facturan a través de AWS Marketplace. En la práctica, cualquier principal con permiso para invocar un modelo puede suscribir tu cuenta a él. Vimos ocho acuerdos de Marketplace aceptados en doce segundos.
5. Monetizar a toda máquina. Las solicitudes van a todas las regiones habilitadas y a través de perfiles de inferencia entre regiones para evadir las cuotas por región. AWS limita la mayoría (2.3 millones de 2.58 millones de llamadas en un caso), y tú pagas el resto. Un tráfico intenso de caché de prompts es una señal típica de un proxy de reventa que atiende a muchos usuarios finales.
6. Montar negocios paralelos. Los atacantes usaron el mismo acceso para enviar decenas de miles de correos de spam a través de Amazon SES. Otros compraron un GPU Capacity Block con fecha futura o lanzaron notebooks de SageMaker y flotas de EC2. En un caso, el spam de SES comenzó dos días antes que la factura de Bedrock, y nadie vigilaba el volumen de envío.
Por qué la factura suele ser la primera alarma
El LLMjacking es difícil de detectar con el monitoreo de costos estándar por tres razones estructurales:
- El gasto no aparece como "Amazon Bedrock". AWS Marketplace factura cada modelo de terceros en Bedrock como un producto aparte, como "Claude Opus 5 (Amazon Bedrock Edition)". Un presupuesto o dashboard filtrado por el servicio Amazon Bedrock puede no mostrar nada en absoluto.
- Cada modelo nuevo es un servicio totalmente nuevo sin historial. La detección de anomalías con machine learning aprende qué es lo normal a partir de tu historial de gasto. Eso aplica a AWS Cost Anomaly Detection y a DCI. La detección de anomalías de DCI basada en facturación necesita una línea base de 14 días antes de clasificar algo como anómalo (Centro de ayuda de DoiT). Un modelo que tu cuenta nunca ha usado no tiene línea base, y los atacantes reparten el gasto entre muchos modelos.
- Los datos de facturación llegan con retraso. Los datos de costos de AWS tardan de 24 a 72 horas en llegar a cualquier herramienta posterior, DCI incluida (Centro de ayuda de DoiT). A razón de $100,000 al día, ese retraso sale caro.
La detección de anomalías sigue siendo importante. Señaló el ataque en algunos casos y detecta el abuso de EC2 y GPU que suele acompañarlo. Pero no puede ser tu única alarma antifraude. Necesitas controles de prevención en AWS y alarmas basadas en umbrales que no necesiten una línea base.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Parte 1: controles de AWS que previenen el LLMjacking
Elimina las credenciales que vale la pena robar
- Deja de emitir claves de usuario IAM de larga duración. Usa IAM Identity Center para las personas. Asigna a los workloads roles de IAM con credenciales temporales: OIDC para GitHub Actions, IRSA o EKS Pod Identity, y perfiles de instancia. Las buenas prácticas de IAM de AWS son explícitas al respecto.
- Audita las claves que ya tienes. Elimina las claves sin uso durante 90 días; no te limites a desactivarlas. De todos modos, AWS pedirá su eliminación después de un incidente. Nunca pongas claves compartidas en variables de CI, valores de Helm o archivos de credenciales de agentes/MCP.
- Trata las claves de API de Bedrock como secretos. Prefiere las claves de corto plazo, que duran hasta 12 horas, e inventaria y acota cualquier clave de largo plazo (AWS).
- Activa el escaneo de secretos y la protección de push en tu control de código fuente (GitHub). Si AWS adjunta la política
AWSCompromisedKeyQuarantineV3a uno de tus usuarios, inicia la respuesta a incidentes. La política limita lo que la clave puede hacer, pero no elimina al atacante (AWS).
Protege el root
Usa MFA por hardware, nada de claves de acceso root y una dirección de correo root en un dominio que controles y monitorees activamente. Configura los contactos alternos de SECURITY y OPERATIONS en cada cuenta, incluidas las inactivas, para que las advertencias de AWS lleguen a alguien que las lea.
Pon guardrails a nivel de la Organización
El mínimo privilegio en IAM debería limitar cada workload a los modelos y regiones específicos que necesita (ejemplos de políticas de AWS). Las políticas de control de servicios (SCP) agregan luego un respaldo que un principal comprometido no puede eliminar. Aquí tienes un punto de partida, para probar primero en una OU que no sea de producción:
{ "Version": "2012-10-17", "Statement": [ { "Sid": "DenyMarketplaceSubscribeExceptPlatformRole", "Effect": "Deny", "Action": "aws-marketplace:Subscribe", "Resource": "*", "Condition": { "ArnNotLike": { "aws:PrincipalArn": "arn:aws:iam::*:role/ai-platform-admin" } } }, { "Sid": "DenyBedrockOutsideApprovedRegions", "Effect": "Deny", "Action": "bedrock:*", "Resource": "*", "Condition": { "StringNotEquals": { "aws:RequestedRegion": ["us-east-1", "us-west-2"] } } }, { "Sid": "DenyFederationTokenConsoleBypass", "Effect": "Deny", "Action": "sts:GetFederationToken", "Resource": "*" } ]}Algunas advertencias. Los perfiles de inferencia entre regiones enrutan solicitudes a otras regiones, así que valida la condición de región contra los perfiles que realmente usas (AWS). Algunas cuentas nunca deberían usar IA generativa: sandboxes, cuentas inactivas y la mayoría de las cuentas de producción fuera de tu plataforma de IA. Para esas, un deny simple sobre bedrock:* es más sencillo y seguro.
Limita la velocidad a la que puede salir el dinero
- Reduce las cuotas de tokens por minuto de Bedrock a lo que cada workload necesita, y exige aprobación para los aumentos (AWS). Una cuota limita la velocidad, no el total, pero te da tiempo.
- Mantén la experimentación en cuentas acotadas con sus propios presupuestos.
Registra y detecta
- Un trail de CloudTrail a nivel de organización, multirregión, entregado a una cuenta de archivo de logs bien restringida.
- Registro de invocación de modelos de Bedrock para los workloads aprobados (AWS).
- Amazon GuardDuty en cada cuenta y cada región, con las protecciones relacionadas con IA habilitadas. Tras un incidente, AWS verificó los servicios de seguridad en la cuenta miembro afectada, no solo en la cuenta de administración.
- Alertas sobre las señales que aparecieron temprano en incidentes reales:
- nuevos acuerdos de Marketplace
- llamadas a
GetFederationToken CreateAccessKeyinvocado por un rol asumido- inicios de sesión root o cambios de MFA
- saltos repentinos en el volumen de envío de SES
Parte 2: configura DoiT Cloud Intelligence como tu alarma temprana
DCI no va a reemplazar a GuardDuty ni a CloudTrail. Su valor aquí es que es un plano de control de costos fuera de tus cuentas de AWS. Un atacante con tus claves de AWS puede leer y editar AWS Budgets, y hemos visto a uno hacer exactamente eso. Lo que no puede tocar son las alertas y presupuestos que configuraste en DCI.
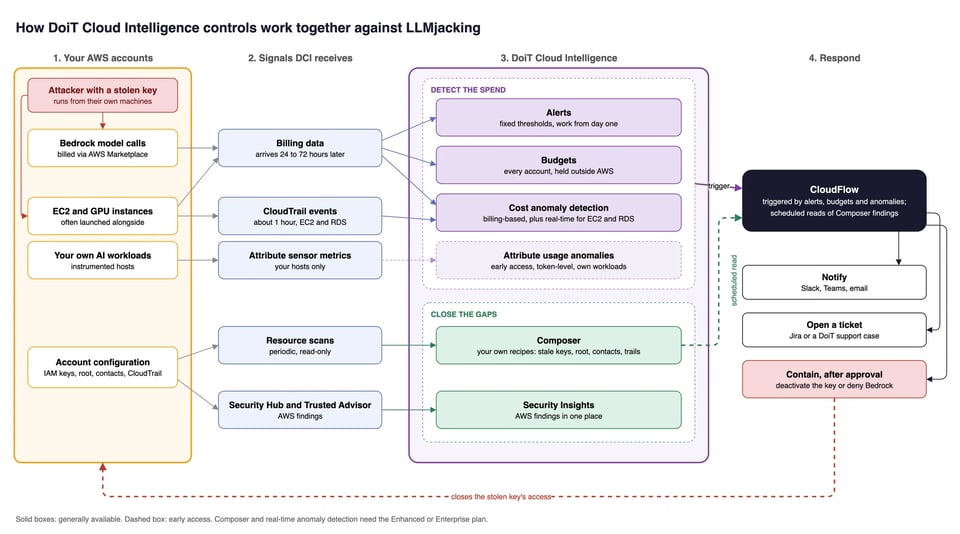
Las alertas, los presupuestos y la detección de anomalías vigilan el gasto. Composer y Security Insights cierran las brechas que los atacantes usan para entrar. CloudFlow convierte cualquiera de ellos en una notificación, un ticket o un paso de contención aprobado.
1. Alertas de umbral que no necesitan línea base
Las alertas se disparan con una regla fija, así que funcionan desde el primer día, incluso con un modelo que nunca has usado. Es el control de DCI más confiable contra el LLMjacking.
- Crea una allocation que agrupe todo el gasto en modelos de IA: Amazon Bedrock y los productos de Marketplace "(Amazon Bedrock Edition)". Los modelos nuevos se incorporan automáticamente, y tus alertas no pasarán por alto en silencio el modelo que se lance el próximo mes.
- Alerta de gasto diario por cuenta: acótala a esa allocation, con la métrica en Cost y el intervalo en Daily. Define la condición como
is > $X, donde X es dos o tres veces un día normal. Activa Evaluate for each: Account para que una sola regla cubra todas las cuentas. - Alerta de "debería ser cero": para sandboxes, cuentas inactivas y todo lo que no ejecute workloads de IA, alerta a partir de
> $10al día. - Salto de un día a otro:
percentage change is > 100%. - Alerta de pronóstico: mensual,
is forecasted to be >tu gasto de IA planificado.
Envía las alertas por correo y a un canal de Slack que alguien de verdad mire (entrega de alertas en Slack).
2. Presupuestos en todas las cuentas, sobre todo en las silenciosas
Pon un presupuesto mensual recurrente en cada cuenta de AWS, con umbrales en 50%, 85% y 100%. Las sugerencias de presupuesto pueden dimensionarlos por ti. Agrega un presupuesto diario sobre la allocation de IA como una segunda alarma fácil de leer. Las cuentas inactivas y los sandboxes son los objetivos favoritos de los atacantes precisamente porque nadie les asigna presupuesto. Una cuenta de $0 con un presupuesto de $50 es una muy buena alarma.
Los presupuestos no detendrán el gasto, pero te avisarán desde fuera de la cuenta comprometida.
3. Ajusta la detección de anomalías para que realmente te llegue
La detección de anomalías de costos sigue ganándose su lugar, sobre todo para el lado de EC2, GPU y SageMaker de un ataque. Tres configuraciones importan:
- Amplía el filtro de severidad. Las notificaciones por correo vienen por defecto solo en Critical. Configúralas en "Warning and above" o "All severity levels" (configuración de notificaciones).
- Activa la renotificación, para que una anomalía activa que sigue creciendo te vuelva a avisar.
- Asegúrate de que haya un destinatario configurado. En más de un incidente, DCI detectó la anomalía pero nadie se enteró. No había destinatario de notificaciones configurado.
En los planes Enhanced y Enterprise, habilita la detección de anomalías en tiempo real para AWS. Funciona a partir de CloudTrail y reporta en aproximadamente una hora. Hoy cubre EC2 y RDS, no Bedrock. Aun así, atrapa la mitad del ataque relacionada con GPU e instancias, que suele correr en paralelo al abuso de modelos. También puedes habilitar la detección de anomalías en la propia allocation de IA (monitoreo de allocations).
Si instrumentas tus workloads de IA con Attribute, DoiT también ofrece anomalías de uso a nivel de token en acceso anticipado. Pueden señalar un workload descontrolado más rápido que los datos de facturación. Solo ven el tráfico de tus propios hosts instrumentados, así que no detectarán una clave robada usada desde la máquina de un atacante.
4. Automatiza la primera respuesta con CloudFlow
CloudFlow puede dispararse con alertas de DCI, umbrales de presupuesto y anomalías de costos, lo que convierte una notificación en una acción:
- Alerta → Slack → aprobación → contención. Cuando se dispare la alerta de Bedrock, publica la cuenta y el monto en tu canal de incidentes. Luego, tras la aprobación de una persona, ejecuta una acción en AWS: desactiva la clave de acceso sospechosa o adjunta un deny explícito sobre
bedrock:InvokeModel*ybedrock:Converse*. Los pasos de aprobación evitan que un falso positivo tumbe producción. - Detección de servicios usados por primera vez. Una plantilla de flujo programado marca el primer gasto en cualquier servicio o SKU de AWS. Eso cubre la brecha de los modelos nuevos descrita antes.
- Revoca claves de API de proveedores de IA. Una plantilla activada por webhook, con aprobación incorporada, elimina credenciales de largo plazo de Bedrock (y claves de OpenAI, Anthropic o Gemini). Puedes invocarla desde EventBridge, tu SIEM o un hallazgo de GuardDuty (tutorial).
Cualquier acción de contención requiere que el rol de CloudFlow en la cuenta destino tenga los permisos de IAM correspondientes. Define esos permisos antes de que ocurra un incidente.
5. Cierra las brechas antes de que un atacante las encuentre
Security Insights incorpora los hallazgos de AWS Security Hub y Trusted Advisor. Incluyen claves de acceso que no se han rotado, cuentas root sin MFA y cuentas sin GuardDuty o CloudTrail. Casi todos los incidentes descritos arriba comenzaron con uno de estos problemas.
Esos hallazgos usan las reglas genéricas de AWS. Composer te permite escribir las tuyas, en los planes Enhanced y Enterprise. Es el motor de políticas de DCI. Escanea los recursos de cada cuenta conectada y los contrasta con recetas, que son reglas que construyes sin código. Puedes duplicar una receta de DoiT y editarla, o describirle la verificación al asistente de IA. Las coincidencias aparecen como Security insights.
Así es como las brechas detrás de los incidentes de este año se traducen en recetas que puedes construir hoy:
| Brecha que vimos en incidentes | Receta a construir | Datos que lee Composer |
|---|---|---|
| Claves con años de antigüedad que nadie recordaba | Claves de acceso sin uso en 90 días, o nunca usadas | Fecha de último uso de la clave de acceso |
| Usuarios admin con claves de larga duración | Usuarios con políticas de administrador y al menos una clave activa | Políticas de usuario y claves de acceso |
| Toma de control de la cuenta root | Root sin MFA, o con una clave de acceso | Informe de credenciales de IAM |
| Advertencias de AWS que no llegaban a nadie | Cuentas sin contacto alterno de seguridad | Contactos de la cuenta |
| Brechas en el registro de auditoría | Trails que no son multirregión ni a nivel de organización, o que no registran | Estado del trail de CloudTrail |
| Claves que llaman a Bedrock desde el lugar equivocado | Claves usadas por última vez para Bedrock en cuentas fuera de tu allowlist de IA | Servicio y región de último uso de la clave de acceso |
La última fila es lo más cerca que Composer llega a detectar abuso. Una clave en una cuenta sandbox cuyo último uso fue para Bedrock merece una revisión, aunque el gasto aún no se haya movido.
Para actuar sobre los hallazgos, programa un CloudFlow que lea los hallazgos de seguridad abiertos a través del nodo de Composer Insights. Publícalos en Slack o abre un ticket cada mañana. Para las claves obsoletas, agrega un paso de aprobación que desactive la clave cuando el responsable confirme que no se usa.
Composer ejecuta escaneos periódicos, así que es un control de higiene y no una alarma de ataque. No verifica el estado de GuardDuty ni de Security Hub, el registro de invocaciones de Bedrock, las claves de API de Bedrock ni el contenido de las SCP. Security Insights y AWS Config cubren eso. Usa Composer para cerrar las puertas por las que entraron los atacantes este año, y mantén las alertas de umbral de arriba para el gasto en sí.
Si de todos modos sucede
Comienza la contención en cuanto sospeches que una cuenta está comprometida. No esperes una alerta de anomalía ni las cifras finales de facturación.
- Contén primero. Desactiva, y luego elimina, las claves de acceso comprometidas. Revoca las sesiones de rol activas con una política de deny condicionada a
aws:TokenIssueTime, y deshabilita cualquier clave de API de Bedrock sospechosa. Si necesitas una medida drástica, una SCP de emergencia que denieguebedrock:*en la cuenta afectada detiene la hemorragia (también detiene el uso legítimo de Bedrock). Cuenta con que las llamadas seguirán llegando unos minutos después de deshabilitar una clave. - Busca persistencia. Revisa nuevos usuarios de IAM, claves de acceso, roles y cambios en políticas de confianza, acuerdos de Marketplace, identidades de SES, Capacity Blocks e instancias en todas las regiones. Rota todas las claves que pudieron estar expuestas, no solo la que AWS señaló. Hemos visto llegar una segunda ola seis días después de iniciado un incidente a través de una clave que nadie rotó.
- Preserva la evidencia. Exporta CloudTrail (el Event History solo guarda 90 días), los logs de invocación, un inventario de recursos y una exportación de costos por servicio.
- Responde a AWS antes del plazo. Los avisos de seguridad de AWS suelen dar cinco días antes de suspender servicios. Las restricciones pueden llegar días después del incidente y afectar servicios de producción como Lambda, ECS y EC2.
- Pide el ajuste de facturación de forma explícita. En los casos que hemos visto, AWS espera al menos dos controles de monitoreo de costos, como AWS Budgets y Cost Anomaly Detection. También espera MFA en root, GuardDuty o Security Hub. Lo verifican en la cuenta afectada. Los acuerdos de Marketplace creados por el atacante deben cancelarse. Los resultados han ido desde créditos totales hasta créditos parciales y denegaciones. El proceso ha tomado de dos a doce semanas. Una línea de tiempo clara, una contención rápida y evidencia completa marcan la diferencia. AWS también ha dicho que podría no revisar facturas futuras si los controles no están implementados.
Si DoiT revende tu cuenta de AWS, abre un ticket de soporte con DoiT en cuanto sospeches que tu cuenta está comprometida. Nuestro equipo coordina con AWS el caso de seguridad y la solicitud de ajuste de facturación, y te ayuda a reunir la evidencia que AWS solicita.
Tu checklist contra el LLMjacking
En AWS
- Sin claves de usuario IAM de larga duración para personas ni workloads. Claves antiguas auditadas y eliminadas.
- Root: MFA por hardware, sin claves de acceso y un correo monitoreado en un dominio de tu propiedad.
- Contactos alternos de SECURITY y OPERATIONS configurados en todas las cuentas.
- SCP que denieguen Bedrock donde no se necesita, restrinjan las suscripciones a Marketplace y bloqueen
GetFederationToken. - Cuotas de tokens por minuto de Bedrock dimensionadas según la necesidad.
- CloudTrail de organización, registro de invocaciones de Bedrock y GuardDuty en cada cuenta y región.
En DoiT Cloud Intelligence
- Una allocation que cubra Bedrock más el gasto de Marketplace "(Amazon Bedrock Edition)".
- Alertas de umbral diarias por cuenta sobre esa allocation, incluidas las cuentas que "deberían estar en cero".
- Un presupuesto en cada cuenta de AWS, incluidas las inactivas.
- Notificaciones de anomalías en Warning o superior, con renotificación y un destinatario real.
- Detección de anomalías en tiempo real en AWS (planes Enhanced y Enterprise).
- Recetas de Composer para claves obsoletas y de admin, postura del root, contactos de seguridad, cobertura de trails y uso de claves de Bedrock fuera de tus cuentas de IA.
- CloudFlow: contención con aprobación a partir de alertas y detección de servicios usados por primera vez.
Los atacantes ganan dinero con el LLMjacking, así que seguirán buscando cuentas que nadie vigila. Una detección perfecta no es realista. Pero sí puedes convertir tu cuenta en un objetivo caro, ruidoso y de corta vida. Y si algo se cuela, puedes enterarte en cuestión de horas y no por la factura.
¿Quieres ayuda para revisar tus guardrails de AWS o configurar alertas, presupuestos y CloudFlow de DCI para workloads de IA? Habla con DoiT.


