
Cloud Intelligence™
Gestion des coûts IA : quand les critères CFM de Gartner rattrapent les dépenses en IA
La gestion des coûts IA applique les critères CFM de Gartner — risque financier, prévisions, efficacité, responsabilisation — aux dépenses en tokens et en GPU.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


About Josh Palmer
I'm Josh Palmer, Head of Content at DoiT, where I split my time across multiple business units including DoiT Cloud Intelligence, PerfectScale (Kubernetes cost optimization), and SELECT (Snowflake, Databricks, and BigQuery cost optimization). Before DoiT, I spent four and a half years at OnBoard building content for a board intelligence platform used by 6,000+ organizations, and before that, two years as Content Marketing Manager at Zylo, a SaaS management platform.
My personal pageTL;DR : La gestion des coûts IA consiste à mesurer, attribuer, prévoir et optimiser les dépenses d'une organisation en workloads IA et LLM : tokens, calcul GPU, inférence et l'infrastructure qui les entoure. Ce n'est pas une discipline distincte de la gestion financière du cloud (CFM), mais plutôt son prolongement.
Qu'est-ce que la gestion des coûts IA ?
La gestion des coûts IA regroupe les pratiques et les outils qui relient les dépenses d'une organisation en IA — appels d'API de modèles, infrastructure GPU, workloads agentiques — aux équipes, produits et résultats qui génèrent ces dépenses. L'objectif est le même que celui fixé par le FinOps pour l'infrastructure cloud il y a dix ans : donner à la finance et à l'engineering une vision commune et fiable des dépenses, afin de prendre les décisions à partir des mêmes chiffres, plutôt que la finance ne voie qu'une facture et l'engineering une boîte noire.
Si la gestion des coûts IA est traitée comme une catégorie à part entière, et non comme du FinOps cloud, mais pour l'IA, c'est parce que l'infrastructure IA se comporte très différemment. Les dépenses cloud sont relativement stables : une instance a un propriétaire, une facture a un identifiant de ressource, un tag survit au trajet entre le provisionnement et la facturation. Les workloads IA remettent en cause plusieurs de ces hypothèses à la fois. Un compte API de modèle partagé peut servir une dizaine d'équipes depuis une seule ligne de facturation. Une passerelle LLM peut supprimer l'identité de l'appelant avant même que la requête n'atteigne le fournisseur. Un pipeline agentique peut lancer des sous-agents pendant la nuit et déclencher des coûts d'infrastructure bien réels que personne n'avait instrumentés, faute d'avoir anticipé le schéma d'appels.
C'est précisément cet écart que la gestion des coûts IA vise à combler : appliquer la discipline de l'allocation des coûts, de la prévision, de l'optimisation et de la gouvernance à des workloads qui évoluent plus vite et partagent davantage que l'infrastructure pour laquelle le FinOps a été conçu à l'origine.
Pourquoi les critères de gestion financière du cloud de Gartner s'étendent-ils à l'IA ?
Le Magic Quadrant de Gartner consacré aux outils de Cloud Financial Management évalue déjà les éditeurs sur quatre capacités : gérer le risque financier, prévoir les dépenses, améliorer l'efficacité et renforcer la responsabilisation. Aucune de ces capacités obligatoires n'est nouvelle, et aucune n'est spécifique à l'IA par définition. Ce qui change, c'est le périmètre des workloads qu'elles doivent couvrir.
Côté demande, le signal est sans équivoque. Le rapport State of FinOps 2026 de la FinOps Foundation, fondé sur une enquête auprès de près de 1 200 praticiens représentant plus de 83 milliards de dollars de dépenses cloud annuelles, révèle que 98 % des équipes FinOps gèrent désormais des dépenses IA, contre 63 % en 2025 et seulement 31 % en 2024. La gestion des coûts IA arrive en tête des compétences que les équipes FinOps souhaitent acquérir dans l'année à venir, et lorsqu'on a demandé aux praticiens quelle capacité leur manquait le plus dans leurs outils, la réponse la plus fréquente a été le suivi granulaire des dépenses IA : tokens, requêtes LLM et utilisation des GPU. En trois ans, les dépenses IA sont passées d'une ligne négligeable à une responsabilité qui incombe à presque toutes les équipes FinOps — sans catégorie d'outils conçue spécifiquement pour y répondre.
Le calendrier de recherche de Gartner pointe dans la même direction. Une session de la conférence Gartner IT Infrastructure, Operations & Cloud Strategies de décembre 2026 à Tokyo désigne déjà cette recherche sous le nom de Magic Quadrant for Cloud and AI Financial Management Tools, abrégé en CAIFM, et associe ce changement de nom au fait que les éditeurs sont de plus en plus évalués au-delà des seules dépenses cloud, notamment sur leur capacité à gérer et optimiser les coûts des workloads IA en particulier. C'est une confirmation parmi d'autres, pas une preuve à elle seule, mais elle rejoint ce que les praticiens constatent déjà sur le terrain.
En clair : les critères que Gartner utilise déjà pour évaluer les outils CFM ne sont pas remplacés. On leur demande simplement de couvrir une catégorie de dépenses qui n'existait pas à une échelle significative lorsque la plupart de ces outils ont été conçus.
Que recouvre concrètement la gestion des coûts IA ?
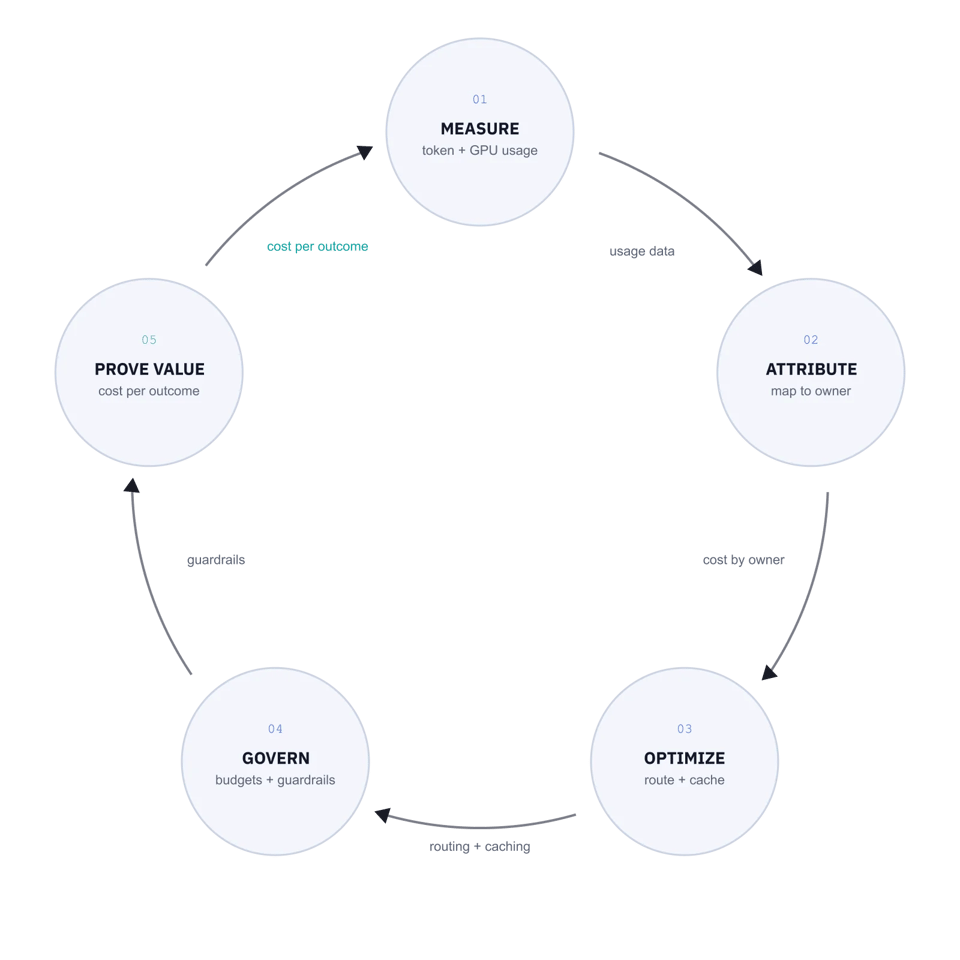
Appliquées spécifiquement aux workloads IA, les quatre capacités CFM obligatoires de Gartner se traduisent par une boucle opérationnelle assez cohérente — que les travaux FinOps for AI de la FinOps Foundation décrivent d'ailleurs en des termes similaires.
Mesurer. Capturer l'usage au niveau où l'IA est réellement facturée : les tokens, pas les heures d'instance. Tokens d'entrée, de sortie, mis en cache et de raisonnement sont facturés à des tarifs différents selon le fournisseur ; la mesure doit donc se faire au niveau de la requête, pas du compte.
Attribuer. Rattacher cet usage à un propriétaire, une équipe, une fonctionnalité produit, un client — le même objectif de responsabilisation que le showback et le chargeback ont toujours servi, appliqué à des workloads où le tagging fait souvent défaut. Les clusters GPU partagés et les passerelles LLM suppriment ou masquent régulièrement le signal dont dépend le tagging traditionnel.
Optimiser. Router les requêtes vers le bon niveau de modèle selon la tâche — plus petit et moins cher pour la classification et l'extraction, plus grand et plus coûteux pour les tâches qui exigent réellement de la profondeur de raisonnement — et actionner des leviers comme le prompt caching et le traitement par lots lorsque la latence le permet. C'est l'équivalent IA du right-sizing et de la gestion des commitments dans l'optimisation des coûts cloud traditionnelle.
Gouverner. Définir des budgets, des alertes et des garde-fous à l'exécution : plafonds stricts sur la profondeur des appels d'outils agentiques, budgets de tokens par équipe, détection d'anomalies calibrée sur la façon dont les dépenses IA s'emballent réellement. Un cycle de reporting mensuel classique peut détecter un pic de coûts IA avec plusieurs jours de retard ; des workloads agentiques peuvent multiplier les dépenses en quelques heures.
Prouver la valeur. Traduire les dépenses brutes en indicateurs actionnables pour le métier : coût par inférence, coût par tâche réussie, coût par client. C'est la déclinaison IA des unit economics, et c'est l'étape que la plupart des programmes FinOps for AI peinent encore à boucler, en grande partie parce que la couche de mesure sous-jacente n'est pas encore solide.
Quelle est l'ampleur réelle des dépassements de coûts IA ?
Plus importante que ce que la plupart des équipes FinOps anticipaient. Une enquête auprès de 500 dirigeants financiers au sein d'organisations qui investissent déjà dans l'IA, commandée par DoiT et menée de façon indépendante par Sapio Research en février 2026, révèle que l'IA représente désormais en moyenne 17,6 % des dépenses technologiques totales. Pourtant, 79 % des répondants ont connu des dépassements de coûts liés à l'IA au cours des 12 derniers mois, et seuls 15 % étaient en mesure de calculer le ROI de l'IA sans obstacles majeurs.
Le constat le plus contre-intuitif de ces données : les organisations qui jugent leur propre pratique FinOps très mature ou à la pointe affichent le taux de dépassement le plus élevé, à 89 %. Ce n'est pas la preuve qu'une gouvernance mature échoue. Il est plus probable que ces organisations mènent des initiatives IA plus vastes et plus complexes, et disposent de la visibilité nécessaire pour détecter des dépassements qui échappent tout simplement aux équipes moins matures. La maturité révèle le problème ; elle ne comble pas d'elle-même le déficit de mesure sous-jacent.
C'est exactement ce déficit que la gestion des coûts IA — et, par extension, les critères que Gartner est en train d'élargir — cherche à combler.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Que faut-il attendre d'un outil de gestion des coûts IA ?
La checklist CFM existante de Gartner — dashboards configurables, détection d'anomalies, analytique pilotée par l'IA, suivi de l'utilisation, contrôles budgétaires, optimisation des ressources et workflows de remédiation — reste valable. Par-dessus, une poignée d'exigences propres à l'IA distinguent les outils qui gèrent véritablement les coûts IA de ceux qui se sont contentés d'ajouter une ligne après coup.
Une granularité au niveau des tokens et des GPU. Un reporting au niveau du compte, voire du service, ne suffit pas. Il vous faut une visibilité sur les tokens d'entrée, de sortie, mis en cache et de raisonnement, ventilés par modèle et par fournisseur — pas seulement une facture API globale.
Une attribution multi-fournisseurs. La plupart des entreprises utilisent plusieurs fournisseurs de modèles — Anthropic, OpenAI, Google Gemini, AWS Bedrock — souvent en parallèle. Un outil qui ne couvre que le dashboard d'usage d'un seul fournisseur recrée la prolifération d'outils que le FinOps multi-cloud a mis dix ans à résoudre côté infrastructure.
La prise en charge des infrastructures partagées et agentiques. Demandez précisément comment un outil attribue les coûts lorsqu'une requête transite par une passerelle LLM, ou lorsqu'un agent lance des sous-agents qui déclenchent des coûts en dehors de l'appel initial. Si la réponse repose entièrement sur des tags ou une instrumentation SDK, demandez ce qu'il advient des dépenses lorsqu'un changement d'infrastructure casse la chaîne avant que l'engineering n'ait le temps de suivre.
Des unit economics, pas seulement des totaux de dépenses. Coût par inférence, coût par client, coût par fonctionnalité. Un dashboard qui montre uniquement ce qui a été dépensé, sans lien avec ce que cette dépense a produit, ne résout que la moitié du problème.
Une attribution sans friction. Une instrumentation qui suppose que chaque équipe tague correctement chaque requête, en permanence, se dégrade dès que les schémas d'usage évoluent. Les approches qui mesurent la consommation au niveau de l'infrastructure, plutôt que de compter sur des tags survivant au trajet de la requête à la facture, résistent mieux face à une architecture IA qui évolue plus vite que la plupart des équipes d'engineering ne peuvent la documenter.
Comment cela se traduit-il selon les fournisseurs de modèles ?
Les guides tarifaires par fournisseur publiés sur le blog de DoiT défendent le même argument sous différents angles, et c'est bien là le propos : ce n'est ni un problème Anthropic, ni un problème Bedrock, ni un problème OpenAI. C'est le même déficit de mesure qui se manifeste sur trois structures de facturation différentes.
Les modèles Claude d'Anthropic facturent séparément les tokens d'entrée et de sortie selon le niveau (Haiku, Sonnet, Opus) : un même workflow agentique peut donc voir ses coûts varier fortement selon le niveau qui traite chaque étape, l'activation ou non du prompt caching, et le passage éventuel des requêtes par une passerelle partagée. Amazon Bedrock ajoute un second axe : les modes à la demande, débit provisionné et inférence par lots présentent des compromis coût/latence différents, et le seul choix du modèle peut faire varier les tarifs par token d'un facteur 10 à 20 au sein d'une même famille de modèles. L'intégration usage et coûts d'OpenAI existe pour la même raison : le problème d'attribution ne disparaît pas parce que le fournisseur change.
La plupart des entreprises utilisent plusieurs de ces fournisseurs à la fois, souvent au sein de la même application — c'est précisément pourquoi l'attribution multi-fournisseurs figure dans la checklist ci-dessus. Un outil CFM qui ne couvre que le dashboard d'usage d'un seul fournisseur ne comble pas l'angle mort : il ne fait que le déplacer. DoiT intervient sur les trois fronts, via ses practices Anthropic et OpenAI et ses intégrations natives Bedrock, Vertex AI et Azure AI, autour du même enjeu : rendre les dépenses IA multi-fournisseurs visibles, attribuables et justifiables à mesure qu'elles montent en charge, plutôt que trois lignes de facturation distinctes que la finance découvre une fois la facture arrivée.
Foire aux questions
Qu'est-ce que la gestion des coûts IA ?
La gestion des coûts IA consiste à mesurer, attribuer, prévoir et optimiser les dépenses liées aux workloads IA et LLM : tokens, calcul GPU, inférence et l'infrastructure qui les soutient. Elle étend la discipline que le FinOps a bâtie pour l'infrastructure cloud à une catégorie de dépenses au comportement différent : moins stable, plus partagée et en évolution plus rapide.
Quelle est la différence entre gestion des coûts IA et FinOps IA ?
En pratique, les deux termes sont utilisés de manière interchangeable. Le FinOps IA met plutôt l'accent sur le modèle opérationnel transverse — finance et engineering travaillant à partir des mêmes chiffres — tandis que la gestion des coûts IA décrit plus souvent la pratique et l'outillage sous-jacents. Aucun des deux termes n'a encore de définition standardisée, ce qui témoigne en soi de la nouveauté de la catégorie.
Gartner ajoute-t-il des critères spécifiques à l'IA au Magic Quadrant Cloud Financial Management ?
Les signes vont dans ce sens. Une session de la conférence Gartner de décembre 2026 désigne déjà la prochaine édition sous le nom de Magic Quadrant for Cloud and AI Financial Management (CAIFM) Tools, et le descriptif de la session associe ce changement de nom au fait que les éditeurs sont évalués sur leur capacité à gérer et optimiser les coûts des workloads IA, et plus seulement les dépenses cloud traditionnelles.
En quoi l'optimisation des coûts IA diffère-t-elle de l'optimisation des coûts cloud ?
L'optimisation des coûts cloud recouvre généralement le right-sizing, la gestion des commitments et l'élimination des ressources inutilisées, sur une infrastructure dont le propriétaire et la forme sont relativement stables. L'optimisation des coûts IA ajoute à cette panoplie le routage de modèles (faire correspondre la complexité de la tâche au modèle le moins cher capable de la traiter), le prompt caching et le traitement par lots, et doit composer avec des dépenses dont la propriété peut changer en cours de requête, d'une manière que l'infrastructure traditionnelle connaît rarement.
Les dépassements de coûts IA sont-ils fréquents ?
Suffisamment fréquents pour relever davantage de la norme que de l'exception. Une enquête de février 2026 auprès de 500 dirigeants financiers, commandée par DoiT et menée de façon indépendante par Sapio Research, révèle que 79 % d'entre eux avaient connu des dépassements de coûts liés à l'IA au cours des 12 derniers mois — un taux qui grimpe à 89 % parmi les organisations qui jugent leur pratique FinOps la plus mature.
Quels indicateurs un programme de gestion des coûts IA doit-il suivre ?
La plupart des programmes suivent une combinaison de coût par token, coût par inférence, coût par fonctionnalité et coût par client ou par compte, ainsi que la ventilation des tokens d'entrée, de sortie, mis en cache et de raisonnement, qui varie selon le fournisseur. Les équipes d'engineering privilégient généralement le détail au niveau des workloads ; les équipes finance préfèrent des agrégats par compte ou par fonctionnalité, reliés aux données de revenus ou de renouvellement.


