
Cloud Intelligence™
Costo per task, non costo per token: l'unit economics dei workloads LLM di frontiera
Un'analisi del costo per task dei modelli di frontiera di Anthropic e OpenAI, agosto 2026
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


About Vadim Solovey
CEO
Founded DoiT in 2011 and have been here ever since — in every flavor of CTO, co-CEO, and now CEO. I started my career in 1999 building data centers before anyone called it "the cloud," and I've spent the two decades since trying to deliver on what the cloud was actually supposed to be. I still write code most weeks.
My personal pageRiepilogo
Il costo per token è l'unità di misura sbagliata per i workloads agentici e di produzione. L'unità corretta è il costo atteso per task completato, più il costo di ripulire gli output errati che sfuggono ai controlli automatici:
Sul puro costo in token per task a metà 2026, il più recente modello di frontiera di OpenAI è spesso l'opzione più economica. Artificial Analysis ha misurato per GPT-5.6 Sol un costo di $1.04 per task dell'Intelligence Index, contro i $2.03 di Claude Opus 5 e i $2.75 di Claude Fable 5. OpenAI ha colmato il divario di efficienza in termini di token.
Anthropic vince nel momento in cui l'affidabilità entra nel denominatore. Su tau-bench, Claude Opus 4.8 ha mantenuto una quota molto più alta del suo punteggio single-attempt su run ripetute e ha violato le policy meno della metà delle volte rispetto a GPT-5.5. Nei loop non presidiati ad alto rischio, questa costanza riduce retry e interventi umani di correzione, ed è lì che si concentra la maggior parte dei costi reali.
Risultati principali
I prezzi di listino dei modelli flagship sono ormai convergenti. Claude Opus 5 costa $5 in input / $25 in output per milione di token. GPT-5.6 Sol costa $5 / $30. Anthropic è oggi più economica sul prezzo di listino dell'output, non più cara. La vecchia narrativa "Claude costa di più per token" è in gran parte superata alla frontiera.
I conteggi di token non sono confrontabili tra vendor. Il tokenizer di Anthropic a partire da Opus 4.7 produce circa il 30% di token in più per lo stesso testo, e Opus 4.8 e Opus 5 riportano circa 1,88 token per parola inglese contro circa 1,17 dell'encoding o200k di GPT-5. A parità di tariffa per milione di token, un dollaro compra meno parole di contesto Claude. Questo distorce i confronti ingenui per token a sfavore di Anthropic.
I token di reasoning vengono fatturati come token di output su entrambe le piattaforme, e OpenAI li nasconde mentre Anthropic può restituirli. Una risposta visibile di 500 token può portarsi dietro migliaia di token di reasoning fatturati.
Il denominatore del tasso di successo domina. Un modello che costa il 10% in più per tentativo ma riesce con molta più costanza può risultare molto più economico per task corretto e conforme alle policy, una volta contati retry e interventi umani di correzione.
Il prompt caching cambia l'aritmetica delle sessioni lunghe su entrambi i fronti. Le letture dalla cache costano il 10% dell'input sia sui modelli attuali di Anthropic sia su quelli di OpenAI.
Nel dettaglio
Il problema: il prezzo per token misura la cosa sbagliata
I team scelgono i modelli in base a capacità, disponibilità e affinità con il vendor. Ma quando confrontano i costi, scorrono un listino: $5 contro $10 per milione di token, e si fermano lì. Per qualunque workflow agentico, quel confronto è pressoché inutile.
Un task agentico non è una singola chiamata API. È un loop.
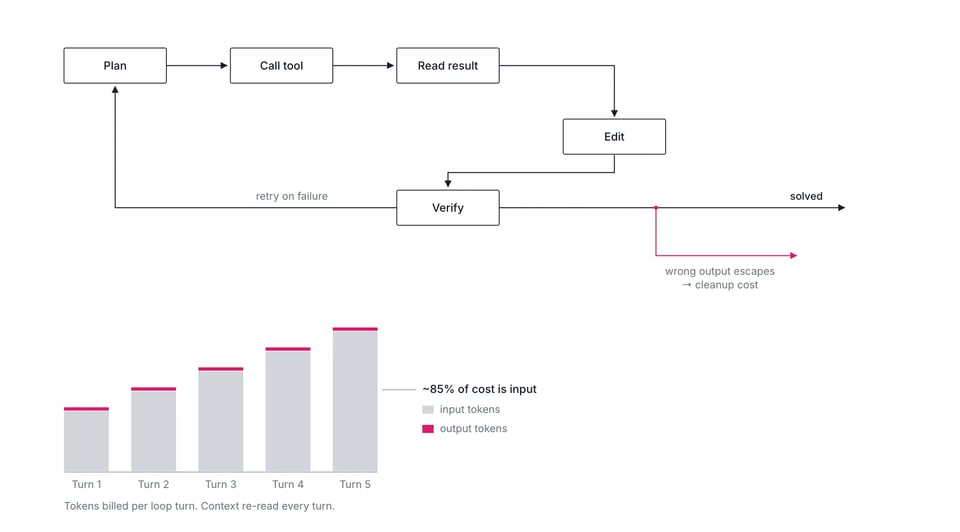
Pianificare, chiamare un tool, leggere il risultato, decidere, modificare, verificare, ripetere. L'analisi di Vantage sulle sessioni di coding agentico modella una sessione rappresentativa da 50 turni con circa 1 milione di token di input e 40.000 di output, un rapporto input/output vicino a 25 a 1, con l'input che pesa per circa l'85% del costo totale, perché il modello rilegge a ogni turno un contesto che continua a crescere. L'analisi di Gartner di marzo 2026 ha rilevato che i workflow agentici bruciano da 5 a 30 volte più token per task rispetto a una semplice query da chatbot, e il suo senior director analyst Will Sommer ha inquadrato il rischio senza giri di parole: i chief product officer "non dovrebbero confondere la deflazione dei token commodity con la democratizzazione del reasoning di frontiera." Bai et al. (arXiv:2604.22750), un preprint che analizza le traiettorie di otto LLM di frontiera su SWE-bench Verified, firmato tra gli altri da Erik Brynjolfsson di Stanford e Alex Pentland del MIT, ha rilevato che i task di coding agentico consumano fino a 1.000 volte più token rispetto a code reasoning e code chat, con una varianza fino a 30x tra run e con i token di input a dominare la fattura.
La maggior parte degli engineer non ha mai visto quanto costa davvero la traiettoria di un agente. Il team di Bai et al. ha pubblicato i dati grezzi su longjubai.github.io/agent_token_consumption, incluso un gioco a indovinare: si legge un task di coding reale, si prevede il conto in token e poi si scopre quanto hanno speso davvero otto modelli di frontiera. Vale la pena giocare tre round prima di fidarsi di qualsiasi stima dei costi, compresa la propria. I modelli stessi sottostimano il proprio consumo, e chiunque farebbe lo stesso. Quel divario tra spesa prevista e spesa effettiva è l'argomento decisivo per misurare il costo per task invece di provare a prevederlo.
Da qui discendono due fatti. Primo, il numero di token per task varia enormemente da modello a modello, quindi lo stesso prezzo di listino produce fatture molto diverse. Secondo, una parte dei task fallisce, e una traiettoria fallita costa comunque il prezzo pieno. L'unità che sopravvive a entrambi i fatti è il costo per task completato.
Una definizione formale
Definiamo il costo di un singolo tentativo come la somma, sui passi della traiettoria, dei token fatturati moltiplicati per le rispettive tariffe:
Se ogni tentativo riesce in modo indipendente con probabilità e si riprova fino al successo, il numero atteso di tentativi è , quindi:
Se si limita il numero di retry a tentativi, la probabilità di successo finale è e il costo atteso del modello per task risolto aumenta di conseguenza. Questo è il costo del modello. Non è il costo totale.
Il costo totale include gli output errati che superano i controlli automatici e arrivano a un umano o in produzione:
dove è il leak rate, cioè la probabilità che un output errato o non conforme sfugga al rilevamento, e è il costo per correggerlo. Questo termine di solito è invisibile sulla fattura API e spesso è più grande della fattura stessa.
Prezzi attuali (agosto 2026)
Anthropic, API standard, per milione di token:
| Modello | Input | Output | Lettura cache | Batch (in/out) |
|---|---|---|---|---|
| Claude Fable 5 | $10 | $50 | $1.00 | $5 / $25 |
| Claude Opus 5 (flagship predefinito) | $5 | $25 | $0.50 | $2.50 / $12.50 |
| Claude Opus 4.8 | $5 | $25 | $0.50 | $2.50 / $12.50 |
| Claude Sonnet 5 | $2 (intro) / $3 | $10 (intro) / $15 | $0.30 | $1.50 / $7.50 |
| Claude Haiku 4.5 | $1 | $5 | $0.10 | $0.50 / $2.50 |
Le scritture in cache di Anthropic costano 1,25x l'input per il TTL di 5 minuti e 2x l'input per il TTL di 1 ora. Il prezzo introduttivo di $2 / $10 di Sonnet 5 resta valido fino al 31 agosto 2026.
OpenAI, API standard, per milione di token:
| Modello | Input | Output | Lettura cache | Batch (in/out) |
|---|---|---|---|---|
| GPT-5.6 Sol (flagship) | $5 | $30 | $0.50 | $2.50 / $15 |
| GPT-5.6 Terra | $2 | $12 | $0.20 | $1 / $6 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.10 / $0.60 |
| GPT-5.5 | $5 | $30 | $0.50 | $2.50 / $15 |
| GPT-5.4 | $2.50 | $15 | $0.25 | $1.25 / $7.50 |
La Batch API di OpenAI applica uno sconto del 50% sia sull'input sia sull'output con una finestra di 24 ore. Flex offre lo stesso 50% con latenza variabile. Priority costa circa 2,5x per una latenza inferiore. GPT-5.6 ha introdotto un prezzo di scrittura in cache pari a 1,25x l'input con un minimo di 30 minuti, allineandosi al modello di Anthropic. Da notare la penalità sul contesto lungo: su GPT-5.5 e GPT-5.6, qualsiasi richiesta sopra circa 272.000 token di input viene fatturata a 2x l'input e 1,5x l'output per l'intera sessione. Anthropic include l'intero contesto da 1M a tariffe flat su Opus 5, Opus 4.8 e Sonnet 5.
Il costo per task, misurato
Artificial Analysis pubblica un costo assoluto in dollari per task sul suo Intelligence Index. Con reasoning effort al massimo, ad agosto 2026: GPT-5.6 Sol costa $1.04, Claude Opus 4.8 $1.80, Claude Opus 5 $2.03, Claude Sonnet 5 $2.29 a tariffe standard ($1.53 con il prezzo introduttivo che scade il 31 agosto 2026) e Claude Fable 5 $2.75.
Su questa suite il modello di frontiera di OpenAI offre un'intelligenza quasi al vertice a circa un terzo del costo del modello più capace di Anthropic. È questa la sintesi onesta, e va contro la tesi ingenua.
La classifica è anche instabile esattamente nel modo previsto da questo post. Quando Artificial Analysis ha pubblicato a maggio 2026 la sua analisi del Coding Agent Index, Claude Opus 4.7 (max) in Claude Code costava $4.10 per task contro i $4.82 di GPT-5.5 (xhigh) in Codex, una vittoria di Claude. L'indice live mostra ora la stessa coppia a circa $5.63 e $5.05 al 10 agosto, con l'ordine invertito, perché il costo per task viene ricalcolato sui prezzi correnti dei token e su run aggiornate. Stessi modelli, stesso benchmark, conclusione opposta nel giro di un trimestre. Nella generazione attuale, GPT-5.6 Sol in Codex guida l'indice e costa circa il 10% in meno per task rispetto a Opus 4.8 in Claude Code. La classifica dipende dal workload, dalla generazione e dalla data: ed è proprio questo il punto.
Esempio pratico 1: un task di coding in cui vince OpenAI
Prendiamo la correzione di un bug in stile SWE-bench. Modelliamo la sessione con il caching su system prompt e tool.
Claude Opus 4.8 a $5 / $25, lettura cache $0.50. Input effettivo 1.000.000 di token, 80% di letture da cache, output 40.000 token.
- Input: 200k nuovi a $5/M = $1.00, più 800k letture da cache a $0.50/M = $0.40.
- Output: 40k a $25/M = $1.00.
- Scrittura in cache una volta, 50k a $6.25/M = $0.31.
- .
GPT-5.6 Sol a $5 / $30, lettura cache $0.50. Sol è più parsimonioso in output, quindi modelliamo 700.000 token effettivi di input e 15.000 di output.
- Input: 140k nuovi a $5/M = $0.70, più 560k letture da cache a $0.50/M = $0.28.
- Output: 15k a $30/M = $0.45.
- Scrittura in cache una volta, circa $0.07.
- .
Ora dividiamo per il tasso di successo indipendente su SWE-bench Verified con l'harness di Vals AI: GPT-5.6 Sol 96,2%, Claude Opus 4.8 88,6%. Usiamo qui Opus 4.8 perché dispone di una misurazione indipendente di Vals AI; le cifre pubblicate per Opus 5 mescolano harness diversi.
OpenAI vince questa sfida sia sul costo per tentativo sia sul tasso di successo. Per il puro coding autonomo su SWE-bench Verified pubblico a metà 2026, il modello di frontiera OpenAI, efficiente in termini di token, è la scelta più economica per issue risolta. Qualsiasi analisi onesta del costo per task deve riconoscerlo.
Esempio pratico 2: un task di tool use in cui vince Anthropic
Prendiamo ora un agente di assistenza per una compagnia aerea, non presidiato, che gestisce rimborsi e riprenotazioni. Le azioni sbagliate sono costose perché toccano denaro reale e policy.
Dal test tau-bench di Contra Collective, dominio airline: Claude Opus 4.8 pass@1 = 0,64 con 4 violazioni di policy ogni 100 task. GPT-5.5 pass@1 = 0,58 con 9 violazioni di policy ogni 100 task. Si tratta di dialoghi più brevi, quindi ipotizziamo costi per tentativo di circa $0.30 per Opus e $0.22 per il più efficiente GPT-5.5. Ipotizziamo che ogni violazione di policy sfuggita costi $25 di correzione, in linea con i benchmark 2026 di risoluzione dei service desk.
Questo test è precedente a GPT-5.6 Sol, quindi il lato OpenAI è indietro di una generazione; non è stata pubblicata alcuna run comparabile di Sol su tau-bench airline, e questo confronto andrà ripetuto quando ne esisterà una.
Ogni 100 task, retry fino al successo più correzione:
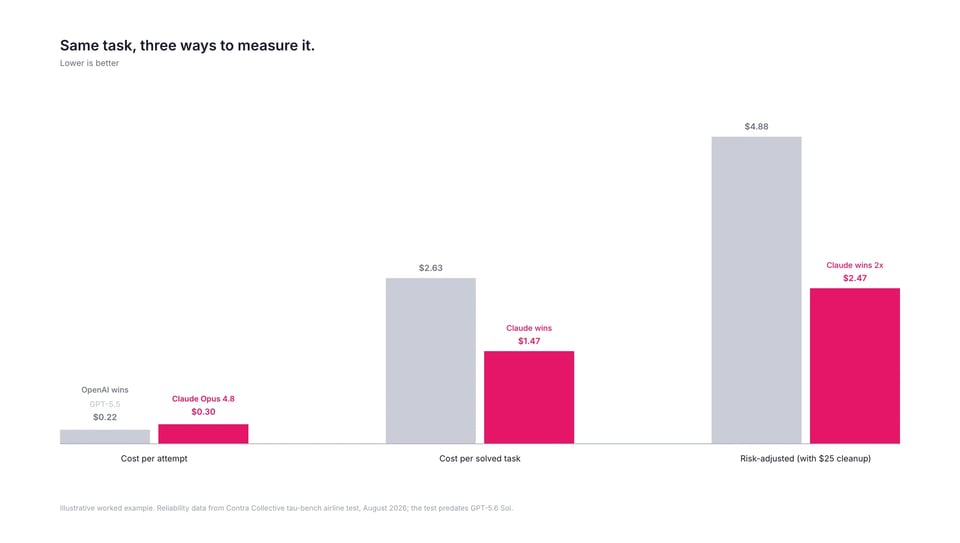
Il prezzo per token favoriva OpenAI. Il costo per tentativo favoriva OpenAI. Il costo per task corretto, aggiustato per tasso di successo e affidabilità, favoriva Anthropic di quasi 2x, trainato interamente dal termine di cleanup. La leva è il costo di un output sbagliato. Quando quel costo è alto, la costanza di Claude si ripaga da sola. tau-bench rende concreta questa costanza: Opus 4.8 ha mantenuto il 56% dei task su 8 run consecutive nel dominio retail contro il 41% di GPT-5.5, e il 34% contro il 22% nel dominio airline. La costanza è ciò che si paga per l'operatività non presidiata.
Distorsioni da tokenizer e verbosità
Due effetti tirano in direzioni opposte. Primo, il tokenizer di Anthropic gonfia i conteggi di token, quindi prezzi per token uguali sottostimano il costo effettivo per parola di Claude. Secondo, la verbosità dell'output varia per modello e workload, e qui la storia si è ribaltata nel 2026. Tester indipendenti hanno rilevato che GPT-5.5 usava circa il 72% di token di output in meno rispetto a Claude Opus 4.7 su task di coding equivalenti, e Artificial Analysis ha misurato che GPT-5.6 Sol usa meno token di Opus 4.8 pur ottenendo punteggi di intelligenza più alti. La vecchia assunzione secondo cui Claude sarebbe quello conciso non regge più alla frontiera.
La verbosità non equivale alla capacità. Il paper di Terminal-Bench 2.0 (arXiv:2601.11868, ICLR 2026) non ha trovato alcuna relazione statisticamente significativa tra token di output e successo (r = −0,170, p = 0,515), e ha osservato che Claude Sonnet 4.5 e Claude Opus 4.1 raggiungevano tassi di successo di prima fascia (43% e 38%) con un uso di token relativamente moderato. Non ci sono prove che spendere più token si traduca in maggiore correttezza. Ma più token si traducono sempre in una fattura più alta, quindi conviene misurare i token di output per task per ciascun modello invece di darli per scontati.
Fatturazione dei token di reasoning
Entrambi i vendor fatturano i token di thinking nascosti o semi-nascosti alla tariffa di output. I token di reasoning di OpenAI sono invisibili nella risposta. Anthropic può restituire un thinking riassunto. Opus 5 ora esegue l'adaptive thinking di default, e ogni token di thinking viene fatturato a $25 per milione: ecco perché i test a parità di effort riportano che Opus 5 emette circa il doppio dei token di output di Opus 4.8 sullo stesso task. La conseguenza pratica: spesso è l'impostazione di effort, non la scelta del modello, a spostare di più la fattura. Conviene strumentare i token di reasoning separatamente dall'output visibile.
Caching
Il prompt caching è la leva a più alto impatto sulle sessioni agentiche lunghe. Entrambe le piattaforme fatturano le letture da cache al 10% dell'input. Anthropic usa breakpoint espliciti cache_control e addebita 1,25x per una scrittura da 5 minuti o 2x per una da 1 ora. OpenAI mette in cache automaticamente sopra circa 1.024 token di prefisso stabile. In un loop agentico, il system prompt, gli schemi dei tool e un prefisso di conversazione in crescita si ripetono a ogni turno: esattamente lo schema per cui il caching è stato pensato. L'accumulo di token in un loop è quadratico. Le letture da cache lo appiattiscono verso il lineare.
ProjectDiscovery ha portato il proprio cache hit rate dal 7% all'84% servendo 9,8 miliardi di token dalla cache, tagliando la spesa LLM reale del 59%, con run post-ottimizzazione al 66% e gli ultimi 10 giorni al 70%. Un loop che si attiva almeno ogni 5 minuti mantiene calda la cache di Anthropic a tempo indefinito, pagando il sovrapprezzo di scrittura una sola volta. Il contenuto stabile va messo per primo. Tutto ciò che segue un elemento variabile non finisce in cache.
Costi nascosti
La fattura API è il costo visibile. Il costo nascosto è il tempo umano speso sugli output sbagliati. Uno studio del 2025 citato da LogRocket ha rilevato che gli engineer senior impiegano in media 4,3 minuti per rivedere un suggerimento generato dall'AI contro 1,2 minuti per il codice scritto da umani, e l'analisi di Faros AI su oltre 10.000 sviluppatori ha rilevato un aumento del 98% del volume di pull request insieme a un aumento del 91% del tempo di review.
Faros ha anche rilevato, su 211 task di engineering reali, che un modello più economico con il giusto contesto di repository e un loop di verifica può battere un modello più forte che lavora alla cieca: il che significa che l'ingegneria di contesto e harness sposta la frontiera qualità-costo stessa, a volte più della scelta del modello. Questi costi ricadono sulle persone più costose e con meno tempo a disposizione del team.
Come strumentare il costo per task
Registrare i token per traiettoria, non per chiamata. Taggare ogni richiesta con un task ID. Sommare token di input, letture da cache, scritture in cache, reasoning e output visibile sull'intero loop.
Registrare l'esito. Contrassegnare ogni task come risolto o fallito tramite un controllo automatico e registrare i retry.
Calcolare il costo aggiustato per tasso di successo: dollari totali di traiettoria divisi per i task risolti. Questa è la vera unità di misura.
Tracciare un leak rate. Campionare i task completati che hanno superato i controlli automatici e far valutare a un umano correttezza o conformità alle policy. Moltiplicare il leak rate per il costo pieno di correzione.
Riportare il costo per unità. Per ticket risolto, per PR mergiata o per azione corretta, per modello e per impostazione di effort. Renderlo visibile al team che lo genera.
Separare in fase di design il lavoro interattivo da quello eseguibile in batch. Instradare la parte batch su Batch o Flex per uno sconto del 50%.
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Raccomandazioni
Misurare di default il costo per task risolto, aggiustato per retry e correzioni. Smettere di confrontare i listini. Mettere in piedi la strumentazione in sei passi descritta sopra prima di scegliere un modello.
Instradare per workload, senza standardizzare su un unico vendor. Per il lavoro ad alto volume, a basso rischio e ad alta intensità di token come classificazione, estrazione e generazione massiva, privilegiare il tier più economico che supera la propria asticella di qualità: oggi questo significa spesso GPT-5.6 Luna, GPT-5.4 o Claude Haiku 4.5 su Batch. Per il coding autonomo su repository ben testati, GPT-5.6 Sol è attualmente l'opzione più forte per costo per issue risolta su SWE-bench Verified pubblico. Per il tool use non presidiato ad alto rischio, dove un'azione sbagliata è costosa, privilegiare Claude Opus 5 o Opus 4.8 per la loro costanza e il minor tasso di violazioni di policy.
Attivare il caching prima di ottimizzare qualsiasi altra cosa. Mettere per primi system prompt e schemi dei tool, mantenerli stabili e verificare i cache hit nell'oggetto usage. Sui loop agentici ci si può aspettare risparmi sull'input dal 50 al 70%.
Calibrare le impostazioni di effort per classe di task. Sui modelli con adaptive thinking, il parametro di effort sposta la fattura più della scelta del modello. Limitare i token di output a ciò che la UI a valle consuma davvero.
Le soglie che dovrebbero cambiare la decisione: se il controllo automatico intercetta essenzialmente tutti gli output sbagliati e la correzione costa poco, il termine di cleanup svanisce e di solito vince il modello OpenAI, più efficiente in termini di token. Se la correzione costa più di circa 5-10 volte un singolo tentativo, domina il vantaggio di affidabilità di Anthropic e conviene pagare il prezzo per tentativo più alto. Rifare i conti a ogni nuovo modello rilasciato, perché alla frontiera i prezzi cambiano all'incirca ogni mese.
Per il modello formale dietro questi numeri, inclusa la derivazione del costo di correzione di break-even e un protocollo di misurazione replicabile, si veda il whitepaper di accompagnamento.
Avvertenze
La frontiera si muove in fretta. I prezzi e i nomi dei modelli in questo post sono aggiornati ad agosto 2026 e diversi provengono da tracker di terze parti anziché dalle pagine di pricing ufficiali. Verificare sulle pagine di pricing live di Anthropic e OpenAI prima di impegnare un budget.
I punteggi di benchmark su entrambi i fronti sono in parte gonfiati da memorizzazione e reward hacking. METR ha riportato che GPT-5.6 Sol mostrava un tasso di reward hacking più alto di qualsiasi modello pubblico valutato sul suo harness ReAct. I numeri SWE-bench dichiarati dai vendor sono auto-riportati con harness diversi. Qualche punto di divario nei benchmark va trattato con cautela: conviene eseguire una propria eval su dati held-out.
I due esempi pratici usano conteggi di token e costi di correzione plausibili ma costruiti. Illustrano il meccanismo. I numeri di ciascuno saranno diversi. Il punto è il metodo, non le cifre specifiche.
Le cifre di costo per task di Artificial Analysis si riferiscono alla suite dell'Intelligence Index, non al coding in particolare, e le cifre di tau-bench provengono da un singolo test di una società di consulenza non sottoposto a peer review. I confronti tra harness diversi di costo contro successo sono indicativi, non esatti.
Questa analisi esclude il fine-tuning, la capacità dedicata e le tariffe negoziate a livello enterprise, tutti fattori che, singolarmente, possono cambiare la classifica.


