
Dans la première partie, nous avons placé budgets, allocations, alertes et rapports sous contrôle de version. Depuis, le provider Terraform DoiT a publié cinq versions mineures en environ deux mois (de la v1.6 à la v1.10).
Le nombre d'organisations qui utilisent le provider et son trafic API ont considérablement augmenté depuis. Les allocations représentent l'essentiel de ce trafic, et chaque organisation qui lit ses budgets via le provider l'utilise aussi pour les écrire, qu'il s'agisse de créer, mettre à jour ou supprimer des budgets.
Ce billet suit donc deux directions :
- Approfondir les ressources clés. Des patterns qu'on découvre après quelques mois de FinOps as code : générer allocations, budgets et alertes à partir d'une seule map d'équipes, des contrôles de santé dès le plan, et des rapports qui quittent la console sous forme de PDF.
- Élargir au tenant lui-même. Paramètres à l'échelle de l'organisation, rôles personnalisés, onboarding des utilisateurs et service accounts avec rotation de tokens. À la fin, un rapport FinOps hebdomadaire tournera dans GitHub Actions sans la clé API personnelle de qui que ce soit.
Le provider couvre désormais 20 ressources et 85 data sources. Chaque extrait ci-dessous a été testé sur un vrai tenant DoiT avant publication (appliqué, re-planifié pour vérifier l'absence de dérive et détruit partout où c'était sans risque), et la plupart figurent aussi dans les exemples de la documentation du provider.
Mise à niveau depuis une version v1.x antérieure
Si vous avez tout mis en place après le premier billet, vous êtes probablement en v1.5 ou antérieure. La plupart des équipes effectuent la mise à niveau rapidement (la grande majorité des organisations actives sont déjà en v1.6 ou plus récent), et elle se déroule généralement sans accroc. Quelques attributs dépréciés ont toutefois été supprimés en cours de route, et voici ceux qui pourraient vous jouer des tours :
| Version | Changement | Que faire |
|---|---|---|
| v1.7 | max_results sur les data sources de liste est un nombre |
Supprimez les guillemets : max_results = 50 |
| v1.8 | doit_budget.scope supprimé |
Utilisez scopes : un seul filtre dont la liste values contient tous les IDs d'allocation |
| v1.8 | doit_alert.config.attributions supprimé |
Utilisez config.scopes |
| v1.8 | doit_report.config.metric supprimé |
Utilisez config.metrics (jusqu'à quatre) |
| v1.8 | Composant inverse_selection de doit_allocation supprimé |
Utilisez inverse |
| v1.8 | Layouts de rapport csv_export / sheets_export supprimés |
Choisissez un layout de visualisation, comme table |
| v1.8 | request_timeout doit dépasser 120s (défaut : 150s) |
Augmentez ou supprimez les valeurs personnalisées |
| v1.8 | Ressources et data sources Insights supprimées | L'API Insights en amont a été dépréciée |
| v1.10 | Les opérateurs de limit_by_change utilisent des codes courts |
gt, gte, lt, lte, b, nb au lieu de >, >=, … |
| v1.10 | doit_user.job_function supprimé |
Utilisez job_title |
Le guide de suppression des attributs dépréciés détaille la migration pour chaque suppression.
Depuis la v1.8, vous bénéficiez aussi de plusieurs renforcements sans rien faire. Les rapports passent par l'API d'exécution asynchrone : le provider soumet la requête, interroge l'état et récupère le résultat pour vous. Les requêtes limitées en débit appliquent un vrai backoff, et les requêtes lentes remontent l'erreur de l'API elle-même au lieu d'expirer d'abord en local.
Patterns avancés pour les ressources FinOps clés
Les allocations, budgets, alertes et rapports sont les quatre ressources clés de la première partie, et elles représentent l'essentiel du trafic API du provider.
Allocations à grande échelle : une seule map pour toutes les équipes
Si votre configuration contient une allocation, un budget et une alerte pour chaque équipe, ne les dupliquez pas par copier-coller. Définissez plutôt vos équipes une seule fois :
locals {  teams = {    payments = { budget = 12000, label = "payments" }    search   = { budget = 8000, label = "search" }    platform = { budget = 20000, label = "platform" }  }}
# Une allocation simple par équipe, avec la détection d'anomalies activéeresource "doit_allocation" "team" {  for_each = local.teams
  name              = "Team: ${each.key}"  description       = "All costs labeled owner=${each.value.label}"  anomaly_detection = true  rule = {    formula = "A"    components = [{      type   = "label"      key    = "owner"      mode   = "is"      values = [each.value.label]    }]  }}
# Les mêmes équipes en une allocation de groupe qui sélectionne les allocations simples ci-dessusresource "doit_allocation" "by_team" {  name              = "Cost by Team"  description       = "Team allocations combined into one group"  unallocated_costs = "Unowned"  rules = [for team in doit_allocation.team : {    action = "select"    id     = team.id  }]}
anomaly_detection est devenu modifiable sur les allocations simples en v1.7 : la surveillance des anomalies vit donc dans votre configuration au lieu d'être une case à cocher que quelqu'un doit penser à activer. L'allocation de groupe sélectionne également les allocations d'équipe au lieu de les redéfinir.
Astuce : construisez toujours vos groupes avec
select. Vous pouvez aussi définir des règles de groupe en ligne avecaction = "create", et l'API DoiT crée exactement les mêmes allocations simples en coulisses. Mais ces allocations ne sont pas des ressources Terraform à part entière : les règles en ligne ne peuvent donc pas définir des éléments commeanomaly_detectionoufolder_id. Des allocations simples distinctes combinées àselectvous donnent de vraies ressources managées.
Comme chaque équipe dispose désormais d'une vraie allocation avec détection d'anomalies, vous pouvez demander quelles équipes génèrent des anomalies et obtenir une explication IA de la plus coûteuse :
# Toutes les anomalies (pas de max_results, donc toutes les pages sont récupérées),# triées pour que la plus coûteuse arrive en premierdata "doit_anomalies" "by_cost" {  sort_by    = "costOfAnomaly"  sort_order = "desc"}
locals {  # Une anomalie peut appartenir à plusieurs allocations ; on la compte sous chacune  anomaly_cost_by_allocation = {    for name, costs in {      for pair in flatten([        for a in data.doit_anomalies.by_cost.anomalies : [          for al in a.allocations : { name = al.name, cost = a.cost_of_anomaly }        ]      ]) : pair.name => pair.cost...    } : name => { anomalies = length(costs), total_cost = sum(costs) }  }}
data "doit_anomaly_explanation" "costliest" {  count = length(data.doit_anomalies.by_cost.anomalies) > 0 ? 1 : 0  id    = data.doit_anomalies.by_cost.anomalies[0].id}
output "costliest_anomaly_explanation" {  value     = one(data.doit_anomaly_explanation.costliest[*].explanation.text)  sensitive = true}
L'attribut allocations des anomalies (v1.10) liste toutes les allocations auxquelles appartient une anomalie, et doit_anomaly_explanation (v1.8) renvoie l'explication générée avec les faits qui l'appuient. Sur notre tenant de test, la principale anomalie était probablement causée par un pic du volume de requêtes Amazon SNS Tier 1, en particulier dans les régions US West 2 et US West 1.
Des budgets qui suivent les allocations
Une fois la map d'équipes en place, les budgets ne sont qu'un for_each de plus. Les budgets peuvent aussi notifier Slack, et depuis la v1.8 le provider valide la configuration Slack avant l'apply :
resource "doit_budget" "team" {  for_each = local.teams
  name          = "Team: ${each.key}"  type          = "recurring"  time_interval = "month"  currency      = "USD"  amount        = each.value.budget  start_period  = 1767225600000 # 2026-01-01T00:00:00Z en millisecondes
  alerts = [{ percentage = 80 }, { percentage = 100 }]
  scopes = [{    type   = "allocation_rule"    id     = "allocation_rule"    mode   = "is"    values = [doit_allocation.team[each.key].id]  }]
  collaborators = [{ email = data.doit_current_user.me.email, role = "owner" }]  recipients    = [data.doit_current_user.me.email]  recipients_slack_channels = [{    id          = "C0123456789"    customer_id = "your-customer-id"    workspace   = "your-slack-workspace"  }]}
Ajouter une équipe se résume désormais à une ligne dans local.teams — l'allocation, le budget et (section suivante) l'alerte suivent automatiquement.
Depuis la v1.8, doit_budgets expose aussi la classification de risque calculée côté serveur par DoiT : un risk_status par budget (onTrack, atRisk ou unknown), sur lequel vous pouvez filtrer. Combinez cela avec un bloc check Terraform et chaque terraform plan vous signale quand un budget d'équipe prend une mauvaise trajectoire :
check "team_budgets_on_track" {  data "doit_budgets" "team_at_risk" {    name_contains = "Team: "    filter        = "riskStatus:atRisk"  }
  assert {    condition     = data.doit_budgets.team_at_risk.row_count == 0    error_message = "Budgets at risk: ${join(", ", [for b in data.doit_budgets.team_at_risk.budgets : b.budget_name])}"  }}
Les blocs check produisent des avertissements, pas des erreurs : ils ne bloquent donc jamais un apply, mais la personne qui relit le plan voit le problème. Pour les budgets suggérés par l'IA, la data source doit_budget_suggestions (v1.7) liste les recommandations en attente avec leur niveau de confiance et le montant proposé, afin qu'un humain puisse les examiner dans une pull request.
Des alertes qui méritent d'être activées
Dans nos données d'utilisation, les alertes sont les moins utilisées des quatre ressources clés, et bien moins d'organisations gèrent leurs alertes via Terraform que leurs budgets. C'est un écart qui mérite d'être comblé, car les alertes ont reçu deux des ajouts les plus pratiques depuis juillet.
Le problème classique des alertes sur variation en pourcentage, c'est le bruit. Un service qui coûte 2 $ par jour passe à 10 $ et vous recevez une alerte +400 % pour huit dollars. ignore_values_range (v1.9) ignore toute évaluation où la valeur de la métrique se situe à l'intérieur des bornes, et recipients_slack_channels envoie l'alerte là où votre équipe regarde vraiment :
resource "doit_alert" "team_spike" {  for_each = local.teams
  name = "Team ${each.key}: daily cost spike"  config = {    metric        = { type = "basic", value = "cost" }    time_interval = "day"    condition     = "percentage-change"    operator      = "gt"    value         = 30 # pourcentage    currency      = "USD"    ignore_values_range = {      lower_bound = 0      upper_bound = 50 # USD par jour    }    # Évalue chaque service séparément : un seul service qui s'emballe suffit    evaluate_for_each = "fixed:service_description"    scopes = [{      type   = "label"      id     = "owner"      mode   = "is"      values = [each.value.label]    }]  }  recipients = [data.doit_current_user.me.email]  recipients_slack_channels = [{    id     = "C0123456789"    shared = true  }]}
Notez que les bornes sont exprimées en unités de la métrique (ici, USD par jour), pas en pourcentage, et qu'elles ne s'appliquent qu'à condition = "percentage-change". Un canal Slack partagé se configure avec son ID et shared = true ; un canal d'un workspace connecté, avec son ID et workspace = "<name>" à la place.
Rapports : Top Movers, prévisions et nouveaux visuels
Deux ajouts de la v1.6 côté rapports se distinguent.
Top Movers. limit_by_change filtre les lignes selon leur variation d'une période à l'autre, et limit_aggregation contrôle l'affichage des lignes exclues. Ce rapport ne conserve que les services dont le coût total dépasse 1 000 $ et a augmenté de 50 % ou plus :
resource "doit_report" "top_movers" { name = "Top Movers" description = "Services with significant month-over-month growth" config = { metrics = [{ type = "basic", value = "cost" }] aggregation = "total" data_source = "billing" time_interval = "month" dimensions = [{ id = "service_description", type = "fixed" }] time_range = { mode = "last" amount = 3 include_current = true unit = "month" } metric_filter = { metric = { type = "basic", value = "cost" } operator = "gt" values = [1000] operand = "series_total" } limit_by_change = { metric = { type = "basic", value = "cost" } change_type = "percentage" operator = "gte" values = [50] include_incomplete_data = false } limit_aggregation = "top" display_values = "actuals_only" layout = "table" currency = "USD" }}Prévisions et thèmes. forecast_settings projette les dépenses futures à partir des données historiques, et les layouts de la v1.8 (column_and_line_chart, sankey_chart, trend_board et cumulative_comparison) vous offrent plus de façons de les présenter. Ajoutez display_settings.theme_id et le rapport adopte les couleurs de votre marque :
resource "doit_custom_theme" "brand" {  name          = "Brand"  primary_color = "#1A73E8"  colors = {    light = ["#1A73E8", "#34A853", "#FBBC04", "#EA4335", "#A142F4", "#24C1E0"]    dark  = ["#8AB4F8", "#81C995", "#FDD663", "#F28B82", "#C58AF9", "#78D9EC"]  }}
resource "doit_report" "forecast" {  name        = "Spend Forecast"  description = "Last 12 months of spend with a 3-month forecast"  config = {    metrics       = [{ type = "basic", value = "cost" }]    aggregation   = "total"    time_interval = "month"    currency      = "USD"    data_source   = "billing"    time_range = {      mode            = "last"      amount          = 12      unit            = "month"      include_current = true    }    dimensions = [      { id = "year", type = "datetime" },      { id = "month", type = "datetime" },    ]    forecast_settings = {      mode                      = "totals"      historical_time_intervals = 12      future_time_intervals     = 3    }    layout          = "column_and_line_chart"    display_values  = "actuals_only"    sort_dimensions = "a_to_z"    display_settings = {      theme_id     = doit_custom_theme.brand.id      number_scale = "thousands"    }  }}
Un bémol : les valeurs de prévision ne figurent pas encore dans les résultats ni les exports des rapports. Le thème, lui, est conservé de bout en bout, comme le montre la section suivante.
Les rapports quittent la console : export PDF et PNG
Vous pouvez désormais extraire un rapport de DoiT sous forme de fichier, sans que personne n'ouvre la console. Depuis la v1.10, doit_report_result et doit_report_query acceptent file_output = "pdf" ou "png" et renvoient une URL de téléchargement signée :
data "doit_report_result" "forecast_pdf" {  id          = doit_report.forecast.id  file_output = "pdf"
  lifecycle {    postcondition {      condition     = self.file_output_url != null      error_message = "PDF rendering failed. Try applying again."    }  }}
data "http" "forecast_pdf" {  url = data.doit_report_result.forecast_pdf.file_output_url}
resource "local_sensitive_file" "forecast_pdf" {  filename       = "${path.module}/spend-forecast.pdf"  content_base64 = data.http.forecast_pdf.response_body_base64}
Le PDF est un document soigné de plusieurs pages, avec le nom de votre organisation dans l'en-tête, et votre thème personnalisé est repris : comme le rapport de prévision ci-dessus définit display_settings.theme_id, le PDF est lui aussi rendu aux couleurs de votre marque.
Remplacez local_sensitive_file par un aws_s3_object (il accepte le même content_base64) et le PDF atterrit dans un bucket. Les exécutions de rapports passent par l'API d'exécution asynchrone de DoiT, donc les rapports volumineux peuvent prendre du temps : augmentez le timeout de lecture de la data source avec timeouts = { read = "30m" } si besoin.
Vous n'avez même pas besoin d'un rapport enregistré. doit_report_query rend tout aussi bien une requête ad hoc, ce qui est idéal pour un graphique dans un README, un commentaire de pull request ou une page de wiki :
data "doit_report_query" "top_services_png" { file_output = "png" config = { metrics = [{ type = "basic", value = "cost" }] aggregation = "total" time_interval = "month" currency = "USD" time_range = { mode = "last", amount = 3, unit = "month", include_current = false } dimensions = [ { id = "year", type = "datetime" }, { id = "month", type = "datetime" }, ] # Les 5 services les plus coûteux group = [{ id = "service_description" type = "fixed" limit = { value = 5, sort = "desc", metric = { type = "basic", value = "cost" } } }] layout = "stacked_column_chart" sort_dimensions = "a_to_z" }}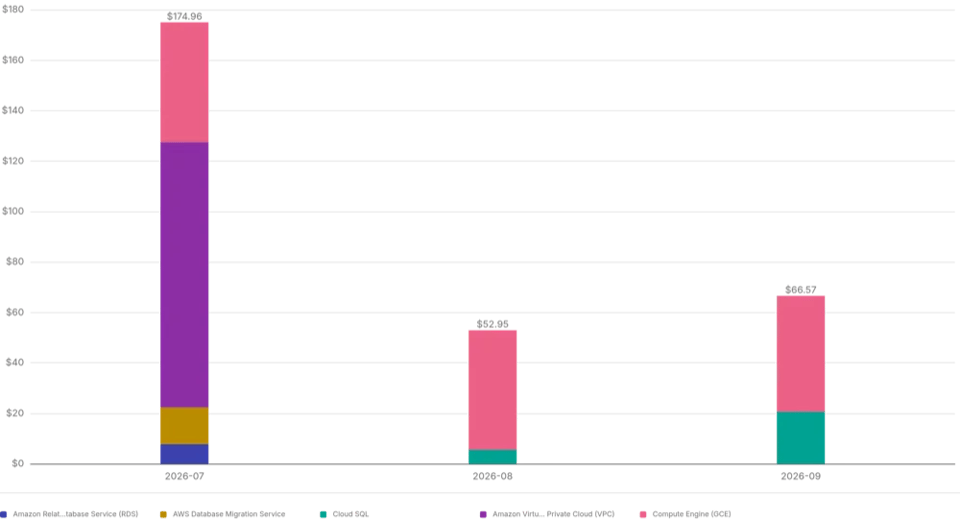
Astuce : définissez
sort_dimensions = "a_to_z"pour les exports. Sans cela, le graphique rendu ordonne l'axe temporel par valeur, et septembre peut se retrouver avant août. Avec, les mois suivent l'ordre du calendrier.
L'URL de téléchargement est sensible et valable jusqu'à sept jours. Chaque plan génère un nouveau fichier, exactement ce qu'il faut pour un rapport récurrent. Nous le mettrons à profit dans l'exemple final.
Votre tenant sous forme de code
Jusqu'ici, il n'a été question que de données de coûts. Mais l'une des fonctionnalités les plus adoptées du provider est l'onboarding AWS CloudConnect, via la ressource et le module du précédent billet. Les équipes veulent clairement leur configuration DoiT dans le code, pas seulement leurs rapports, et les trois dernières versions couvrent le reste du tenant.
Paramètres à l'échelle de l'organisation
doit_customer (v1.8) gère les paramètres au niveau de l'organisation. On ne crée pas un customer, on adopte celui qu'on a déjà : commencez donc par un import :
import {  to = doit_customer.main  id = "your-customer-id"}
resource "doit_customer" "main" {  url_slug = "my-company"
  settings = {    currency               = "USD"    allowed_invite_domains = ["mycompany.com"]    mfa_required           = true  }
  contact = {    emails = ["finops@mycompany.com"]  }}
Votre premier plan montre exactement en quoi les paramètres actuels diffèrent de ce que vous avez écrit — un audit utile en soi. Ensuite, désactiver la MFA ou autoriser un nouveau domaine d'invitation devient une pull request que quelqu'un doit approuver, et non plus un interrupteur que n'importe qui peut basculer.
Rôles personnalisés et utilisateurs
doit_role (v1.10) gère les rôles personnalisés. Les IDs de permissions sont opaques, ne les saisissez donc pas à la main : dérivez-les des rôles prédéfinis. Ce rôle combine deux rôles prédéfinis en un seul :
data "doit_roles" "all" {}
locals {  preset_permissions = {    for r in data.doit_roles.all.roles : r.name => r.permissions if r.type == "preset"  }}
resource "doit_role" "finops_analyst" {  name        = "FinOps Analyst"  description = "View Only plus everything a Finance User can see"  permissions = sort(distinct(concat(    local.preset_permissions["View Only"],    local.preset_permissions["Finance User"],  )))}
L'onboarding devient ensuite une map, exactement comme les équipes plus haut :
locals {  analysts = {    "ana@mycompany.com"  = { first_name = "Ana", last_name = "Lopez" }    "ravi@mycompany.com" = { first_name = "Ravi", last_name = "Patel" }  }}
resource "doit_user" "analyst" {  for_each = local.analysts
  email      = each.key  first_name = each.value.first_name  last_name  = each.value.last_name  job_title  = "Finance / Accounting"  role_id    = doit_role.finops_analyst.id}
Des configurations comme celle-ci nécessitent une identité disposant de droits suffisants pour gérer les utilisateurs. Depuis la v1.9, doit_current_user expose les permissions effectives de l'appelant : vous pouvez donc faire échouer l'exécution très tôt avec un message lisible, au lieu d'un 403 au beau milieu d'un apply :
data "doit_current_user" "me" { lifecycle { postcondition { condition = alltrue([for p in ["UsersManager", "ServiceAccountManager"] : contains(self.permissions, p)]) error_message = "The identity running Terraform needs the UsersManager and ServiceAccountManager permissions." } }}Service accounts et rotation des tokens
Les service accounts sont la fonctionnalité phare de la v1.10. Les pipelines qui dialoguent avec l'API DoiT tournent souvent avec la clé API personnelle de quelqu'un — et donc avec toutes les permissions de cette personne. Un service account donne à l'automatisation sa propre identité avec uniquement les permissions nécessaires, et doit_service_account et doit_service_account_token gèrent à la fois le compte et ses tokens dans Terraform.
Pilotez le nom et l'expiration du token avec une ressource time_rotating et Terraform émet un nouveau token dès que la date de rotation est passée :
resource "doit_service_account" "ci" {  name        = "ci-pipeline"  description = "Runs Terraform from CI"  permissions = ["cloudAnalyticsUser", "budgetsReadOnly"]}
resource "time_rotating" "ci_token" {  rotation_days = 90}
resource "doit_service_account_token" "ci" {  service_account_id = doit_service_account.ci.id  name               = "ci-${formatdate("YYYYMMDD-hhmmss", time_rotating.ci_token.rfc3339)}"  expires_time       = timeadd(time_rotating.ci_token.rotation_rfc3339, "168h")
  lifecycle {    create_before_destroy = true  }}
Quatre détails font fonctionner l'ensemble :
- Modifier
nameouexpires_timeremplace le token : c'est donc l'horodatage de rotation dans le nom qui déclenche l'émission d'un nouveau token. Cela garde aussi les noms uniques, condition indispensable pendant la brève coexistence de l'ancien et du nouveau token. create_before_destroygarantit que le nouveau token existe avant la suppression de l'ancien. Nous avons forcé une rotation pendant les tests : Terraform a créé le nouveau token, supprimé l'ancien, et le plan suivant était propre.- L'expiration dépasse la date de rotation d'une semaine, pour que le token continue de fonctionner même si personne ne lance l'apply suivant à temps.
access_tokenn'est renvoyé qu'une seule fois, à la création. Il est marqué comme sensible. Transmettez-le là où il est nécessaire dans le même apply.
Le token est un token API normal. Définissez-le comme DOIT_API_TOKEN et le provider (ou tout autre client de l'API DoiT) s'authentifie en tant que service account et ne voit que les permissions que vous lui avez accordées.
Astuce : un service account ne peut pas avoir plus de droits que son créateur. Demander des permissions que l'appelant ne détient pas échoue avec un 403. Notez aussi la convention de nommage : les permissions des service accounts utilisent le camelCase (
cloudAnalyticsUser), tandis quedoit_current_user.permissionsles rapporte en PascalCase (CloudAnalyticsUser).
Cloud bill shouldn't be a mystery
One platform for AI and Cloud optimization.
Autres nouveautés notables
Quelques ajouts supplémentaires qui méritent d'être connus :
doit_service_quotasaffiche l'utilisation des quotas AWS et GCP. Associez-le à un bloc check et chaque plan vous prévient avant d'atteindre une limite :
  check "service_quota_headroom" {    data "doit_service_quotas" "hot" {      min_utilization_percent = 80    }
    assert {      condition     = length(data.doit_service_quotas.hot.items) == 0      error_message = "Quotas at or above 80%: ${join(", ", [for q in data.doit_service_quotas.hot.items : "${q.cloud_provider}/${q.service}/${q.quota} (${q.utilization_percent}%)"])}"    }  }
Sur notre tenant de test, ce contrôle s'est déclenché immédiatement pour un quota AWS VPC à 80 %. Notez que la lecture des quotas nécessite la permission Manage Settings.
doit_billing_explainerdécompose une facture par payeur, y compris crédits, remises, économies et frais marketplace.doit_widget/doit_widgetsexposent les données des widgets des dashboards Cloud Analytics.doit_cloudconnect_supported_featuresindique quelles fonctionnalités et permissions sont actives sur chaque compte AWS connecté.- Les filtres
name_containssurdoit_alerts,doit_allocations,doit_budgets,doit_labelsetdoit_reportspermettent de retrouver tout ce qui appartient à l'équipe X en une seule ligne. - Les data sources PerfectScale for Commitments (
doit_ps4c_*) et la ressourcedoit_support_request_tagscomplètent ces versions.
Mise en pratique : un rapport FinOps hebdomadaire sans clé API humaine
Le dernier exemple combine un service account, un token en rotation, un bloc check, un export PDF et Ava, l'assistant IA de DoiT, dans un pipeline GitHub Actions. Il s'exécute chaque lundi et publie une synthèse FinOps avec le rapport complet en pièce jointe, à l'aide de deux petites configurations Terraform :
- Bootstrap, exécutée une seule fois par un admin : crée un service account aux permissions minimales, un token en rotation et le rapport, puis transmet le token et l'ID du rapport à GitHub. C'est le snippet de service account ci-dessus plus le rapport, avec deux ressources du provider GitHub à la fin :
  resource "github_actions_secret" "doit_api_token" {    repository      = "doit-finops-demo"    secret_name     = "DOIT_API_TOKEN"    plaintext_value = doit_service_account_token.reporting.access_token  }
  resource "github_actions_variable" "report_id" {    repository    = "doit-finops-demo"    variable_name = "DOIT_REPORT_ID"    value         = doit_report.weekly.id  }
Relancer le bootstrap après la date de rotation émet un nouveau token et met à jour le secret dans le même apply : le pipeline ne s'aperçoit de rien.
- Reporting, exécutée par le pipeline : un bloc check sur les budgets, l'export PDF vu plus haut et une question posée à Ava. Elle ne contient aucune ressource en dehors du fichier téléchargé, donc pas besoin d'état distant :
  data "doit_ava" "summary" {    question = "Summarize report ${var.report_id} in three short bullet points for an engineering audience. Mention the biggest week-over-week change."  }
  output "summary" {    value = <<-EOT      ## Weekly FinOps report
      ${data.doit_ava.summary.answer}
      _The full report is attached to this run as `weekly-cost-report`._    EOT  }
Le workflow lui-même est court :
name: Weekly FinOps report
on:  schedule:    - cron: "0 7 * * 1" # le lundi à 07:00 UTC  workflow_dispatch:
jobs:  report:    runs-on: ubuntu-latest    defaults:      run:        working-directory: reporting    env:      DOIT_API_TOKEN: ${{ secrets.DOIT_API_TOKEN }}      TF_VAR_report_id: ${{ vars.DOIT_REPORT_ID }}    steps:      - uses: actions/checkout@v7      - uses: hashicorp/setup-terraform@v4        with:          terraform_wrapper: false      - run: terraform init -input=false      - run: terraform apply -auto-approve -input=false      - run: terraform output -raw summary >> "$GITHUB_STEP_SUMMARY"      - uses: actions/upload-artifact@v7        with:          name: weekly-cost-report          path: reporting/weekly-cost-report.pdf
Voici une exécution réelle. Le bloc check a signalé un budget à risque dans le log, la synthèse d'Ava figure sur la page d'exécution, et le PDF est attaché en tant qu'artefact :
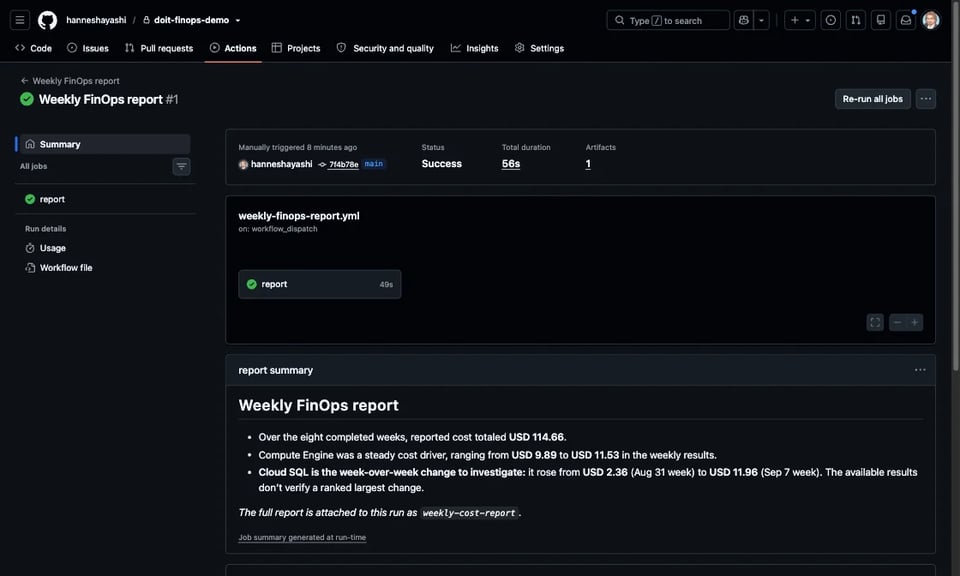
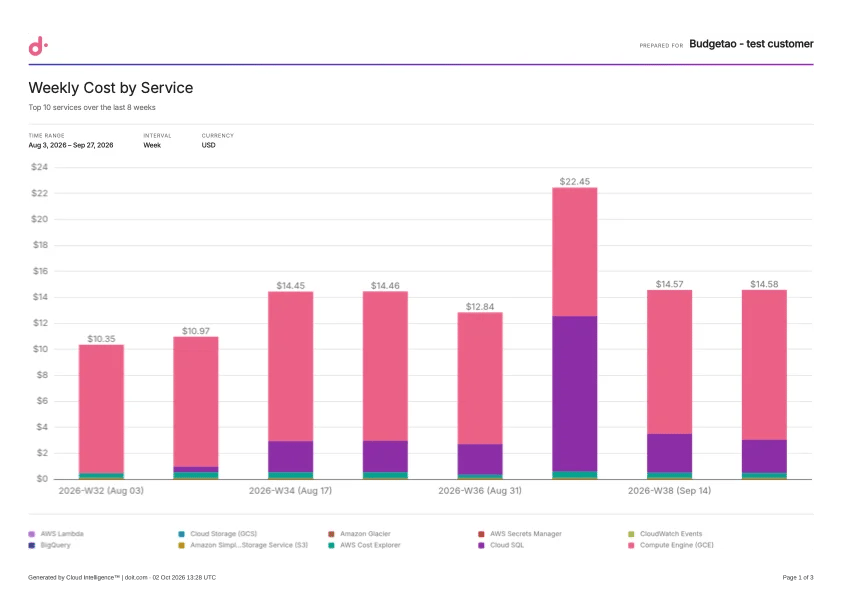
Regardez le troisième point de la synthèse d'Ava, puis le graphique : le bond de Cloud SQL dans la semaine du 7 septembre correspond exactement au pic violet de la semaine 37. La synthèse d'Ava est générée par IA, sa formulation change donc d'une exécution à l'autre, mais elle constitue un premier paragraphe utile pour un lundi matin.
Ce que nous avons appris en construisant tout cela :
- Gardez les permissions du robot au minimum. Le service account du pipeline n'a que deux permissions :
cloudAnalyticsUseretbudgetsReadOnly. C'est aussi pour cela que le contrôle des quotas reste hors de ce pipeline : il nécessiterait Manage Settings. - Le robot ne voit que les budgets publics. Les service accounts n'ont pas d'adresse e-mail, impossible donc d'en ajouter un comme collaborateur d'un budget. Les budgets que le pipeline doit contrôler nécessitent
public = "viewer"ou plus sur ledoit_budget. - Personne ne copie un token à la main. Le token passe de l'API DoiT directement au secret GitHub en un seul apply. La seule autre copie se trouve dans l'état Terraform du bootstrap : conservez cet état en lieu sûr.
Pour conclure
En résumé :
- Les ressources clés gagnent en profondeur : générez allocations, budgets et alertes depuis une seule map, construisez des allocations de groupe avec
selectet laissez les blocs check passer vos budgets en revue à chaque plan. - Les rapports quittent la console : rendez vos rapports enregistrés et vos requêtes ad hoc en PDF et PNG, à vos couleurs.
- Votre tenant est désormais du code : paramètres, rôles, utilisateurs et service accounts avec rotation de tokens, pour que vos pipelines n'empruntent plus la clé API d'une personne.
Pour aller plus loin :
- Passez à la v1.10 à l'aide du tableau en haut de ce billet.
- Commencez par la map d'équipes. Elle réunit allocations, budgets et alertes dans une seule configuration.
- Migrez vos pipelines des clés API personnelles vers un service account avec token en rotation.
- Surveillez les releases du dépôt (Watch → Custom → Releases). Le provider prend en charge tout ce qu'offre l'API DoiT : les nouvelles capacités de l'API y apparaissent au fur et à mesure de leur ajout.
Le provider est open source sur github.com/doitintl/terraform-provider-doit, et la documentation contient la plupart des exemples de ce billet, et bien d'autres encore. S'il manque quelque chose ou si un point vous semble maladroit, ouvrez une issue et dites-le-nous.


